

Heutige KI und die zukünftige KI
Wenn man die KI-Industriekette in Upstream-Ausrüstung, Midstream-Cloud-Anbieter und Unternehmen für große Sprachmodelle unterteilt, dann gehören die nachgelagerten Anwendungsunternehmen dazu. Derzeit konzentrieren sich die Gewinne der gesamten Kette fast vollständig auf den Upstream: Allein $Nvidia (NVDA.US)$ plus vier große Speicherhersteller nehmen zusammen fast 70% der Branchengewinne auf.
Diese Art der Gewinnverteilung zeigt typische Merkmale einer frühen Phase der Entwicklung einer neuen Technologierevolution. Aber lass uns überlegen: Werden die zukünftigen KI-Einstiegs- bzw. Abrechnungsportale nicht entweder bei den Cloud-Anbietern oder in den nachgelagerten Anwendungen liegen? Wird es bei der Gewinnverteilung dann immer noch so sein?
Als Beispiel für eine ausgereifte Internetindustrie beträgt der ungefähr folgende Anteil der wirtschaftlichen Gewinne:
Upstream: Geräte/Technologie (ca. 20%–30%)
Netzwerk/Cloud/Carrier (Midstream): ca. 10%–20%
Downstream-Plattformen und Anwendungen: ca. 50%–70%
Ganz offensichtlich gilt: Je näher man am Nutzer-Entry-Point ist, desto höher ist die Gewinnverteilung.
Die hohen Capex-Ausgaben der Cloud-Anbieter in den letzten Jahren sind im Kern eine Vorverlagerung eines Teils der künftigen Cloud-Anbieter-Gewinne auf heute – hin zu den Gewinnen der Upstream-Hardwareunternehmen. Und die zukünftigen Einnahmen der KI-Industrie werden hauptsächlich in den Downstream zu Anwendungen und Cloud-Anbietern fließen.
Mit dem verlangsamten Wachstum der Capex-Ausgaben und mit dem eigenen Wachstum der KI-Einnahmen wird die Gewinnverteilung in der gesamten Wertschöpfungskette immer stärker in Richtung einer reiferen Internetindustrie tendieren: zunehmend konzentriert sich alles auf den Midstream-Cloud-„Vorfabrikanten“ und den Downstream-Anwendungen.
Aktuell beträgt die gesamte Marktkapitalisierung der US-AI-Industriekette ungefähr 25 Billionen US-Dollar. Davon entfallen auf den Upstream (u. a. Compute-Chips, Halbleiterausrüstung, Storage, Kommunikationsgeräte) 47%, auf den Midstream die Cloud-Anbieter 50% und auf den Downstream die Anwendungen nur 3% – hier ist noch riesiger Spielraum.
Wenn du in KI dieses Jahres investierst, dann solltest du natürlich weiter in Compute investieren. Wenn du aber in die Zukunft von KI investierst, dann ist es ohne Zweifel sinnvoll, stärker auf Anwendungen im Downstream zu fokussieren. In den vergangenen drei Jahren gab es im Upstream unzählige Aktien mit dem Faktor Zehn und mehr. Doch mit dem Ende der Capex-Hochphase bleiben die Gewinnverteilungen stärker im Mittel- und Downstream. Damit steigt die Wahrscheinlichkeit, dass sich wieder Aktien mit dem Faktor Zehn finden lassen.
Früher hatte ich immer das Gefühl, dass die Unsicherheit bei KI-Anwendungen zu groß sei. Tatsächlich ist das aber vor allem, weil die einheimische KI-Umsatzskala im Inland noch zu klein ist. In den USA ist es anders: KI-Anwendungen haben bereits mehrere klar erkennbare Pfade, und es gibt eine Reihe von Unternehmen mit hohem Investitionswert. Dieser Text nimmt daher als Beispiel börsennotierte US-AI-Anwendungsunternehmen und ordnet einige wichtige Richtungen.
Compute: Konjunktur/„Sichtbarkeit“ für Nachfrage; Anwendungen: Geschäftsmodell
KI-Anwendungen sind kein homogenes Segment. 2026 kommt es intern zu einer extrem starken Differenzierung: Infrastruktursoftware, die durch KI-Arbeitslasten getrieben wird (einschließlich Datenplattformen, Observability, Sicherheit), läuft deutlich besser. „In Infrastruktursoftware long gehen und SaaS-Exposures begrenzen“ ist aktuell die Konsensstrategie für Software-Investments an der US-Börse.
Aber nicht alle SaaS-Software lassen sich nach unten mit Bewertungskürzungen „töten“. Laut Zwischenbericht: Viele Software-Aktien sehen, dass ihre KI-Einnahmen schnell wachsen – gleichzeitig gibt es auch viele Bewertungsniveaus, die sehr hoch sind, bei Software-Infrastrukturunternehmen.
Compute: Konjunktur/„Sichtbarkeit“; Anwendungen: Geschäftsmodell. Es gibt drei Schlüsselvariablen, um die Vor- und Nachteile einzelner Nischen-Subsegmente zu beurteilen:
1. Preismodell: nutzungs-/verbrauchsbasiertes Pricing ist natürlich positiv mit KI-Arbeitslasten verknüpft. Das kann Risiken durch weniger Sitzplätze abfedern, während ein reines Sitzplatzmodell stärker unter Druck steht;
2. Position in der Unternehmens-KI-Ausführungskette: Plattformen, die über Kern-Daten, Berechtigungen und Workflow-Eingänge verfügen, dürften von der Neubewertung als Anwendungssoftware hin zu Unternehmens-KI-Infrastruktur profitieren;
3. Sind die KI-Einnahmen „inkrementell“: Der Markt zahlt nur für nachverfolgbare KI-ARR/ACV/Arbeitslastmetriken – nicht für eine KI-Strategie.
Ausgehend von diesen drei Kriterien lassen sich KI-Anwendungen in drei Ebenen mit insgesamt sieben Bereichen unterteilen.
Erste Kategorie: Datenplattform
Nehmen wir an, es gibt heute ein großes E-Commerce-Unternehmen, das „AII in AI“ beschließt. Dann stellt man künftig möglichst wenige neue Mitarbeitende ein und lässt die KI-Agenten dieses Unternehmen selbst betreiben.
Das lässt sich nicht einfach nur mit ein paar Agenten-Eingängen lösen. Der erste Schritt, den alle Unternehmen machen müssen: ein KI-Daten-Platform aufbauen. Wenn KI Entscheidungen trifft und ausführt, muss sie zuerst wissen, was in der Vergangenheit passiert ist und was gerade passiert.
Früher waren die Mitarbeiter die Ausführenden der Unternehmensprozesse. Daher sind Daten in vielen Bereichen verteilt: Nutzerdaten in CRM, Bestelldaten in E-Commerce-Datenbanken, Bestands- und Finanzdaten in ERP, Kundenservice-Aufzeichnungen im Kundendienstsystem, Produktinfos im PIM, Werbedaten in Meta und Google, Mitarbeiterdaten im HR-System, Meeting-Protokolle auf den jeweiligen Rechnern und in den E-Mails der Mitarbeitenden – und natürlich gibt es noch mehr Daten in den Köpfen der Mitarbeitenden bzw. in Chat-Logs (wenn es sich um chinesische Unternehmen handelt)…
Beim Ausführen dann: Mitarbeitende holen die Daten aus unterschiedlichen Quellen, suchen sie heraus und fassen sie zusammen. Wenn zum Beispiel der Chef fragt: „Warum sind die Gewinne in der Region Shanghai in den letzten drei Monaten gesunken?“, kannst du in verschiedene Systeme einloggen und schauen. Wenn du es nicht weißt, fragst du zuerst deine Kollegen – und erst dann kannst du analysieren.
Genauso gilt: Ein Agent, der wirklich funktioniert, muss gleichzeitig all diese Daten kennen. Ohne Daten ist KI nur ein sehr kluger ausgelagerter Mitarbeiter – aber sie weiß nicht, was im Unternehmen passiert.
Daher ist die erste Aufgabe der KI-Transformation: sämtliche Informationen des Unternehmens in Daten zu verwandeln, die KI verstehen, abfragen und abrufen kann – so viel wie möglich, also Datenmigration.
In Zukunft wird jede Projektbesprechung, jedes Gespräch zwischen Kollegen und sogar jede Chat-Nachricht der Mitarbeitenden synchron aufgezeichnet und digitalisiert, als Analyse- und Trainingsdaten und Korpus für KI. Nur so kann sichergestellt werden, dass die Entscheidungen der KI auf Echtzeitinformationen basieren, die den Betrieb des Unternehmens widerspiegeln.
In den USA machen $Snowflake (SNOW.US)$ und $MongoDB (MDB.US)$ die beste Arbeit. Natürlich gibt es auch ein Unternehmen, das nicht ganz typisch ist, aber bekannter: $Palantir (PLTR.US)$.
$Snowflake (SNOW.US)$: Von einem einzelnen Anbieter von Data-Warehouse-Services hin zu einer umfassenden KI-Data-Cloud-Plattform. Das Unternehmen bringt eine Reihe von nativen KI-Produkten wie Cortex Code und Snowflake Intelligence heraus. Dadurch wird die Datenmigration für Kunden vereinfacht, der Verbrauch der Kern-Data-Services wird katalysiert – und es entsteht ein starker Wachstumsschub.
Die Abrechnung solcher Unternehmen erfolgt nach Nutzung/Verbrauch. Die KI-Arbeitslast steht in natürlicher Korrelation dazu. Laut Zwischenbericht beschleunigt sich das Umsatzwachstum aus dem Produkt kontinuierlich über drei Quartale bis Q2 auf 37%. Das Unternehmen hebt die Guidance für das gesamte Jahr auf 6,07 Milliarden US-Dollar an ( +36% ). Das bestätigt, dass die „Wachstumsfliehkraft des KI-getriebenen Kernplattform-Verbrauchs“ in die Realisierungsphase eingetreten ist.
Allerdings ist auch die Bewertung solcher Unternehmen extrem hoch: SNOW liegt bei knapp 20x PS, die Marktkapitalisierung bei rund 120 Milliarden US-Dollar. Darin stecken höhere Erwartungen an die Zukunft. Marktzweifel bestehen darin, dass SNOW gleichzeitig mit Cloud-Giganten wie AWS, Microsoft und Google konkurriert und kooperiert.
Zweite Kategorie: Observability
Wenn die Geschäftsanteile dieser Firma immer mehr von KI übernommen werden, entdeckt das Unternehmen ein ernstes Problem: Man weiß nicht, was die KI genau gemacht hat. Lohnt sich der verbrauchte Token überhaupt? Welche Geschäftsbereiche kann man optimieren?
Früher hatte die Firma ein vollständiges System, um die Arbeit der Mitarbeitenden zu erfassen, zu bewerten und zu beurteilen – am typischsten ist KPI-Management. Auch wenn es viele negative Bewertungen gibt, kann es gewährleisten, dass ein Unternehmen mit zehntausenden Mitarbeitern nach Prozessen automatisch läuft. Aber KI-Arbeit ist eine „Black Box“. KI kann auch „arbeiten-aufpassen“ und „unnütze Arbeit“ machen. Zudem könnten sich die Arbeitsabläufe der KI völlig von denen der Menschen unterscheiden. Dann funktionieren traditionelle KPIs nicht mehr – und die menschlichen Mitarbeitenden müssen ständig sehen, was die KI tatsächlich tut.
Genau dieses Problem lösen Observability-Anwendungen. Es ist wie die „HR“ der KI: Kann man sehen, welche Tools ein KI-Agent aufruft? Welches API wird aufgerufen? Wie viele Token wurden verbraucht? Warum wurde diese Entscheidung getroffen? In welchem Schritt ist der Fehler passiert? Welcher Agent hat eine bessere Performance? Welcher Agent führte zu Verlusten?
Ein repräsentatives Unternehmen in diesem Bereich ist $Datadog (DDOG.US)$. Man kann damit nicht nur klassische APM-Aufgaben wie das Echtzeit-Monitoring von Leistungskennzahlen für Cloud-, Hybrid- oder On-Premise-Server, Container und Netzwerke übernehmen. Außerdem kann es Code-level Distributed Tracing bereitstellen, um Kunden zu helfen, Engpässe der Anwendung und Microservices tiefer zu verstehen. Zudem kann man riesige Mengen von Logdaten aus Systemen und Anwendungen sammeln, verarbeiten und analysieren – für Fehlersuche und Performance-Analysen.
Auch hier ist das Preismodell verbrauchs-/verbrauchsorientiert. DDOG Q2-Umsatz +36%, und das Unternehmen erreicht in vier Quartalen in Folge eine Beschleunigung des Wachstums. Zudem hebt es die Jahres-Performance-Guidance deutlich an. Allerdings ist auch diese Sparte sehr hoch bewertet, weshalb die Aktie sehr leicht von negativer Software-Narrative beeinflusst werden kann.
Dritte Kategorie: Cybersicherheit
IT-Sicherheit ist eine Kategorie, die es bereits im Zeitalter traditioneller Software gab, aber in der KI-Ära nimmt ihre Bedeutung stark zu. Denn KI-Angriffe betreffen nicht nur dein System – KI kann selbst als Hacker-Verlockung dienen.
KI ersetzt im Kern Mitarbeitende. Ihre Berechtigungen sind größer als die der meisten Angestellten. Sie kann nicht nur auf Datenbanken zugreifen und Daten ändern, sondern auch E-Mails versenden und sogar hochriskante Aktionen wie Geldtransfers ausführen – sogar direkt Code schreiben und Programme deployen. Das ist wie ein direkter Einbruch in das Gehirn der Mitarbeitenden: „Umwerben“ der Mitarbeitenden.
Da Agenten gleichzeitig über Denk-/Schlussfolgerungsfähigkeit, Datenzugriffs- und Handlungsfähigkeit verfügen, werden Berechtigungen, Identitäten, Auditing und Tool-Call-Kontrollen zu neuen Sicherheitsproblemen.
$Netzwerksicherheitskonzepte (LIST2570.US)$ – solche Unternehmen gibt es viele, deshalb keine Beispiele.
Sicherheit ist das wichtigste Thema in den drei Bereichen: vor allem wegen der starken Planbarkeit und zusätzlich wegen einer Zeitverzögerung zwischen Ausgaben für KI und Ausgaben für „Security AI“. Deshalb sind die Erwartungen an das Umsatzwachstum in der Zukunft besonders stark.
Diese drei Kategorien – Datenservices, Planbarkeit (Predictability) und Cybersicherheit – kann man zusammenfassend als digitale Infrastruktur für KI-Anwendungen bezeichnen. Sie sind das unverzichtbare Dreierpaket für alle Unternehmen, die künftig KI-Strategien umsetzen. Die Ausgaben sind teils im Voraus notwendig, aber auch dauerhaft. Deshalb brechen diese Bereiche in der Anwendung zuerst aus.
Aufgebaut auf diesen drei Arten digitaler Infrastruktur folgt die „Execution-Ebene“, also Anwendungen für die verschiedenen Arbeitsoberflächen im Unternehmen. Ich teile sie in zwei Kategorien: die einen sind verschiedene Workflow-/Agent-Plattformen, die anderen sind KI-Programmierung.
Vierte Kategorie: Workflow-/Agent-Plattform
Nachdem man Daten und Berechtigungen hat: Wie arbeitet der Agent dieses E-Commerce-Unternehmens eigentlich genau?
Heute gibt es zwei Arten von Lösungen: Die erste nutzt auf Basis der bestehenden Workflows KI-Agenten, kombiniert mit verschiedenen vorhandenen Branchensoftware, um die Arbeit zu erledigen – das nennt man „Workflow-/Agent-Plattform“.
Zum Beispiel: Dieses E-Commerce-Unternehmen bearbeitet Kunden-Retouren. Der traditionelle Prozess ist, dass der Kundenservice prüft, Bestellungen abfragt, Ursachen beurteilt, den Bestand überprüft, erstattet, Logistik bearbeitet, das Lager benachrichtigt usw. Jede einzelne Stufe wird von Menschen bedient.
Im „Workflow-/Agent-Plattform“-Modus bleiben die Abläufe die gleichen. Der Unterschied ist: Spezialisierte Customer Agents erledigen die Verarbeitung automatisch.
In diesem Modell ist es neben dem Large Model selbst am wichtigsten, wie man Tool-Aufrufe, Berechtigungen und manuelle Freigaben sinnvoll in den ursprünglichen Arbeitsablauf einbettet. Die Herausforderung liegt in der Zusammenarbeit zwischen Mitarbeitenden und Agenten.
Daher sind solche Anwendungsunternehmen in der Regel Softwareanbieter, die sich transformieren – zum Beispiel $Salesforce (CRM.US)$, $ServiceNow (NOW.US)$, $Microsoft (MSFT.US)$ usw. Das Preismodell folgt ebenfalls einem doppelten Muster: „Sitzplätze + Token-Bepreisung“.
Aber dadurch werden auch solche Nicht-„Native AI“-Anbieter stark hinterfragt – vor allem aus zwei Gründen: Erstens: Wächst ihr Geschäft wirklich durch KI oder durch Nicht-KI? Zweitens das Preismodell: Kann der zusätzliche Umsatz durch neu berechneten Traffic den Rückgang bei den traditionellen Seat-Gebühren auffangen?
Unternehmen mit besonders aktiver Transformation, zum Beispiel $ServiceNow (NOW.US)$: Es positioniert seine Plattform inzwischen sogar als Unternehmens-KI-Infrastruktur, die Daten, Workflows und KI-Agenten verbindet. Ihre Plattform kann externe Daten verbinden – unter anderem $SAP SE (SAP.US)$, $Salesforce (CRM.US)$, sowie $Snowflake (SNOW.US)$, Databricks usw.
Wenn „Workflow-/Agent-Plattform“ das Muster für KI-gesteuerte traditionelle Software ist, dann ist „KI-Programmierung“ das Erstellen eines Programms, um die Arbeit jetzt zu erledigen.
Fünfte Kategorie: KI-Programmierung
Das ist im Grunde der B2B-Anwendungsfall, der bei den Large Models als Erstes wirklich durchlief – und der Anfang der ARR-Explosion in der ersten Jahreshälfte auslöste.
KI-Agenten sollen in der Theorie bestehende Software ansteuern. In der Praxis haben jedoch viele Softwarepakete keine Schnittstellen. Gerade aber das ist etwas, was Large Models besonders gut können: Programme schreiben. Wenn man auf solche Probleme stößt, ist es oft besser, selbst ein Programm zu schreiben, das die Lösung liefert. So entwickelt sich ein Large Model von Code-Completion hin zu dialogorientiertem Programmieren – und schließlich zu Programmieragenten.
Zu dieser Kategorie gehören sowohl GitHub Copilot als auch Cursor – ebenso wie vom Large-Model-Labor entwickelte Produkte wie Claude Code, Codex usw.
Ich neige dazu, KI-Programmierung klar von der Funktionalität traditioneller Software und von KI-Large-Models zu unterscheiden. Wenn man Unternehmen wirklich mit KI umbauen will, muss man vollständig aus dem ursprünglichen Workflow ausbrechen, eigene „Produktionswerkzeuge“ herstellen und die Grenze zwischen Arbeitenden und Produktionswerkzeugen aufheben. Nur so lässt sich die Effizienz wirklich steigern – und nur so können Unternehmen wie Anthropic mit einer Marktbewertung im Billionenbereich entstehen.
Diese Art Software ist bereits vollständig von Sitzplatzgebühren auf Token-Pricing umgestiegen. Sie greift direkt in die Anwendungsebene ein und konkurriert positiv mit der vorherigen „Workflow-/Agent-Plattform“. Welche KI-Arbeitsmethode künftig zum Mainstream wird, könnte genau hier entstehen – und daraus könnten Unternehmen mit dem Faktor Zehn hervorgehen.
Sechste Kategorie: Vertikale Branchen & Werbe-KI
Die ersten fünf Kategorien von KI-Anwendungen sind Infrastruktur und Produktionswerkzeuge in generischen Arbeitsumgebungen. Die sechste Kategorie zielt auf spezifische Geschäftsszenarien. Generische Large Models können die Compliance- und Genauigkeitsanforderungen in diesen Branchen oft nicht vollständig erfüllen – daher haben vertikale Softwareunternehmen tiefere Burggräben.
Diese Art von „KI-Anwendungen“ steht tatsächlich auf den ersten fünf Ebenen auf. Die derzeit reifste Anwendung ist die Werbe-KI von $Meta Platforms (META.US)$ / $Google-A (GOOGL.US)$ / $Applovin (APP.US)$.
Werbung ist der früheste marktfähige kommerzielle Anwendungsfall für KI. KI treibt das eCPM/ROAS nach oben, indem sie die Verweildauer der Nutzer, die zielgerichtete Conversion-Rate und die kreativen CTRs verbessert.
Meta FY26Q1: Werbeeinnahmen +33%. Das Unternehmen behauptet: Impressionen +19%, Preis pro Einheit +12% – und schreibt das der KI zu. Noch überzeugender ist jedoch Google: FY26Q1 Suchumsatz +19%, Abfragen auf einem neuen Rekordniveau. Damit wird die Wahrnehmung widerlegt, dass KI-Suche die Werbe-Widerstandsfähigkeit schwächt.
Wenn man in solche Anwendungsunternehmen investiert, ist das Schwierigste, die Echtheit der Geschäftstreiber durch KI zu erkennen. Viele KI-Anwendungen mit Fokus auf Werbeeinnahmen haben nur einen kleinen Anteil KI-getriebener Einnahmen – dafür aber das Risiko, von KI selbst verdrängt zu werden. Dagegen sind native KI-Werbeanwendungen wie AppLovin: Fast jeder Dollar Umsatz stammt aus KI-getriebener Werbung. Selbst wenn die Bewertung hoch ist, könnte das tatsächliche Wachstumspotenzial dennoch unterschätzt sein.
Neben Werbung gibt es auch schnellere Fortschritte bei KI-Anwendungen in vertikalen Branchen wie Pharma, Steuer-/Finanzwesen, Bildung, Design usw. Diese Branchen lassen ROI häufig gut quantifizieren, und die Bereitschaft, für KI zu zahlen, ist stark. Für Investitionen eignet sich jedoch eher die Perspektive, die diese jeweiligen vertikalen Branchen analysiert.
Die Verdrängten: SaaS und IT-Services
E-Commerce-Unternehmen „All in AI“: Früher musste man pro Jahr mehrere Millionen in die Anschaffung von großer Software investieren, weil für jeden Mitarbeiter Seats für oft genutzte Software bereitgestellt werden mussten. Aber seit KI da ist: Wenn jedem Mitarbeiter eine Vielzahl von Agenten bereitgestellt wird, stellt man fest, dass man eigentlich nicht so viele benötigen würde.
Das ist „Model frisst Software“: Nicht nur ein Narrativ, sondern etwas, das in der Softwarebranche real passiert. Large Models können die SaaS-Funktionen schneller und günstiger kopieren und gleichzeitig durch den Ersatz von Mitarbeitenden die Anzahl der Seats reduzieren. Gartner schätzt, dass bis 2030 mindestens 40% der Unternehmensausgaben für SaaS auf die Abrechnung nach Nutzung/Agent/Resultat umgestellt werden, während der Anteil der Seat-basierten Einnahmen auf unter ein Fünftel fällt. Diese vorausschauende Neubepreisung drückt zuerst die Bewertung, ohne dass sich die Profitabilität der Software-Aktien schon stärker verschlechtert. Intuit, Adobe und Workday gehören zu den drei schlechtesten Aktien im NASDAQ-100 im ersten Halbjahr 2026 – allesamt Software-Aktien.
Natürlich ist die Realität ab der zweiten Hälfte 2026 nicht mehr einfach „SaaS stirbt unbedingt“, sondern unterscheidet sich in KI-Transformierer und KI-Versäumende:
Unternehmen wie $Salesforce (CRM.US)$ machen aus KI-Agenten bereits eine neue Abrechnungs- bzw. nutzungsbasierte Einnahmequelle. Das ist vorerst sicher – daher ordne ich sie der vorderen vierten Kategorie „Workflow-/Agent-Plattform“ zu. Firmen wie Intuit, Adobe oder Workday hingegen: Ihre KI-Initiativen können kurzfristig kaum Wachstumsschübe auslösen. Daher liste ich sie vorerst zusätzlich zu den sechs Kategorien als Kandidaten für „die Verdrängten“.
Gefährlicher als SaaS ist die IT-Service-Branche – das ist der Bereich, der gerade verdrängt wird.
Früher musste dieses E-Commerce-Unternehmen jedes Jahr ein paar Millionen für IT-Serviceunternehmen wie Accenture, IBM oder Infosys ausgeben – für Dinge wie Systemimplementierung, Softwareentwicklung, Datenmigration, ERP-Wartung und IT-Beratung.
Ganz offensichtlich gibt es bei der Ersetzung von Mitarbeitenden noch Bedenken. Aber diese Bedenken gibt es nicht, wenn es um die Ersetzung von IT-Outsourcing geht.
Accenture: Der Umsatz im FY2026 Q3 liegt unter den Erwartungen, und das Unternehmen senkt die Guidance für das Gesamtjahreswachstum. Die Aktie fällt am selben Tag um etwa 18%. Der tiefere Grund: Unternehmen kürzen deutlich Budgets für traditionelle Software-Upgrade- und System-Services, um AI-Compute-Hardware schneller einzukaufen. IBM ist mit einem ähnlichen Problem konfrontiert.
Eine Morgan-Stanley-Studie zum CIO (2Q26) zeigt: Die erwartete Wachstumsrate für das IT-Services-Budget 2026 liegt nur bei +1,8% und damit unter +2,1% im Jahr 2025. Selbst wenn das Gesamt-IT-Budget sich verbessert, zieht KI weiterhin das frei verfügbare Budget ab.
Wenn man sagt, dass das Problem von SaaS-Unternehmen darin besteht, dass Software selbst von Agents neu definiert werden kann, dann ist das Problem der IT-Services: Die Rolle des Menschen könnte durch Agents ersetzt werden. Letzteres ist offensichtlich ein noch größeres Problem.
Natürlich haben auch diese IT-Service-Unternehmen neue Geschäfte. Kunden könnten Schwierigkeiten bei der KI-ROI haben. Wie beim Cloud-Migration-Umstieg entsteht dadurch ein neuer Bedarf an KI-Services – es hängt nur davon ab, ob man den Rückgang im bisherigen Geschäft ersetzen kann.
Zusammenfassung
Man kann sagen, dass die traditionelle Softwarebranche die erste Branche war, die von KI derart durcheinandergewirbelt wurde – 7:0:0 oder eben komplett auf den Kopf gestellt. Gleichzeitig war es auch die erste Branche, in der KI-native Anwendungen florierten. Zuerst hat der Markt Softwareunternehmen in KI und Nicht-KI eingeteilt. Heute ist die Einteilung: Gewinner, Verlierer und Unternehmen, deren Position noch nicht klar ist. Die meisten sind „unklar positioniert“.
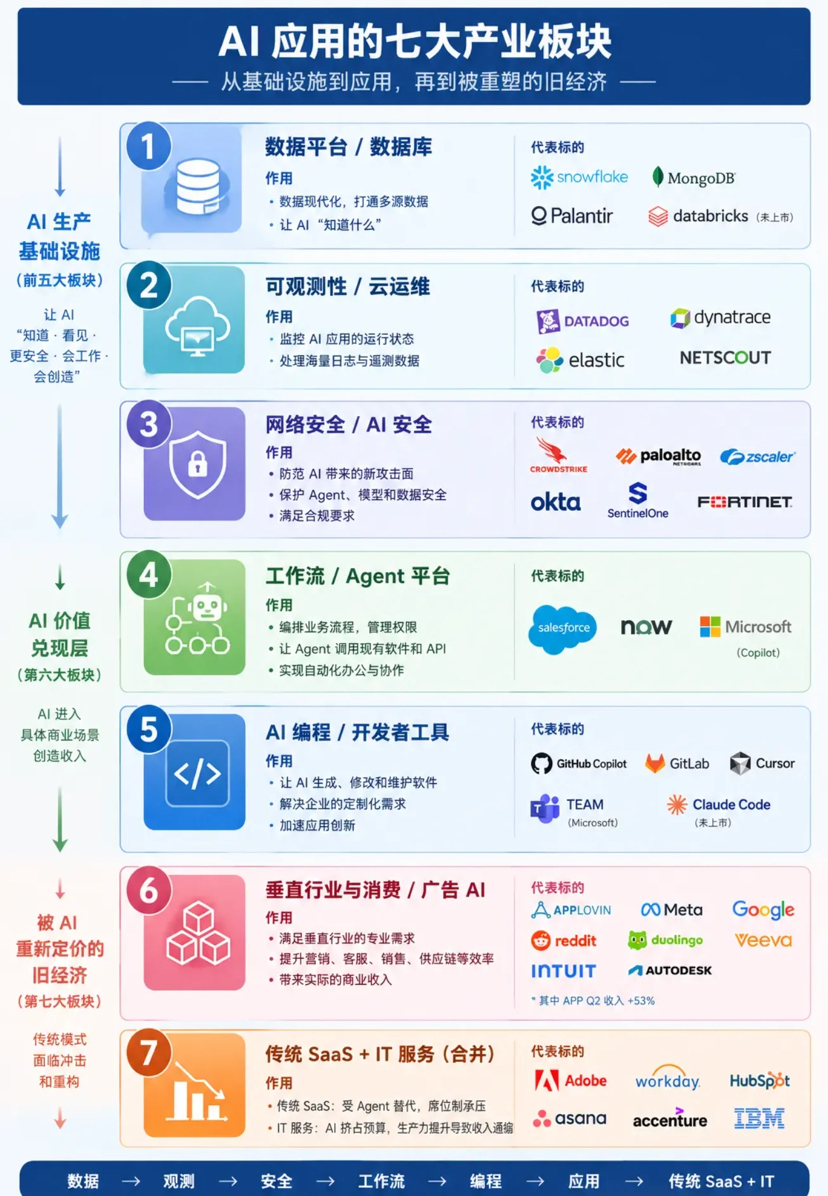
Diese sieben Kategorien von Anwendungen: Die ersten drei gehören zu den „Gewinnern“ – Datenservices, Predictability-Services und Cybersicherheit. Ihr Merkmal ist der hohe Bedarf (zwingende Notwendigkeit). Je stärker KI sich verbreitet, desto komplexer werden die Systeme – und desto mehr steigt der Bedarf.
Viertens und Fünftens: Workflow-/Agent-Plattform und KI-Programmierung. Beide haben derzeit noch „ungeklärten Status“. Aber je weiter KI verbreitet wird, desto größer ist ihre Rolle – sogar könnten sie zu einem neuen Unternehmensbetriebssystem werden und die Geschäftsmodelle der Softwarebranche grundlegend verändern.
Sechste Kategorie: Vertikale Anwendungen – extrem stark differenziert. Man muss sie einzeln prüfen: Welche sind wirklich KI-getrieben, welche sind nur mit Konzepten verpackte Schein-KI?
Zum Schluss: Diese Kategorie wird gerade „umgestürzt“. Was man heute sieht, sind die „Verlierer“ – je weiter KI sich verbreitet, desto gefährlicher werden alte Geschäftsmodelle. Aber ganz ohne Chance ist es auch nicht.
KI-gesteuerte Softwareanwendungen sind längst keine eigene Branche mehr. Gerade so native Anwendungen wie Programmierung sind eine vollständige Umwälzung der bisherigen Produktionsweise im Unternehmen. Zukünftige Software-Bewertungsrahmen sollten sich nicht nur auf Umsatzwachstum und Margen stützen, sondern auch auf KI-Aufrufvolumen, Task-Ausführungsvolumen, Durchdringungsgrad automatisierter Prozesse, den Grad an Abhängigkeit von Agenten und den Fortschritt der Migration der Preisarchitektur achten.
