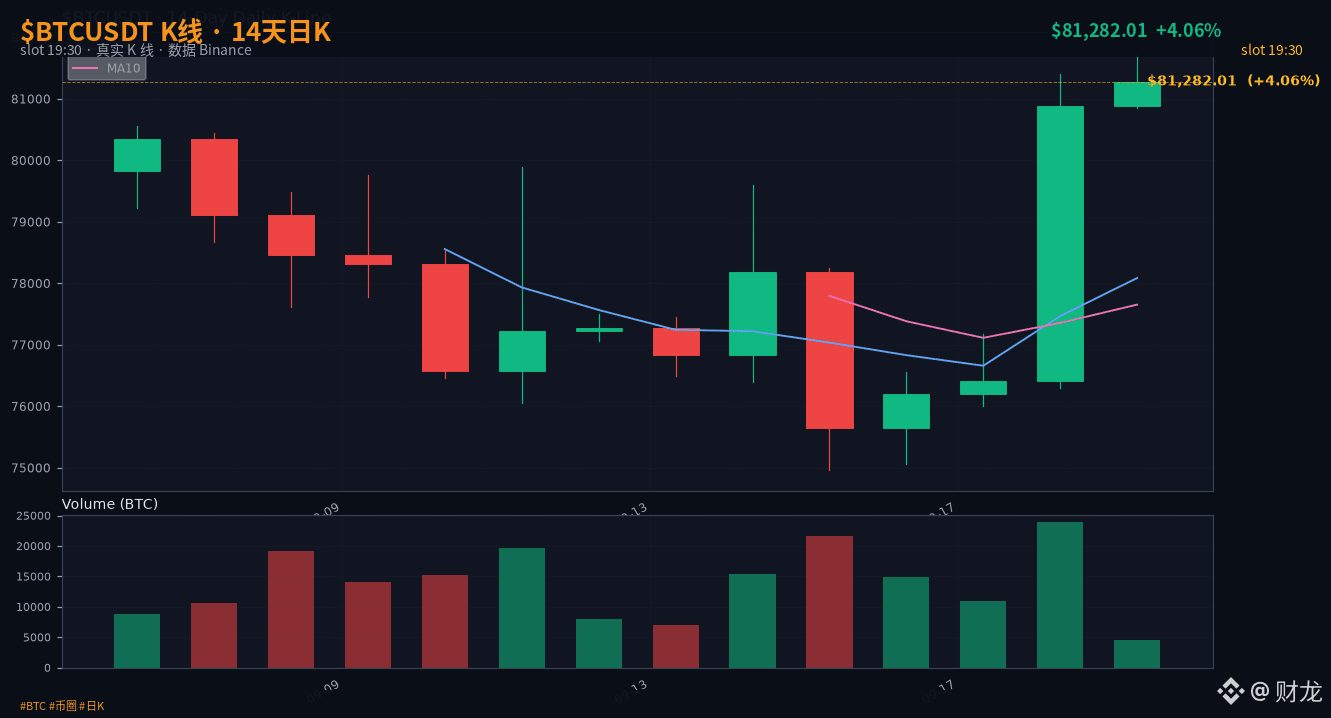

$BTC Berichten Sie 7,9 Wan – eine der wichtigsten ersten Reihe. Heute hat sich der Spitzenplatz der Modell-Paper-Rangliste geändert: Ein Trainingsseit-Entwurf hat die Führung übernommen – 26 Stimmen für RetireOPD. Es steckt „Self-Retirement Distillation“ in das agentenbasierte Reinforcement Learning. Der Kern: Alte Strategien sollen aktiv Platz machen, neue Strategien lernen direkt weiter mit den gewichteten alten Daten. Im Vergleich zur traditionellen „Distillation nach dem Alles-oder-Nichts“-Übernahme ist diese Retirement-Mechanik näher an den realen Szenarien von On-Chain-Agentenprotokollen: Knoten werden nicht unbegrenzt erweitert, sondern nach Beitragshäufigkeit rotierend ersetzt. $FET $TAO besteht aus drei Teilen – als Agenten-Index und Subnetz-Koordination. Die Agentenprotokoll-Linie auf der Solana-On-Chain geht in dieselbe Richtung. Wenn dieser neue Ansatz mit Self-Retirement durchläuft, gibt es bereits eine fertige Engineering-Basis für Mechanismen zur Knotenscore- und Gewicht-Übernahme. Die ganze Woche über türmten Modellpapiere Ausführungs-Tool-Aufrufe, heute sind wir endlich auf die Trainingsseite zurückgekehrt, um nach neuen Variablen zu suchen.
#代理训练新做法 #自退役蒸馏 #KI
#代理训练新做法 #自退役蒸馏 #KI