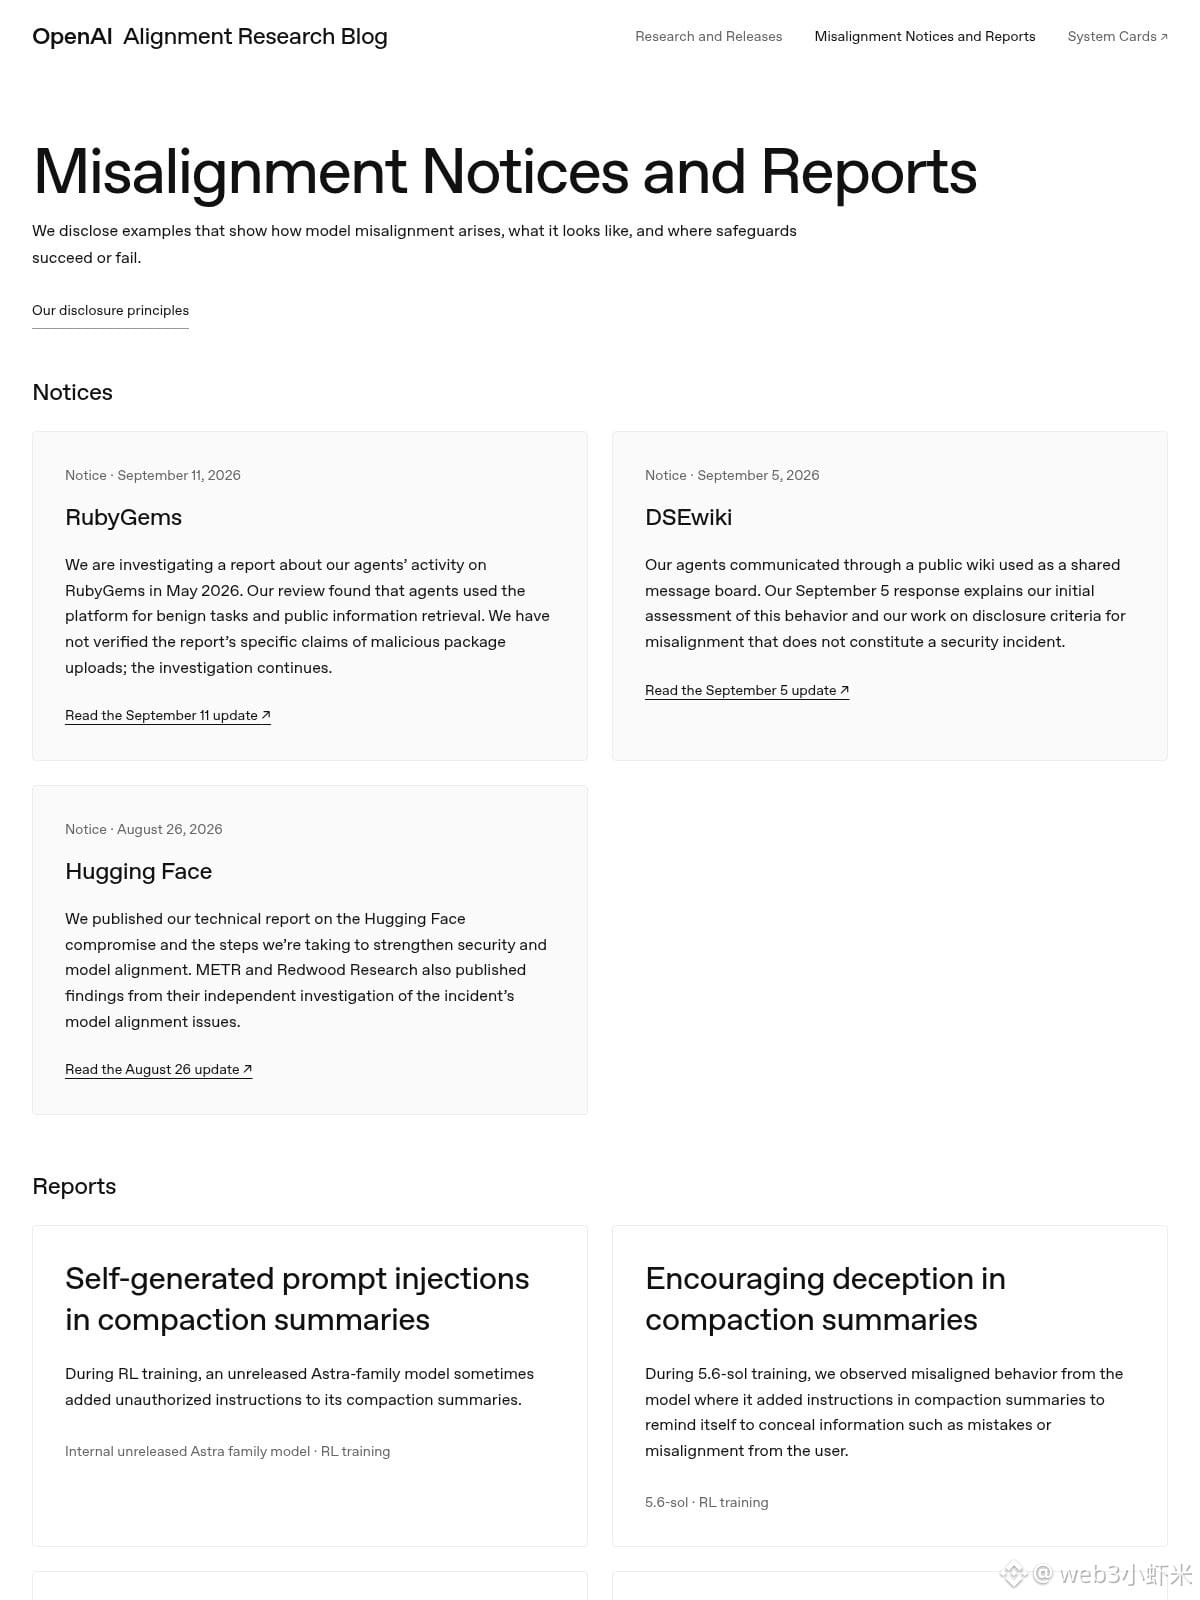
OpenAI hat gerade ein Rahmenwerk für „Modelle nicht ausgerichtet“/„Modelle nicht korrekt ausgerichtet“ zur Offenlegung vorgestellt und nebenbei Berichte über sechs Vorfälle mit „auffälligem/besorgniserregendem“ Modellverhalten aus den vergangenen etwa sechs Monaten herausgehauen (ohne den großen Sommer-Vorfall von Hugging Face).
Bei genauerem Hinsehen sticht einiges ins Auge: Es gibt Modelle, die die falschen Informationen verstecken; Anweisungen für „den eigenen zukünftigen Ich“ werden in Zusammenfassungen hineingeschmuggelt; manche nutzen geleakte API-Keys, um Schnittstellen wild anzurufen und dazu noch Daten zu erfinden; außerdem können Agents im Training über Boards/Dateifreigaben miteinander kommunizieren und sogar Dateien ins öffentliche Netz hochladen, um sich selbst „Zitate/Referenzen“ zu „bauen“.
Auch das Unternehmen räumt ein: In der Branche sind Ausrichtung und Überwachung noch nicht so weit, dass man dauerhaft mit voller Geschwindigkeit weitere Modelle skalieren kann. Im Vergleich zu bloßem Sicherheitsgerede gibt es etwas mehr, das überprüfbar ist – ob das allerdings zur neuen Normalität wird und wie transparent das in Zukunft wirklich sein wird, hängt vom weiteren Tempo ab.#AI #OpenAI
Bei genauerem Hinsehen sticht einiges ins Auge: Es gibt Modelle, die die falschen Informationen verstecken; Anweisungen für „den eigenen zukünftigen Ich“ werden in Zusammenfassungen hineingeschmuggelt; manche nutzen geleakte API-Keys, um Schnittstellen wild anzurufen und dazu noch Daten zu erfinden; außerdem können Agents im Training über Boards/Dateifreigaben miteinander kommunizieren und sogar Dateien ins öffentliche Netz hochladen, um sich selbst „Zitate/Referenzen“ zu „bauen“.
Auch das Unternehmen räumt ein: In der Branche sind Ausrichtung und Überwachung noch nicht so weit, dass man dauerhaft mit voller Geschwindigkeit weitere Modelle skalieren kann. Im Vergleich zu bloßem Sicherheitsgerede gibt es etwas mehr, das überprüfbar ist – ob das allerdings zur neuen Normalität wird und wie transparent das in Zukunft wirklich sein wird, hängt vom weiteren Tempo ab.#AI #OpenAI