Ich habe KGeN kürzlich neu verstanden: Vielleicht fehlt der KI gar nicht mehr Daten, sondern etwas anderes…
Nachdem ich mich mit KGeN beschäftigt habe, ist mein stärkster Eindruck: Je mehr Daten eine KI hat, desto wichtiger könnte es werden, ob die Daten wirklich von Menschen stammen.
Früher, wenn ich von KI-Projekten etwas über Daten hörte, blieb ich meist nicht lange dabei. Schließlich gibt es im Internet heute so ziemlich alles an Daten.
Doch genau hier liegt das Problem.
KI-generierte Artikel, Bilder und Audioinhalte nehmen immer weiter zu, und Roboter-Accounts werden immer häufiger. Wenn KI künftig massenhaft Inhalte lernt, die bereits von KI erzeugt wurden: Entsteht dann nicht ein Kreislauf?
KI generiert → KI lernt → erzeugt erneut → trainiert wieder KI.
Die Menge wird immer größer, aber echte menschliche Erfahrung könnte gleichzeitig immer weniger werden.
Das ist auch der Grund, warum ich mir KGeN jetzt ernsthaft genauer anschaue.
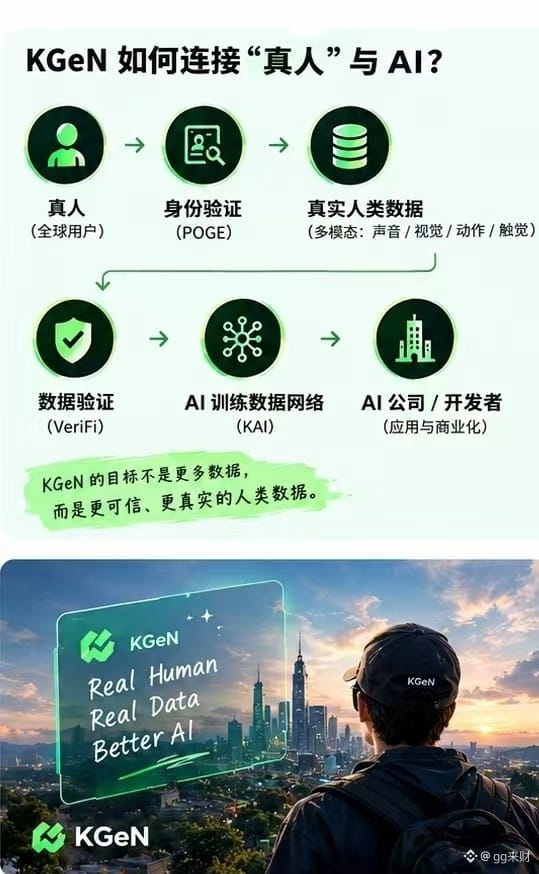
KGeN ordnet sich aktuell als „Verified Human Network“ ein. Der Kernfokus liegt auf der Beschaffung verifizierter realer menschlicher sowie multimodaler Daten – für Physical AI und LLM. Laut offiziellen Angaben umfassen die Datentypen unter anderem Stimme, Sicht, Handlungen und Tastsinn und decken über 60 Länder ab.
Ich finde, das Wichtigste hier ist nicht das angesagte Schlagwort „KI“, sondern vielmehr:
Wenn KI die reale Welt wirklich verstehen soll, muss sie dann nicht zuerst echte Menschen verstehen?
Zum Beispiel: Wenn ein Roboter lernen soll, in einer echten Umgebung zu leben, reicht es allein, sich Internetbilder anzusehen, bei weitem nicht aus.
Er muss wissen, wie Menschen sprechen, wie sie sich verhalten, wie sie die Umgebung beobachten – und sogar, wie Menschen in unterschiedlichen Szenarien reagieren.
Dann ist „echte Menschen-Daten“ nicht mehr nur eine Frage der Datenmenge, sondern eine Frage nach Datenursprung und Qualität.
KGeN verfolgt genau diese Idee: reale, verifizierte und multimodale Daten sowie den Trainingsbedarf der KI miteinander zu verbinden. Das Produktsystem umfasst außerdem K-Quest: mit verifizierten Menschen, die Aufgaben erledigen, um die multimodalen Daten zu sammeln, die Physical AI und LLM benötigen.
Natürlich möchte ich KGeN jetzt noch nicht als sicher erfolgreich bezeichnen.
Für mich ist vor allem Folgendes weiterhin zu beobachten:
Können echte Nutzer dauerhaft weiter zunehmen?
Kann auch langfristig ein Bedarf an Daten entstehen?
Können diese Daten wirklich von KI-Unternehmen genutzt werden?
Lässt sich am Ende ein langfristiger kommerzieller Kreislauf aufbauen?
Diese Fragen sind deutlich spannender als nur kurzfristige Preisvergleiche.
Auf diese Antwort werde ich weiterhin achten.
#KGen
Nachdem ich mich mit KGeN beschäftigt habe, ist mein stärkster Eindruck: Je mehr Daten eine KI hat, desto wichtiger könnte es werden, ob die Daten wirklich von Menschen stammen.
Früher, wenn ich von KI-Projekten etwas über Daten hörte, blieb ich meist nicht lange dabei. Schließlich gibt es im Internet heute so ziemlich alles an Daten.
Doch genau hier liegt das Problem.
KI-generierte Artikel, Bilder und Audioinhalte nehmen immer weiter zu, und Roboter-Accounts werden immer häufiger. Wenn KI künftig massenhaft Inhalte lernt, die bereits von KI erzeugt wurden: Entsteht dann nicht ein Kreislauf?
KI generiert → KI lernt → erzeugt erneut → trainiert wieder KI.
Die Menge wird immer größer, aber echte menschliche Erfahrung könnte gleichzeitig immer weniger werden.
Das ist auch der Grund, warum ich mir KGeN jetzt ernsthaft genauer anschaue.
KGeN ordnet sich aktuell als „Verified Human Network“ ein. Der Kernfokus liegt auf der Beschaffung verifizierter realer menschlicher sowie multimodaler Daten – für Physical AI und LLM. Laut offiziellen Angaben umfassen die Datentypen unter anderem Stimme, Sicht, Handlungen und Tastsinn und decken über 60 Länder ab.
Ich finde, das Wichtigste hier ist nicht das angesagte Schlagwort „KI“, sondern vielmehr:
Wenn KI die reale Welt wirklich verstehen soll, muss sie dann nicht zuerst echte Menschen verstehen?
Zum Beispiel: Wenn ein Roboter lernen soll, in einer echten Umgebung zu leben, reicht es allein, sich Internetbilder anzusehen, bei weitem nicht aus.
Er muss wissen, wie Menschen sprechen, wie sie sich verhalten, wie sie die Umgebung beobachten – und sogar, wie Menschen in unterschiedlichen Szenarien reagieren.
Dann ist „echte Menschen-Daten“ nicht mehr nur eine Frage der Datenmenge, sondern eine Frage nach Datenursprung und Qualität.
KGeN verfolgt genau diese Idee: reale, verifizierte und multimodale Daten sowie den Trainingsbedarf der KI miteinander zu verbinden. Das Produktsystem umfasst außerdem K-Quest: mit verifizierten Menschen, die Aufgaben erledigen, um die multimodalen Daten zu sammeln, die Physical AI und LLM benötigen.
Natürlich möchte ich KGeN jetzt noch nicht als sicher erfolgreich bezeichnen.
Für mich ist vor allem Folgendes weiterhin zu beobachten:
Können echte Nutzer dauerhaft weiter zunehmen?
Kann auch langfristig ein Bedarf an Daten entstehen?
Können diese Daten wirklich von KI-Unternehmen genutzt werden?
Lässt sich am Ende ein langfristiger kommerzieller Kreislauf aufbauen?
Diese Fragen sind deutlich spannender als nur kurzfristige Preisvergleiche.
Auf diese Antwort werde ich weiterhin achten.
#KGen