Neulich habe ich KGeN untersucht und da ist eine Veränderung ziemlich deutlich.
Früher, wenn ich so ein Projekt gesehen habe, habe ich zuerst geschaut:
den Kurs.
Jetzt frage ich zuerst:
Worin besteht eigentlich das Problem, das es löst?
Die Antwort von KGeN ist ziemlich einfach:
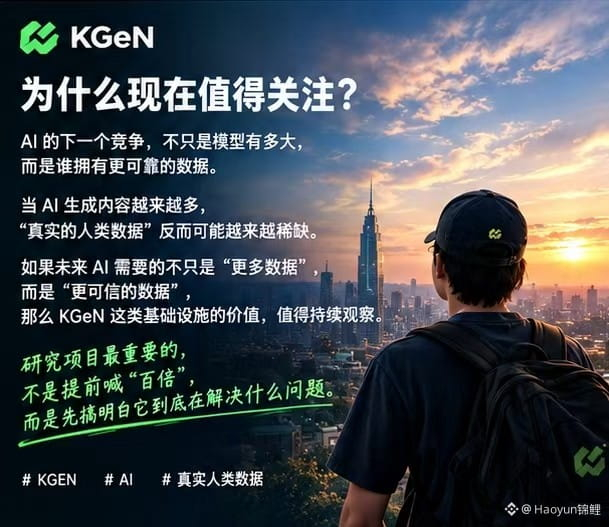
KI braucht Daten, aber in Zukunft braucht sie möglicherweise noch viel mehr „vertrauenswürdige menschliche Daten“.
Diese Logik ist eigentlich nicht schwer zu verstehen.
Angenommen, du lässt die KI mit 100 Millionen Datensätzen aus dem Internet lernen.
Das klingt nach sehr viel.
Aber wenn ein großer Teil der Inhalte selbst von Robotern generiert wurde, von KI generiert wurde, wiederholt ist, von geringer Qualität …
Dann hat die Menge auch bei noch so viel keinen wirklichen Wert.
Umgekehrt gilt: Wenn die Daten aus verschiedenen Ländern, in verschiedenen Sprachen und aus unterschiedlichen Lebensumgebungen stammen und dahinter tatsächlich verifizierte echte Menschen stehen, dann kann der Wert komplett anders sein.
Genau in diese Richtung geht KGeN jetzt.
Offiziell positioniert man das Netzwerk derzeit als „Verified Human Network“ und erweitert es weiter zu multimedialen Daten, „Physical AI“ und LLMs.
Ein Punkt, der mir persönlich an so einem Projekt gefällt, ist:
Es sagt dir zumindest nicht: „KI ist supersexy, also brauchen wir auch KI“.
Stattdessen geht man von einer konkreteren Frage aus:
Wenn KI immer stärker wird – wo findet man dann noch echte Menschen?
Ob diese Frage einen Wert hat, denke ich, muss man nicht vorschnell entscheiden.
Schau sich an, wie sich der künftige Datenbedarf entwickelt, wie die geschäftliche Zusammenarbeit aussieht und wie es in der Praxis wirklich genutzt wird – dann ergibt sich die Antwort von selbst.
Das Wichtigste bei Forschungsprojekten ist nicht, im Voraus „hundertmal besser“ zu rufen, sondern erst einmal herauszufinden, welches Problem es überhaupt löst.
Das ist auch mein größtes Gefühl, seitdem ich mir KGeN in letzter Zeit anschaue.
#KGEN 🟩
Früher, wenn ich so ein Projekt gesehen habe, habe ich zuerst geschaut:
den Kurs.
Jetzt frage ich zuerst:
Worin besteht eigentlich das Problem, das es löst?
Die Antwort von KGeN ist ziemlich einfach:
KI braucht Daten, aber in Zukunft braucht sie möglicherweise noch viel mehr „vertrauenswürdige menschliche Daten“.
Diese Logik ist eigentlich nicht schwer zu verstehen.
Angenommen, du lässt die KI mit 100 Millionen Datensätzen aus dem Internet lernen.
Das klingt nach sehr viel.
Aber wenn ein großer Teil der Inhalte selbst von Robotern generiert wurde, von KI generiert wurde, wiederholt ist, von geringer Qualität …
Dann hat die Menge auch bei noch so viel keinen wirklichen Wert.
Umgekehrt gilt: Wenn die Daten aus verschiedenen Ländern, in verschiedenen Sprachen und aus unterschiedlichen Lebensumgebungen stammen und dahinter tatsächlich verifizierte echte Menschen stehen, dann kann der Wert komplett anders sein.
Genau in diese Richtung geht KGeN jetzt.
Offiziell positioniert man das Netzwerk derzeit als „Verified Human Network“ und erweitert es weiter zu multimedialen Daten, „Physical AI“ und LLMs.
Ein Punkt, der mir persönlich an so einem Projekt gefällt, ist:
Es sagt dir zumindest nicht: „KI ist supersexy, also brauchen wir auch KI“.
Stattdessen geht man von einer konkreteren Frage aus:
Wenn KI immer stärker wird – wo findet man dann noch echte Menschen?
Ob diese Frage einen Wert hat, denke ich, muss man nicht vorschnell entscheiden.
Schau sich an, wie sich der künftige Datenbedarf entwickelt, wie die geschäftliche Zusammenarbeit aussieht und wie es in der Praxis wirklich genutzt wird – dann ergibt sich die Antwort von selbst.
Das Wichtigste bei Forschungsprojekten ist nicht, im Voraus „hundertmal besser“ zu rufen, sondern erst einmal herauszufinden, welches Problem es überhaupt löst.
Das ist auch mein größtes Gefühl, seitdem ich mir KGeN in letzter Zeit anschaue.
#KGEN 🟩