Ich habe KGeN das erste Mal wirklich aufmerksam angesehen, weil „Roboter“
Früher, als ich KGeN gesehen habe, war meine erste Reaktion eigentlich immer noch Web3.
Aber in letzter Zeit hat es den Fokus stärker auf Physical AI / Robotics verlagert. Diese Veränderung hat mich dazu gebracht, das Projekt wieder neu anzusehen.
Denn in diesem Moment bekam „Daten von echten Menschen“ plötzlich eine völlig andere Bedeutung.
Wenn es um einen Chatbot geht, reichen Textdaten vielleicht aus.
Aber bei Robotern ist das anders.
Ein Roboter muss wissen:
Wie geht ein Mensch?
Wie bewegt sich die Hand?
Wie fühlt sich etwas an, wenn man es anfasst?
Was macht ein Mensch in unterschiedlichen Umgebungen?
Stimmen, Sehen, Handlungen und sogar Tastsinn können alles Trainingsdaten werden.
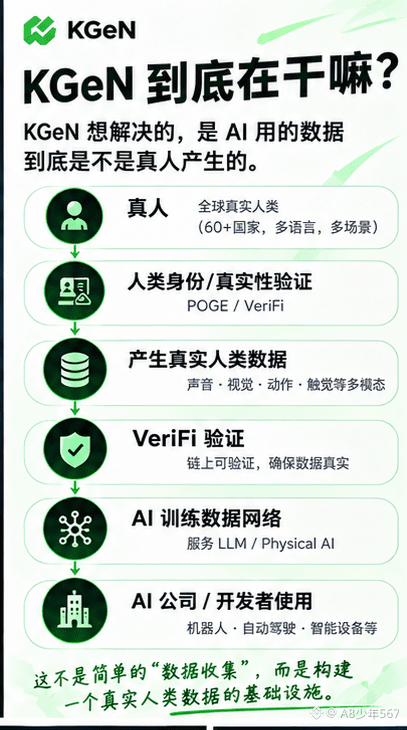
KGeN betont jetzt offiziell genau diese multimodalen, echten Menschendaten – einschließlich Sound, Sight, Motion und Touch – und nutzt diese Daten für Physical AI und LLM.
Ich finde hier einen sehr anschaulichen Unterschied:
Normale KI-Daten:
„Sag der KI, was Menschen sind.“
Physical-AI-Daten:
„Lass die KI wirklich verstehen, wie Menschen leben und sich verhalten.“
Diese beiden Aufgaben sind überhaupt nicht die gleiche Schwierigkeit.
Deshalb schaue ich mir KGeN jetzt nicht nur nach dem Preis von $KGEN an.
Vielmehr interessiert mich:
Können diese echten menschlichen Daten tatsächlich langfristige kommerzielle Nachfrage erzeugen?
Wenn die KI- und Robotikbranche wirklich immer mehr solche Daten braucht, dann könnte „Verified Human“ von einem Web3-Konzept nach und nach zu einem Teil der AI-Infrastruktur werden
#KGENUpdate #Aİ #KGEN
Früher, als ich KGeN gesehen habe, war meine erste Reaktion eigentlich immer noch Web3.
Aber in letzter Zeit hat es den Fokus stärker auf Physical AI / Robotics verlagert. Diese Veränderung hat mich dazu gebracht, das Projekt wieder neu anzusehen.
Denn in diesem Moment bekam „Daten von echten Menschen“ plötzlich eine völlig andere Bedeutung.
Wenn es um einen Chatbot geht, reichen Textdaten vielleicht aus.
Aber bei Robotern ist das anders.
Ein Roboter muss wissen:
Wie geht ein Mensch?
Wie bewegt sich die Hand?
Wie fühlt sich etwas an, wenn man es anfasst?
Was macht ein Mensch in unterschiedlichen Umgebungen?
Stimmen, Sehen, Handlungen und sogar Tastsinn können alles Trainingsdaten werden.
KGeN betont jetzt offiziell genau diese multimodalen, echten Menschendaten – einschließlich Sound, Sight, Motion und Touch – und nutzt diese Daten für Physical AI und LLM.
Ich finde hier einen sehr anschaulichen Unterschied:
Normale KI-Daten:
„Sag der KI, was Menschen sind.“
Physical-AI-Daten:
„Lass die KI wirklich verstehen, wie Menschen leben und sich verhalten.“
Diese beiden Aufgaben sind überhaupt nicht die gleiche Schwierigkeit.
Deshalb schaue ich mir KGeN jetzt nicht nur nach dem Preis von $KGEN an.
Vielmehr interessiert mich:
Können diese echten menschlichen Daten tatsächlich langfristige kommerzielle Nachfrage erzeugen?
Wenn die KI- und Robotikbranche wirklich immer mehr solche Daten braucht, dann könnte „Verified Human“ von einem Web3-Konzept nach und nach zu einem Teil der AI-Infrastruktur werden
#KGENUpdate #Aİ #KGEN