我以前真没觉得“真人数据”有多重要
以前看到 AI 项目讲数据,我基本都是扫一眼。
数据量多少、模型多大、合作了谁……看多了其实都差不多。
但最近看到 KGeN,我反而对一个很简单的问题比较感兴趣:
如果以后 AI 训练数据越来越多是 AI 生成的,那谁来证明这些数据最开始来自真人?
这其实挺有意思。
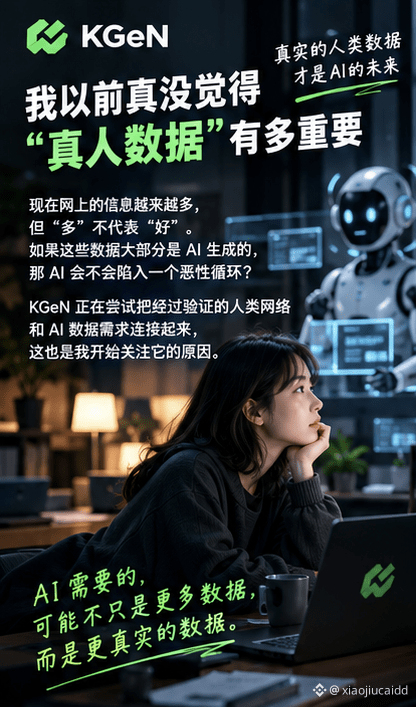
现在网上的信息越来越多,但“多”不代表“好”。
一篇文章可能是 AI 写的,一张图片可能是 AI 生成的,一段评论也可能是机器人批量产生的。
如果这些东西继续拿去训练下一代 AI,最后可能出现一个很奇怪的循环:
AI 生成数据 → AI 学习 → 再生成更多数据 → 再训练 AI。
数据越来越多,但真实的人类经验反而越来越稀缺。
这也是我最近开始关注 KGeN 的原因。
KGeN 的方向不是单纯再做一个“数据平台”,而是把经过验证的人类网络和 AI 数据需求连接起来。
官方目前强调的方向包括 Verified Human、Sound / Sight / Motion / Touch 等多模态数据,以及 Physical AI 和 LLM。
我觉得这个方向真正有意思的地方,不是“AI”两个字。
而是:
当 AI 越来越多以后,真人本身会不会反而成为一种稀缺资源?
这个问题,我觉得值得继续观察 KGeN。
#KGEN
以前看到 AI 项目讲数据,我基本都是扫一眼。
数据量多少、模型多大、合作了谁……看多了其实都差不多。
但最近看到 KGeN,我反而对一个很简单的问题比较感兴趣:
如果以后 AI 训练数据越来越多是 AI 生成的,那谁来证明这些数据最开始来自真人?
这其实挺有意思。
现在网上的信息越来越多,但“多”不代表“好”。
一篇文章可能是 AI 写的,一张图片可能是 AI 生成的,一段评论也可能是机器人批量产生的。
如果这些东西继续拿去训练下一代 AI,最后可能出现一个很奇怪的循环:
AI 生成数据 → AI 学习 → 再生成更多数据 → 再训练 AI。
数据越来越多,但真实的人类经验反而越来越稀缺。
这也是我最近开始关注 KGeN 的原因。
KGeN 的方向不是单纯再做一个“数据平台”,而是把经过验证的人类网络和 AI 数据需求连接起来。
官方目前强调的方向包括 Verified Human、Sound / Sight / Motion / Touch 等多模态数据,以及 Physical AI 和 LLM。
我觉得这个方向真正有意思的地方,不是“AI”两个字。
而是:
当 AI 越来越多以后,真人本身会不会反而成为一种稀缺资源?
这个问题,我觉得值得继续观察 KGeN。
#KGEN