

# Ich habe mit 17 parallelen Konten versucht, meine eigene Handelsstrategie zu widerlegen
---> Eine ernste Versuchsaufzeichnung über Prognosemärkte (Polymarket): von „am Rand suchen“ bis „den eigenen Rand selbst widerlegen“
---
## Vorab
In der letzten Zeit habe ich mich mit einer Sache beschäftigt: **auf Prognosemärkten nach einer Methode zu suchen, die sich stabil profitabel macht**.
Aber ich möchte keinen Text darüber schreiben, „Ich habe eine sichere Strategie gefunden“ – denn in diesem Bereich gilt: **Je bestimmter du dich ausdrückst, desto eher liegst du falsch**.
Ich möchte stattdessen etwas anderes schreiben: **ein Experimentalsystem, das sich selbst widerlegen kann**.
Dieser Artikel wird drei Dinge klar machen:
1. **Der Mechanismus, der Geld bringt**—woher genau das Geld kommt (keine Mystik, sondern Mathematik)
2. **Engineering-Umsetzung**—wie man Forschung in eine verifizierbare, abgleichbare und selbstwidersprechende Experiment-Plattform verwandelt
3. **Crash-Protokoll**—Ich habe selbst 4 „sieht schön aus“-Schlüsse von mir zerstört
Ich glaube, der 3. Teil ist der wertvollste.
---
## I. Grundprinzip: Woher kommt das Geld?
Das Wesen von Vorhersagemärkten ist **Nullsummen-Wettkampf**: Jeder Cent, den du verdienst, stammt von der Gegenpartei, die „bereit ist, dir für etwas zu zahlen“.
Wenn man alles durchspielt, gibt es nur 5 Quellen für Gewinn:
| Quelle | Wesen | Stabilität |
|---|---|---|
| Liquiditätsprämie | Bietet sofortigen Ausführungslösungen | hoch (aber Programmierung nötig) |
| **Zeitwert** | Plattform sperrt Geld ohne Zinsen | **Strukturell** |
| **Verhaltensbias** | Privatanleger lieben es, „Lottoscheine“ zu kaufen | **Langfristig gültig** |
| Informationsvorteil | Schnellere/genauere Erkenntnis | Nicht stabil |
| Strukturelles Arbitrage | Reine technische Ausführung | Sehr seltene Chancen |
### Verifiziere mit Daten, nicht mit Bauchgefühl
Ich habe eine Kalibrierungsprüfung mit echten Daten aus **3.018 abgerechneten Märkten** durchgeführt (inkl. 5.366 Beobachtungen vor der Abrechnung). Das Ergebnis war kontraintuitiv:
**Fündigkeit 1: Tail-Preise sind fast perfekt.**
- Anteile mit Preis ≥97¢: Kauf am Tag vor der Abrechnung, tatsächliche Trefferquote **99,7%** (n=955)
- Anteile bei Preis <2¢: In 691 Beobachtungen** keine einzige** Auszahlung—die „seltene Abweichung“ aus dem Lehrbuch existiert hier praktisch nicht
**Fündigkeit 2: Die echten systematischen Abweichungen liegen im Mittelteilstück.**
- Der Markt mit einem Preis von **50–70¢**: Kauf 7 Tage vor Abrechnung, tatsächliche Trefferquote **64,5%**, erwarteter Ertrag **+13%**
- Kauf 30 Tage vor Abrechnung, tatsächliche Trefferquote **70,4%**, erwarteter Ertrag **+20,3%**
**Mechanik**: Der Markt „rundet“ das Problem im fernen Mittelfeld durch eine **Komprimierung auf 50/50**—ein Pricing von 58¢ plus ein Ereignis mit noch einem Monat bis zur Abrechnung ist oft bereits auf Schienen, die tatsächliche Eintrittswahrscheinlichkeit liegt bei etwa 70%.
**Fündigkeit 3: Es gibt einen „Toten Bereich“.**
- Bei der Preisspanne **70–97¢** ist die erwartete Rendite in allen Zeithorizonten negativ
- Und genau dieser Bereich ist das, was Privatanleger am liebsten kaufen ("Neun Zehntel Sicherheit, wirkt noch günstig")
**Fündigkeit 4: Strukturelles Arbitrage gibt es nicht.**
Ich habe 360 Multi-Optionen-Ereignisse gescannt und zunächst 35 „Arbitragechancen“ gefunden. Aber nachdem ich mit dem offiziellen Interface die **Integrität der Beine** geprüft habe, verschwanden alle—Σ Verkaufs-/Angebotsseite minus Σ Kaufseite = 0,9%~1,7%—**genau das ist der Spread von Market Makern**. Der Markt ist im Top-of-Book effektiv.
### Daraus resultierende Strategie
Wandle die Entdeckung in „vergangene Tagesrendite des Kapitals“ um und vergleiche—das Ergebnis ist verblüffend:
| Strategie-Bein | Bedingung | Trefferquote | **Tagesrendite aufs Kapital** |
|---|---|---|---|
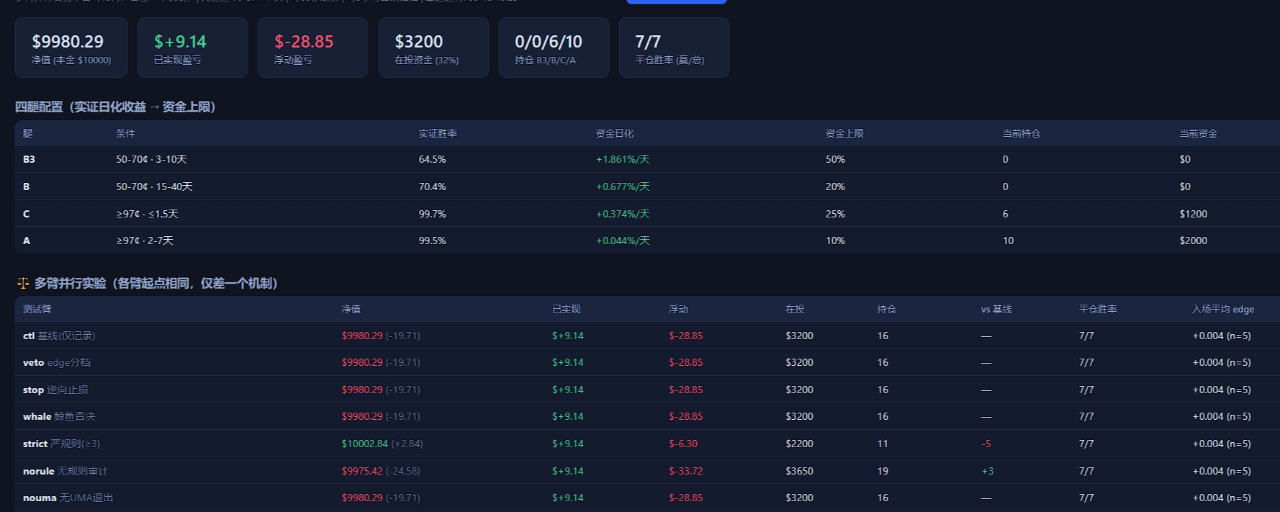
| **B3 (Kern)** | 50–70¢ · 3–21 Tage bis zur Abrechnung | 64,5% | **+1,86%/Tag** |
| B (Erweiterung) | 50–70¢ · 21–60 Tage | 70,4% | +0,68%/Tag |
| **C (Stabilisator)** | ≥97¢ · bis Abrechnung ≤1,5 Tage | 99,7% | **+0,37%/Tag** |
| A (Auffüllen) | ≥97¢ · 2–7 Tage | 99,5% | +0,04%/Tag |
**Die Tagesrendite von B3 ist das 42-fache der A-Bein-Version der ersten Iteration.** Das widerlegt meine ursprüngliche Kapitalallokation—ich hatte ursprünglich 80% des Kapitals auf das Bein mit der niedrigsten Rendite gelegt.
---
## II. Engineering: Wie macht man daraus ein verifizierbares Experiment
Das Prinzip ist nur der Startpunkt. Der eigentliche Knackpunkt ist: **Woher weißt du, dass dein Fazit kein Rauschen ist?**
Ich habe drei Ebenen aufgebaut.
### 1. Ebene: Datenebene
- **Plattformdaten**: Gamma API (Markt-Metadaten), CLOB API (Orderbuch & historische Preise), Data API (Trades & Positionen)
- **Externe Informationen** (alles praktisch getestet nutzbar):
- **Deribit-Optionskette** → berechne direkt mit den Optionspreisen die **risikoneutrale Wahrscheinlichkeit „Fälligkeit über einem bestimmten Preis“**
- **Sharp-Screen-Sportwettenquoten** (The Odds API) → faire Wahrscheinlichkeiten nach „Wasser herausgerechnet“ bei 9 Buchmachern
- **Kalshi** (regulierte Börse) → Konsens über Märkte hinweg
- **ESPN** → kostenlos, unbegrenzte Quote der endgültigen Spielstände
- **Google News** → Frühwarnung vor Katalysatoren
### 2. Ebene: Strategieebene
Filter werden nicht „aus dem Bauch“ gesetzt—jeder hat eine empirische Grundlage:
| Filter | Empirische Begründung |
|---|---|
| Regelmehrdeutigkeit-Audit (0–10 Punkte) | Regelmehrdeutigkeit ist die Nummer-1-Quelle für Tail-Verluste |
| Überspringe den Preisspannenbereich 0,60–0,65 | In diesem Bereich ist die erwartete Rendite **−3,3%** |
| Anti-Pump (3 Wochen Anstieg > 10 Punkte dann stoppen) | Diese Gruppe nur **50%** Trefferquote |
| Absenkung der Volumenschwelle | Trefferquote bei niedriger Liquidität 69,7% > bei hoher Liquidität 60,2% |
| Binäre Märkte bevorzugt | Binär +15,7% vs. Mehroptionen-Bein +7,4% |
| A-Bein Ausschluss verschlüsselte Ereignisse | Verschlüsselung ist die einzige verlustreiche Kategorie für das A-Bein (EV −0,97%) |
### 3. Ebene: Parallel-Plattform für 17 Arme
Das ist der Kern des gesamten Systems.
**Designprinzip: Jeder Arm verändert nur ein einziges Modul—alles andere wird gemeinsam genutzt.**
- Geteilt: Kandidatenpool, Momentum/Edge/Geldfluss-Schwellen, Snapshot des Marktzustands, Regeln für alle Beine
- Unterschiedlich: Es gibt nur eine Variable (ob edge nach Klassen gestaffelt wird? ob inverse Stop-Loss aktiviert ist? ob Regeln streng auditiert werden?)
Aktuell werden 17 Arme parallel getestet:
| Arm | Was wird getestet |
|---|---|
| `ctl` Baseline | Referenz |
| `veto` | Kann externe Preisbildung Gegenpositionen aussortieren |
| `stop` | Ist ein plötzlicher starker Einbruch nach Einstieg ein Informationssignal |
| `whale` | Hat der Geldfluss Vorhersagekraft |
| `strict` / `norule` | **Der eigentliche Wert des Regel-Audits** |
| `nouma` | Netto-Beitrag des UMA-Sicherheitsnetzes |
| `kalshi` | Wert eines Cross-Platform-Orakels |
| `lam50` / `lam25` | Sind externe Signale überoptimistisch?
| `deadzone` | Gegenprüfung „Toter-Bereich“-Schluss |
| `weather` / `esports` / `longmid` / `lowvol` | Lohnt sich es, ausgeschlossene Kategorien anzugehen |
| `verify` / `verify2` | „Erst prüfen, dann wetten“—gilt das?
**Warum so entworfen?**
Weil alle Arme mit **völlig identischem Marktzustand** konfrontiert sind (dieselbe Kandidatenliste, derselbe Preis, dieselbe Schwelle)—statistisch nennt man das „gemeinsame Zufallszahlen“. Dadurch lässt sich die Varianz stark senken. **Parallele Multi-Arm-Experimente sind nicht nur schneller, sondern auch genauer als serielle Experimente.**
---
## III. Crash-Protokoll: Ich habe meine 4 Schlüsse zerstört
Dieser Teil ist das, was ich am liebsten schreiben möchte. **Ohne dieses System würden diese Fehler mit echtem Geld eingekauft.**
### Crash 1: Ein Vorzeichenfehler erzeugte die Illusion von „100% Trefferquote“
Mein externer Pricing-Modul meldete eine erstaunliche Chance:
> Bei einem ETH-Markt: externe Schätzung „Trefferwahrscheinlichkeit = **100%**“, aber der Markt preist nur 36% ein
Es sah nach einem Jackpot aus. Nach der Untersuchung fand ich **drei Bugs**:
1. Die Trefferwahrscheinlichkeitsfunktion hat nur **Upward**-Berührung implementiert; „bis zu einem Preis fallen“ ist **Downward**—wenn die Barriere unter dem aktuellen Preis liegt, gibt die Funktion direkt 1.0 zurück
2. Die Wahl des Fälligkeitsdatums nahm „die nächste Tagesfälligkeit“ (0,3 Tage) statt des Monatsendes, das zu dem Marktschluss passt
3. Berechnung der **Downside**-Schranke mit der Volatilität bei/um den Geldkurs (ATM) und Ignorieren der Downside-Schiefheit
Nach der Reparatur wurde die externe Schätzung von „100%“ zu **28,7%**; Marktpreis 36%—**Uneinigkeit von −64 Punkten zu +7,3 Punkten** (das ist das wahre und sinnvolle Signal).
**Lehre: Eine Formel für die falsche Richtung kann aus dem Nichts die Illusion von „Unbesiegbarkeit“ erzeugen—und je verführerischer sie aussieht, desto mehr muss man sie anzweifeln.**
### Crash 2: Fehlt ein Datumsfeld, entsteht ein falscher Edge von +36 Punkten
Ähnliches Problem: Wenn im Marktdatensatz ein Enddatum fehlt, wählt das Modul das nächstliegende Fälligkeitsdatum und berechnet eine völlig bedeutungslose Wahrscheinlichkeit.
Reparatur: Wenn ein Datum fehlt, wird standardmäßig „das späteste Fälligkeitsdatum dieses Monats“ verwendet, und zusätzlich eine harte Schutzregel: **Wenn |edge| > 25 Punkte, gilt das Modell als abnormal und wird nicht in Entscheidungen einbezogen.**
### Crash 3: Wetterquelle—kostenlos, präzise, aber komplett unbrauchbar
Ich habe Wettermarkt-Preise mit den **31 Ensemble-Mitgliedern von Open-Meteo** umgesetzt (Anteil der Mitglieder, die innerhalb des Schwellenbereichs liegen = Wahrscheinlichkeit). Daten perfekt, kostenlos, ohne API-Key.
**Empirisches Ergebnis**:
- Märkte mit hoher Liquidität im Wetterbereich werden **am selben Tag abgerechnet**—aber die Teilnehmer an diesem Tag sehen die Live-Messwerte der Temperatur. Unsere „Vorhersage für den ganzen Tag“ war abgelaufene Information; der gesamte Edge ist tief negativ (−70% bis −96%)
- Die Uneinigkeit im Markt von morgen ist nur ±1,8°C, aber die Bucket-Breite im Wettermarkt beträgt **nur 1°C** — Modellfehler reichen aus, um die Bucket-Wahrscheinlichkeiten vollständig zu verzerren
**Fazit: Nicht anbinden.**
**Lehre: Die Verfügbarkeit einer Informationsquelle ≠ Existenz eines Edges. Selbst kostenlose und genaue Daten können wegen Abrechnungsfrist oder Fehler-Skalen irrelevant fürs Marktgeschehen sein.**
### Crash 4: Strategie mit höchster Trefferquote, aber größtem Verlust
Das ist der wertvollste Durchbruch.
**Annahme**: Es gibt auf dem Markt Positionen zu Ereignissen, die „bereits vorbei sind, aber noch nicht abgerechnet wurden“. In der realen Welt gibt es Antworten—man muss nur „abgleichen“. Das sollte nahe an risikofrei liegen.
Monte-Carlo liefert: Trefferquote 99,9%, 90 Tage +472%.
**Empirisches Ergebnis (38 abgerechnete Trades)**:**
```
Trefferquote 92,1% (35 Siege, 3 Niederlagen)
Gesamtgewinn +$39,95 (Ø +$1,14 pro Trade = +2,3%)
Gesamtverlust −$150,00 (Ø −$50,00 pro Trade = −100%)
Nettoergebnis −$110,05
```
**Tödliche mathematische Asymmetrie**:
> Benötigte Trefferquote für Break-even = 50 ÷ (50 + 1,14) = **97,8%**
> Tatsächliche Trefferquote = **92,1%**
> → Sicherer Verlust
**Die Wahrheit hinter 3 Verlusttrades (alles kein Glück)****:**
- `Exact Score: Liverpool 0-0 Fulham` → Wir kauften „Nein“—**der Spielstand ist wirklich 0-0**
- `Oregon vs. Oklahoma State` → **Sportliche Überraschung**
- `Tokyo niedrigste Temperatur 21°C` → **Temperatur-Bucket verfehlt**
**Dieselbe Tatsache**: Der Markt handelt mit einem Discount von 0,95–0,99—das ist die reale Risiko-Prämie, kein kostenloses Mittagessen.
„Abgelaufen, aber noch nicht abgerechnet“ ≠ „Ergebnis bekannt“—UMA wird noch nicht abgerechnet, weil das Ergebnis möglicherweise weiterhin umstritten ist.
### Daraus entstand die korrigierte Version: die echte „Verifikation“
Ich habe `verify2` neu implementiert: **erst kaufen, nachdem Fakten mit externen Datenquellen bestätigt wurden**.
- Sport → mit ESPN den **endgültigen Spielstand** bestätigen
- Verschlüsselung → mit Deribit den **Preis im Abrechnungszeitpunkt** bestätigen
- Wetter / Exakte Ergebnisse / Politik / E-Sport → **nicht machen** (lieber Chancen opfern, niemals falsches Risiko eingehen)
**Im Umsetzungsprozess habe ich wieder ein gefährliches Fehlurteil abgewehrt**: Die erste Version hat „Pittsburgh“ aus College-Football fälschlich dem Baseballteam **Pittsburgh Pirates** zugeordnet und „Cincinnati“ **Cincinnati Reds**—so würden wir auf Basis **falscher Fakten** ordern.
Nach der Reparatur (mit Anforderung, dass **beide Mannschaftsnamen** getroffen werden): korrekt wurde die echte Oregon-Niederlage identifiziert, während Indiana, James Madison usw. echte Gewinner freigegeben wurden. Jede Partie, bei der man nicht bestätigen kann, wird sofort als „nicht verifizierbar“ markiert—**sicherer Verzicht**.
---
## IV. Aktueller Stand (ehrliche Version)
17 Arme—starten jeweils mit $10.000 virtuellem Kapital, bauen dann jeweils die Positionen separat auf.
**Erste echte Abrechnungsdaten**:
| Arm | Netto-Wert | Realisiert | Trefferquote |
|---|---|---|---|
| `strict` Strenges Regel-Audit | **$10.005,07** | +$9,14 | 7/7 |
| Baseline gleich verteilt über 10 Arme | $9.992,85 | +$9,14 | 7/7 |
| `deadzone` Toter Bereich | $9.988,81 | +$9,14 | 7/7 |
| longmid Ultralanges Mittelstück | $9.940,65 | +$9,14 | 7/7 |
| **`verify` sieht nur die Zeit** | **$9.359,60** | **−$99,74** | **39/42 = 92,9%** |
| **`verify2` abgeglichen** | $9.939,97 | +$9,14 | 7/7 (neu live) |
**Lesbare frühe Signale** (Stichprobe noch klein):
- **C-Bein (Anleihen) 7 Siege in Folge** – stimmt mit 99,7% aus 3.018 Markt-Backtests überein
- **`verify` wurde widerlegt** und verliert weiter Geld
- **`strict` (strengeres Regel-Audit) minimiert die schwebenden Verluste**—konsistent mit der Erwartung, dass „Regelmehrdeutigkeit der größte Killer“ ist
- `deadzone` / `longmid` größere schwebende Verluste—konsistent mit der Richtung der Toter-Bereich-Erkennung
**Noch nicht entschieden**: Kann die Trefferquote von `verify2` wieder auf 99%+ zurückkehren? Das ist aktuell unsere hoffnungsvollste Annahme; dafür braucht es 20–30 abgewickelte Fälle, um es festzustellen.
---
## V. Ein paar übertragbare Methoden
Wenn du Ähnliches tust, könnten diese 10 Dinge nützlich sein:
1. **Zuerst falsifizieren, dann optimieren**—ein Experiment entwerfen, das sich selbst widerlegen kann, ist wichtiger als das Finden einer „guten Strategie“
2. **Die Verfügbarkeit von Informationsquellen ≠ Existenz eines Edges**—auch kostenlose, genaue Daten können komplett nutzlos sein
3. **Achte auf die Payoff-Asymmetrie**—92% Trefferquote können trotzdem Geld kosten, weil man bei Gewinnen nur 2% gewinnt, aber bei Verlusten 100% verliert
4. **Multi-Arm parallel schlägt seriell**—gemeinsame Kandidaten und Schwellen (gemeinsame Zufallszahlen), dadurch geringere Varianz und höhere Geschwindigkeit
5. **Pro Arm nur eine Variable ändern**—sonst kann man keine Attribution machen
6. **Kandidatenstrom und Schwellen teilen, aber niemals Positionen teilen**—Ich ließ einmal 17 Arme die gleiche Kombination erben. Ergebnis: Durch Event-Deduplication wurden 39% der Kandidaten gefressen; die Entscheidungen **waren bei allen Armen vollkommen identisch**. Das Experiment war im Grunde nur „Nullbetrieb“.
7. **Alle Zeitpunkte-Bias eliminieren**—Schwellen werden jeweils unterschiedlich berechnet, Abrechnung wird jeweils unterschiedlich geprüft. Daher müssen wir immer denselben Snapshot teilen
8. **Extremes Auseinanderlaufen externer Modelle zeigt fast immer, dass sie selbst falsch liegen**—erst dich selbst misstrauen lassen
9. **Wenn du eine Chance opfern musst, aber niemals in eine falsche Sicherheit stolpern**—es ist sicher, wenn das Modul bei der Prüfung „nicht bestätigt“ zurückgibt
10. **Vorsicht vor „perfekten“ Datenquellen**—je perfekter, desto misstrauischer
---
## VI. Zwei zwingende Realitätszwänge
### Einschränkung 1: Das Kapazitätsvolumen solcher Strategien ist extrem klein
Die minimale Ordermenge auf der Plattform ist **5 Shares**. Bei 97¢ ist die minimale Kostenbasis für eine Position **$4,97**.
Das bedeutet:
- **$20 Kapital** → maximal 4 Positionen → Verlust bei einem Trade ist −25% Kapital → Monte-Carlo zeigt: **Wahrscheinlichkeit für Verlustmonat 54%**, schlechtester Drawdown 78%
- **$200 Kapital** → 40 Positionen → Wahrscheinlichkeit für Verlustmonat 9%, Drawdown <16% → das ist der eigentliche „stabile“ Startpunkt
Noch wichtiger: **Im gesamten System gibt es nur etwa 115 Kandidaten-Seiten, die die Strategie-Bedingungen erfüllen**; davon haben die Kernarme im mittleren Bereich nur 7–18. Bei $125–200 pro Einzelposition liegt die Obergrenze der Kapazität für Mid-Arme bei ungefähr **$875–3.600**.
**Es ist „Muscheln aufsammeln“, nicht „Bergbau““—es skaliert nicht linear mit der Kapitalbasis.**
---
## Fazit
Dieses System hat mich bis heute **kein Geld verdienen lassen**—sein Wert besteht darin, dass es mich davon abgehalten hat, 4 falsche Schlussfolgerungen mit echtem Geld zu testen.
In Vorhersagemärkten dieser Art, in denen es Nullsumme ist, glaube ich, dass die wichtigste Fähigkeit nicht darin besteht, „genau zu prognostizieren“, sondern darin, **zwischen „Ich habe einen Edge gefunden“ und „Mein Modell hat einen Bug“ zu unterscheiden**.
Und die zuverlässigste Methode, die ich für mich gefunden habe, waren diese 17 parallelen Konten.
