

IronClaw 1.0 hat $NEAR - Staking gerade erst einen tatsächlichen Anwendungsfall gegeben—und zwar über reine Rendite hinaus. Hier ist die vollständige Aufschlüsselung dessen, was sich geändert hat, warum die Architektur standhält, und was das bedeutet, wenn du es in der Hand hältst.
Das Problem mit den meisten #AI -Agenten
Jedes bisher entwickelte Agenten-Framework teilt dieselbe strukturelle Schwäche. Das Modell, das entscheidet, was zu tun ist, ist direkt mit den Anmeldedaten verdrahtet, die es besitzt, mit den Tools, die es aufrufen kann, und mit dem Gedächtnis, das es speichert—alles in einem einzigen System ohne Trennung voneinander gebündelt. Das bedeutet: Eine schlechte Entscheidung, ein kompromittiertes Tool oder eine abgebrochene Verbindung kann den Fortschritt zunichtemachen oder Zugriff offenlegen, den es so nie hätte haben dürfen.
@NEAR Protocol baute IronClaw 1.0 speziell, um dieses Risiko zu beseitigen. Anstatt ein einziges, verheddertes System zu haben, trennt die Architektur das, was ein Agent entscheidet, von dem, was er tatsächlich ausführen darf: Jede Aktion wird über eine einzige Koordinationsschicht geleitet, die NEAR den Guard nennt. Nichts erreicht die Außenwelt, bis es diese Checkpoint-Prüfung passiert hat, und sensible Aktionen erfordern eine ausdrückliche Genehmigung, bevor sie ausgeführt werden – nicht erst danach. Auch Credentials werden nie direkt an Tools übergeben: Sie werden einmal ausgestellt, eng begrenzt, und aus Logs entfernt, sobald sie ihren Zweck erfüllt haben.
Die Benchmark-Zahlen – und warum sie wichtig sind
Läuft auf demselben Basis-Modell über jeden Test hinweg; deepseek-v4-flash, #IronClaw currently führt zu drei getrennten Benchmarks, die jeweils eine andere Art von Aufgabe unter Druck setzen:
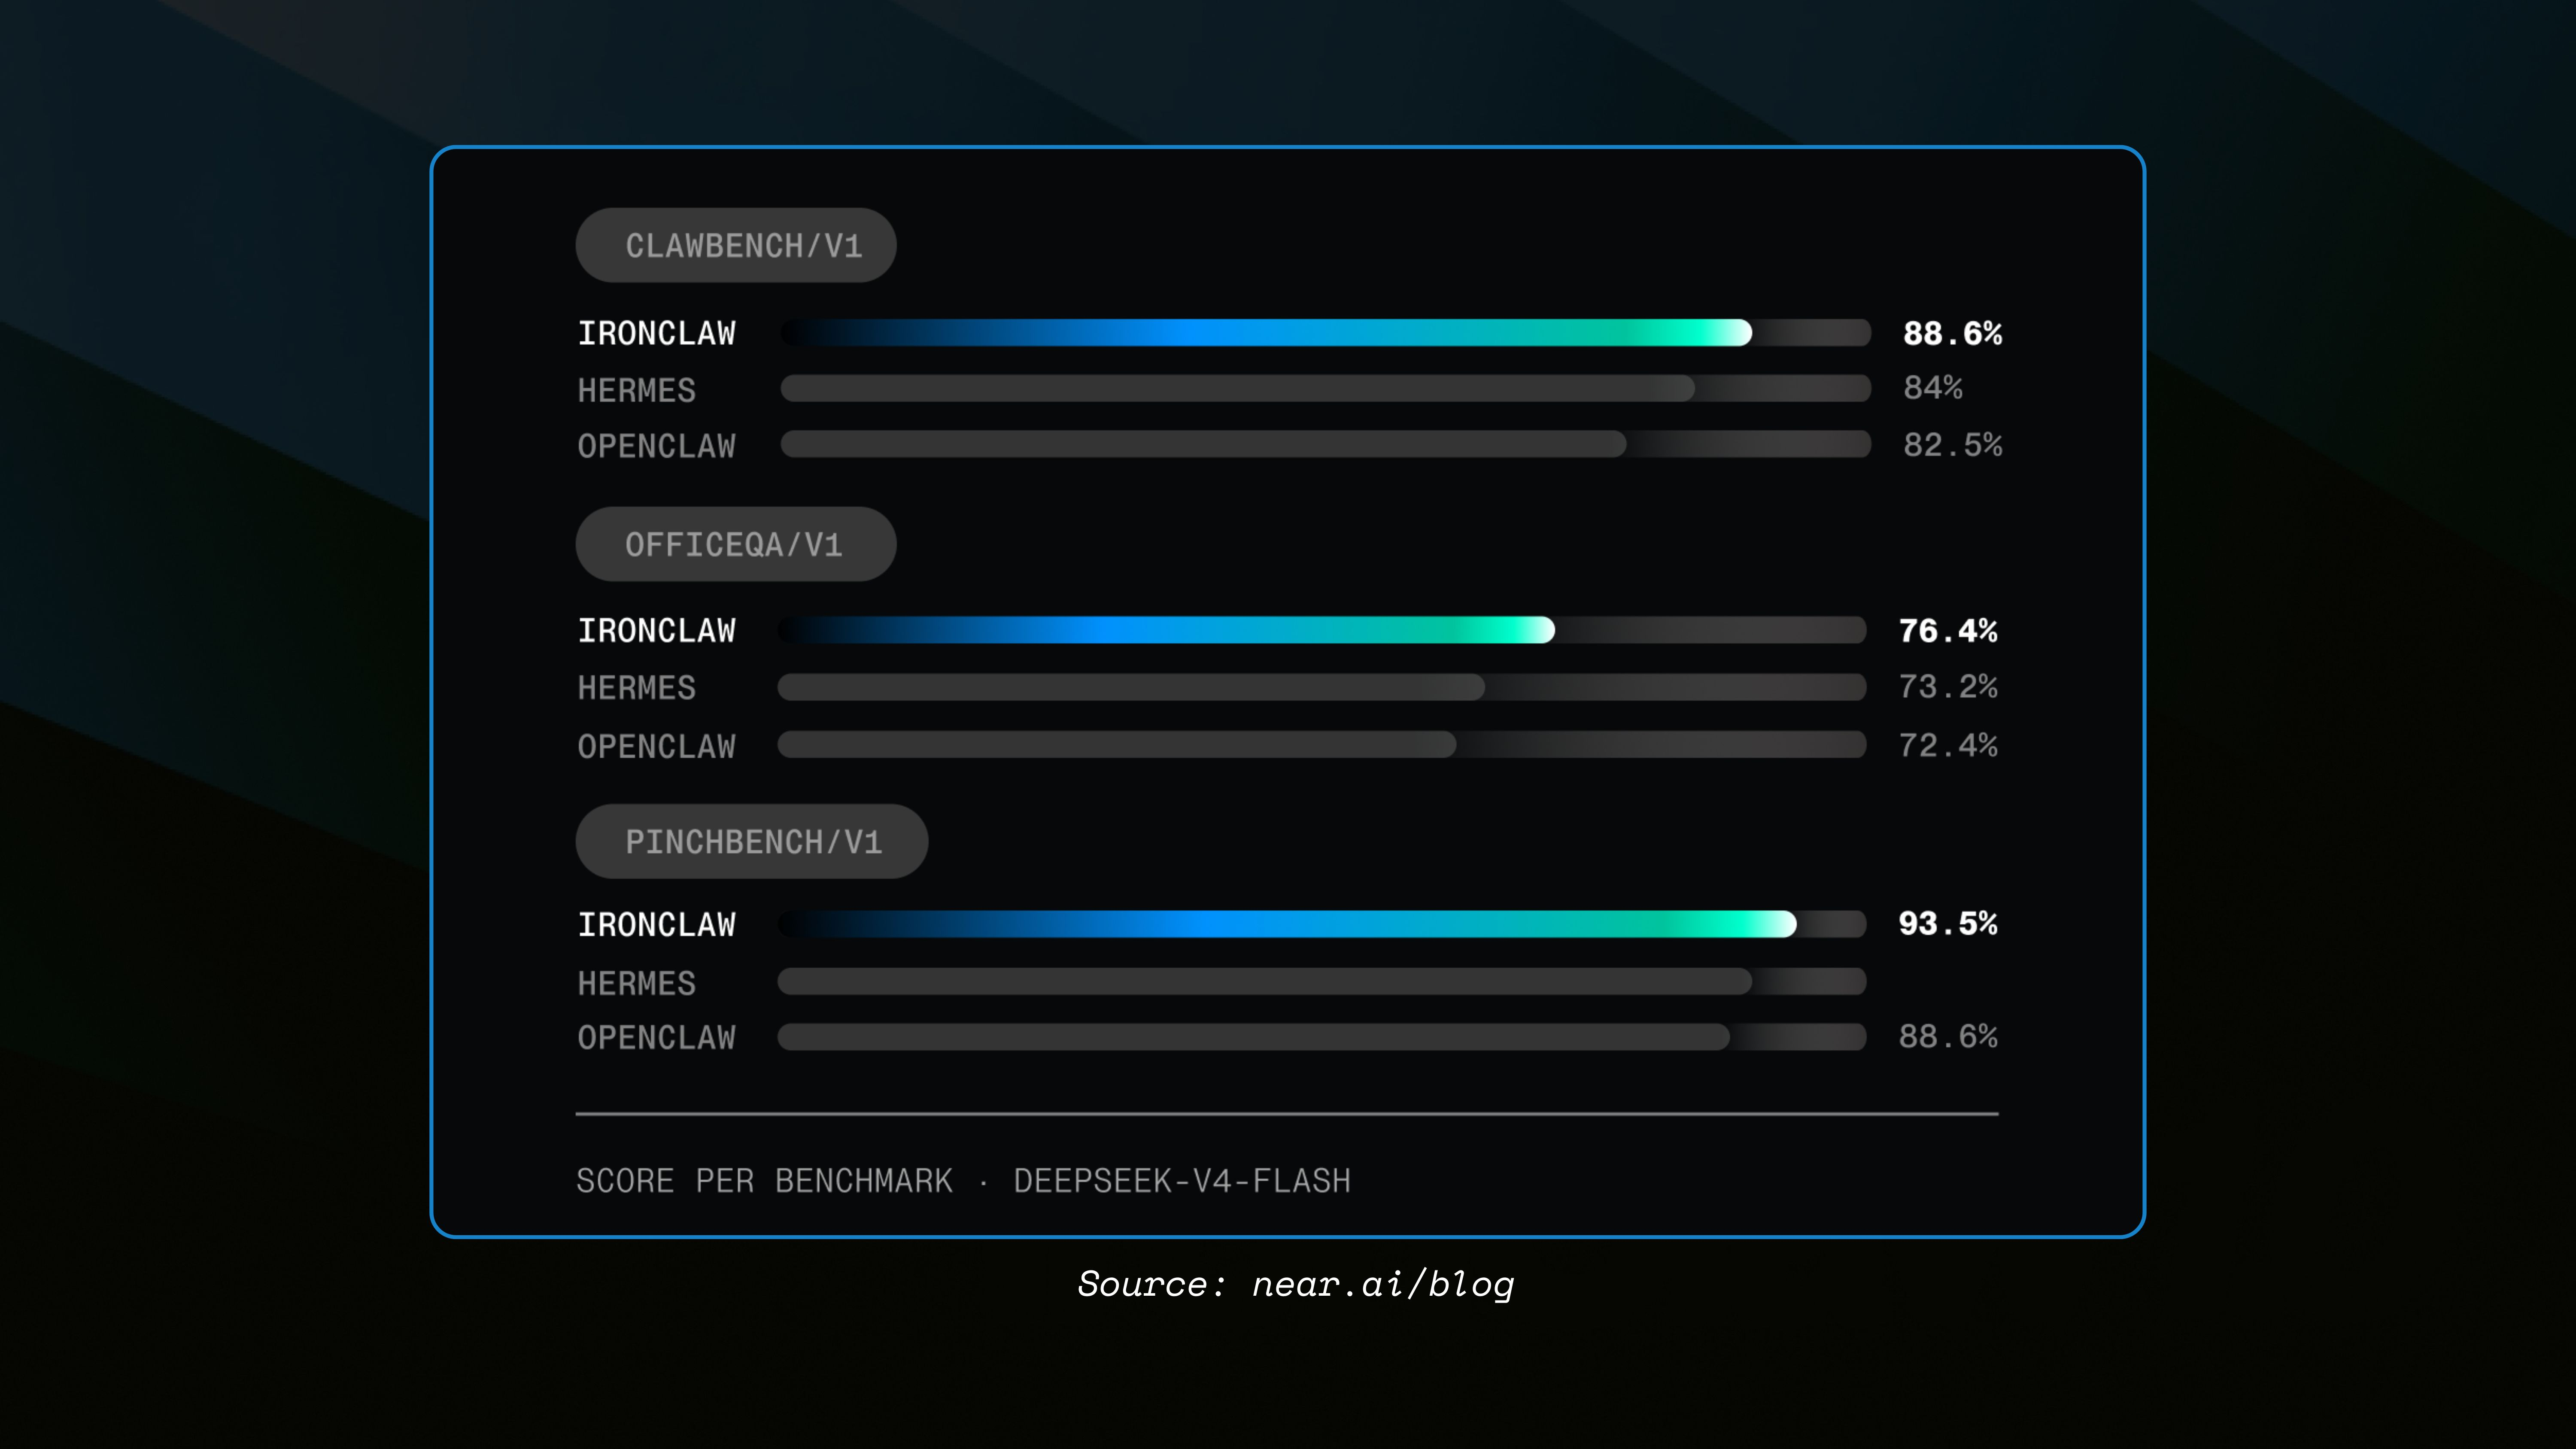
PinchBench: 93,5 %, über 147 reale Aufgaben hinweg – von Planung über Codierung bis hin zu Forschung
ClawBench: 88,6 %, getestet an mehr als 140 echten Produktions-Websites statt in Sandbox-Umgebungen
OfficeQA: 76,4 %, unabhängig von Databricks erstellt, um Schlussfolgerungen über etwa 89.000 Seiten dichter Finanzdokumente zu testen
Mit dem Detail, das man wirklich zur Kenntnis nehmen sollte: Das Basis-Modell selbst ist nichts Besonderes. IronClaw gewinnt nicht, weil NEAR darunter ein schärferes Modell trainiert hat; IronClaw gewinnt, weil die Architektur rund um ein gewöhnliches Modell die schwere Arbeit übernimmt. Das ist ein viel schwierigeres Ergebnis, das vorzutäuschen ist, und eine deutlich robustere Wettbewerbsvorteil-Struktur als ein Benchmark-Score, der durch ein maßgeschneidertes Fine-Tuning aufgepumpt wurde.
Wo Staking in der Praxis hineinpasst
Das ist der Teil, den die meiste Berichterstattung komplett übergeht: Staking wird so behandelt, als wäre es eine vage Geste in Richtung Netzwerksicherheit, ohne jemals zu erklären, was diese Sicherheit irgendwem tatsächlich bringt. #NEARAI hat die Verbindung stattdessen greifbar gemacht. Gestaktes $NEAR liegt nicht einfach nur herum und sammelt Rendite – es wird direkt in monatliche Compute-Credits umgewandelt, in einem Verhältnis, bei dem grob gesagt jede 100 gestakten NEAR etwa fünf US-Dollar an nutzbaren Credits freischalten. Diese Credits finanzieren das Hosting von IronClaw und vertrauliche Inferenz – ohne Kreditkarte und ohne Drittanbieter-Abrechnungskonto irgendwo im Prozess. Wenn du jederzeit unstakest, kommt dein ursprüngliches NEAR vollständig unversehrt zurück, weil der Mechanismus Rendite und Zuteilung umwandelt, statt das Kapital anzutasten.
Das verschiebt Staking von einer passiven Position in die wörtliche Messschicht für dezentralen KI-Compute. Jeder Agent, den dieses Ökosystem hinzufügt – IronClaw heute, OpenClaw, während sich der Raum weiterentwickelt – zieht echte Nachfrage auf dasselbe gestakte Kapital, das die darunterliegende Kette absichert. Je mehr Agenten auf dieser Infrastruktur aufgebaut werden, desto stärker wird dieser Staking-Mechanismus zur tragenden Last statt zu einer optionalen Ergänzung.
Was das in Zukunft bedeutet
Ein Agent, der Fortschritt nicht verliert, sondern durch Unterbrechungen hindurch checkpointet; der eine ausdrückliche Genehmigung benötigt, bevor irgendetwas Sensibles passiert; und der denselben Speicher über CLI, Slack, Telegram und Web hinweg mitbringt – das ist ein funktionierendes Produkt, kein Showreel. Wenn man das mit einem Staking-Modell kombiniert, das echte Nutzung mit Netzwerksicherheit verknüpft, erhält dieses Ökosystem einen Wachstumskreislauf, der keine Hype-Zyklen braucht, um weiter zu funktionieren: Die Einführung selbst erzeugt die Nachfrage.
Ändert es, Staking direkt an die Compute-Nachfrage zu koppeln, wie du über die langfristige These von $NEAR nachdenkst – oder braucht es dafür noch mehr Live-Agenten im Betrieb, bevor dieser Fall vollständig belegt ist?