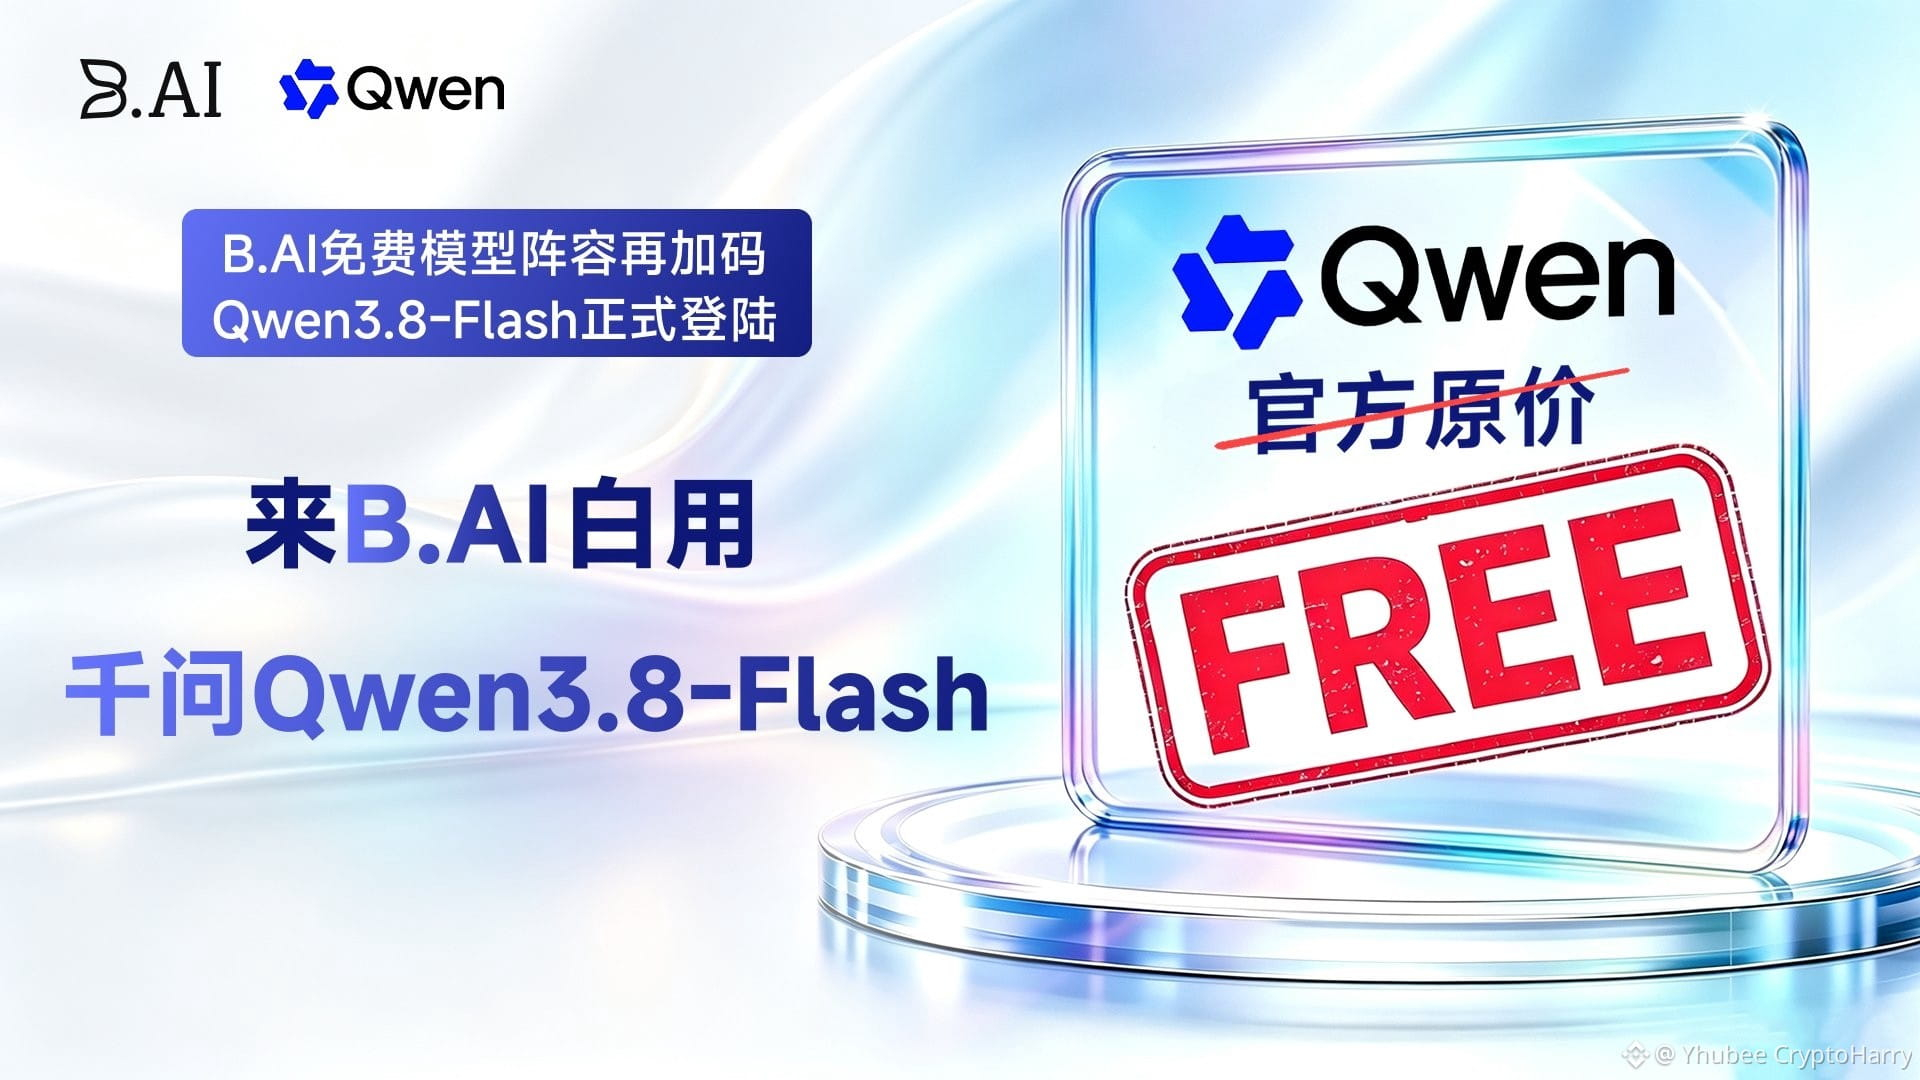
𝗤𝘄𝗲𝗻3.8-Flash ist da – und der Preis ist 0!🎁⚡
Das kostenlose B.AI-Kostenlose-AI-Team bekommt erneut ein neues Mitglied.
Als richtungsweisende Vorschau der Qwen4-Architektur nutzt Qwen3.8-Flash eine 125B-Parameter-MoE-Architektur und kombiniert 51B N-gram Embeddings, eine Hybrid-Attention-Mechanik aus GDN + QSA, Gated Residual und den Muon-Optimizer.
Noch bemerkenswerter: Es erreicht eine deutlich stärkere Gesamtleistung bei nur 1/9 der Trainingskosten im Vergleich zu Qwen3.7-Plus.🔥
📌 262K native Kontextlänge
📌 YaRN lässt sich auf 1M erweitern
📌 Starke Programmierfähigkeiten
📌 Effiziente Office-Leistung
📌 Unterstützt Szenarien mit Mehrmodality
Derzeit ist es bereits im B.AI-Official-API-Team vollständig kostenlos verfügbar.
Das neue Basismodell der Tongyi Qwen-Serie – jetzt ohne Kosten testen.🚀
👉 Kostenlos testen: chat.b.ai/chat
#TRONEcoStar @Justin Sun孙宇晨 $TRX #BAI
Das kostenlose B.AI-Kostenlose-AI-Team bekommt erneut ein neues Mitglied.
Als richtungsweisende Vorschau der Qwen4-Architektur nutzt Qwen3.8-Flash eine 125B-Parameter-MoE-Architektur und kombiniert 51B N-gram Embeddings, eine Hybrid-Attention-Mechanik aus GDN + QSA, Gated Residual und den Muon-Optimizer.
Noch bemerkenswerter: Es erreicht eine deutlich stärkere Gesamtleistung bei nur 1/9 der Trainingskosten im Vergleich zu Qwen3.7-Plus.🔥
📌 262K native Kontextlänge
📌 YaRN lässt sich auf 1M erweitern
📌 Starke Programmierfähigkeiten
📌 Effiziente Office-Leistung
📌 Unterstützt Szenarien mit Mehrmodality
Derzeit ist es bereits im B.AI-Official-API-Team vollständig kostenlos verfügbar.
Das neue Basismodell der Tongyi Qwen-Serie – jetzt ohne Kosten testen.🚀
👉 Kostenlos testen: chat.b.ai/chat
#TRONEcoStar @Justin Sun孙宇晨 $TRX #BAI