#dusk $DUSK @Dusk
Ich bin nach dem neuesten Load-Test-Ergebnis noch einmal durch die DuskEVM-Dokumentation gegangen und habe gemerkt, dass ich eine einfache Annahme gemacht hatte: Ein schneller EVM-Block bedeutete, dass DuskDS die gleichen Transaktionen erneut ausführen musste.
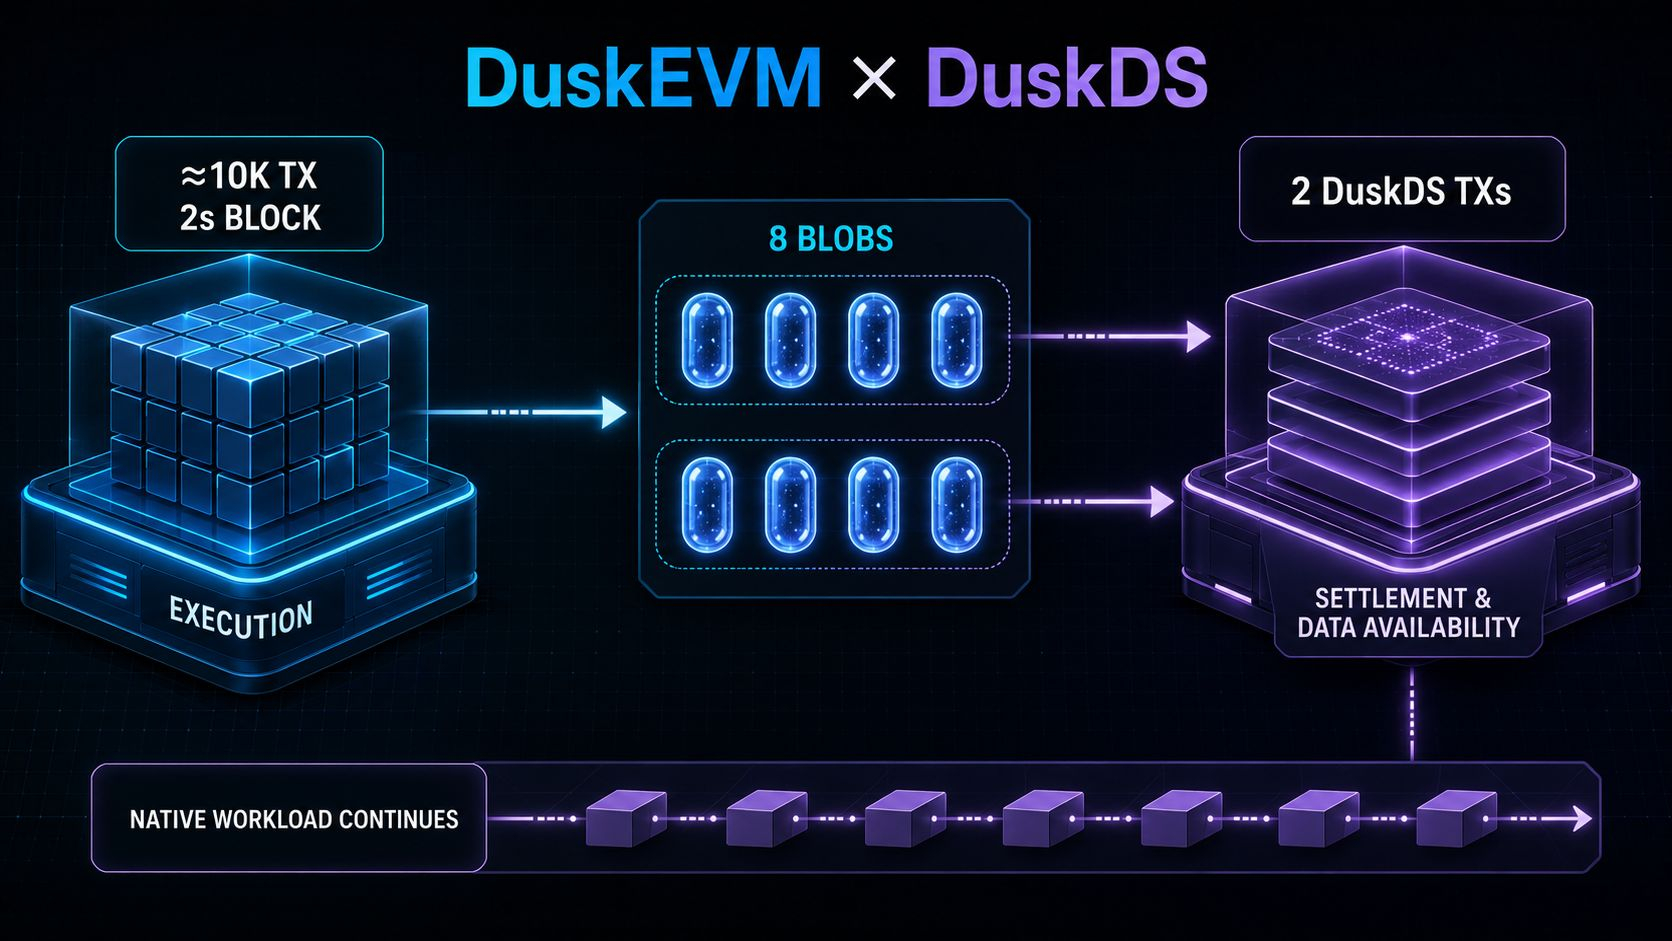
Der dokumentierte Ablauf ist anders. Eine Transaktion gelangt zum DuskEVM-Sequencer, geht in einen L2-Block ein und der Batcher veröffentlicht seine Daten auf DuskDS. Danach verbinden State-Commitments und Fault-Proofs den daraus resultierenden Zustand mit der DuskDS-Abwicklung (Settlement). Im berichteten Test führten etwa 10.000 Transaktionen in einem zweisekündigen DuskEVM-Block zu acht Blobs, aufgeteilt auf zwei DuskDS-Transaktionen, während DuskDS seine native Workload weiterhin verarbeitete.
Das hat mich dazu gebracht, es anders zu betrachten.
Meine Interpretation: Das wichtige Ergebnis ist nicht nur die Anzahl der Transaktionen. Entscheidend ist, dass die EVM-Ausführung und das DuskDS-Settlement gemischte Arbeit über separate Zustandsmodelle hinweg abgewickelt haben, ohne dass im Beispiel gezeigt wird, dass eine Workload die andere blockiert.
Meine Unsicherheit betrifft, was außerhalb des sauberen (klaren) Falls passiert. Bei anhaltend gemischter Nachfrage: Welche Worst-Case-Grenzen gelten zwischen EVM-Inklusion, Datenveröffentlichung und DuskDS-Settlement? Wenn der Sequencer oder Batcher ins Stocken gerät, wer kann dann eine Wiederherstellung (Recovery) einleiten, und was verhindert, dass diese Autorität ausstehende finanzielle Transaktionen neu sortiert oder verzögert?
Ich möchte mir das in der Praxis ansehen.
Ich bin nach dem neuesten Load-Test-Ergebnis noch einmal durch die DuskEVM-Dokumentation gegangen und habe gemerkt, dass ich eine einfache Annahme gemacht hatte: Ein schneller EVM-Block bedeutete, dass DuskDS die gleichen Transaktionen erneut ausführen musste.
Der dokumentierte Ablauf ist anders. Eine Transaktion gelangt zum DuskEVM-Sequencer, geht in einen L2-Block ein und der Batcher veröffentlicht seine Daten auf DuskDS. Danach verbinden State-Commitments und Fault-Proofs den daraus resultierenden Zustand mit der DuskDS-Abwicklung (Settlement). Im berichteten Test führten etwa 10.000 Transaktionen in einem zweisekündigen DuskEVM-Block zu acht Blobs, aufgeteilt auf zwei DuskDS-Transaktionen, während DuskDS seine native Workload weiterhin verarbeitete.
Das hat mich dazu gebracht, es anders zu betrachten.
Meine Interpretation: Das wichtige Ergebnis ist nicht nur die Anzahl der Transaktionen. Entscheidend ist, dass die EVM-Ausführung und das DuskDS-Settlement gemischte Arbeit über separate Zustandsmodelle hinweg abgewickelt haben, ohne dass im Beispiel gezeigt wird, dass eine Workload die andere blockiert.
Meine Unsicherheit betrifft, was außerhalb des sauberen (klaren) Falls passiert. Bei anhaltend gemischter Nachfrage: Welche Worst-Case-Grenzen gelten zwischen EVM-Inklusion, Datenveröffentlichung und DuskDS-Settlement? Wenn der Sequencer oder Batcher ins Stocken gerät, wer kann dann eine Wiederherstellung (Recovery) einleiten, und was verhindert, dass diese Autorität ausstehende finanzielle Transaktionen neu sortiert oder verzögert?
Ich möchte mir das in der Praxis ansehen.