


Originaler Titel: (Legal-AI-Einhorngigant mit einer Bewertung von 11 Milliarden US-Dollar, in den OpenAI investiert hat, startet „Shell-Konstruktionen“ für chinesische Open-Source-Modelle)
Originalautor: DongchaBeating
20. August, OpenAI investierte in die Rechts-AI-Firma Harvey veröffentlichte Tenet. Das 2022 gegründete Unternehmen wird derzeit mit 11 Milliarden US-Dollar bewertet und ist die weltweit höchstbewertete Legal-AI-Firma. Es bedient tausende Organisationen; zu den Anteilseignern zählen auch Sequoia, a16z und GIC.
Tenet ist sein erstes eigenes Modellpaket; die Basis nutzt die von Moonshot am 7. Juli mit offenen Gewichten freigegebene Kimi K3. Tenet befindet sich derzeit noch in der Forschungs-Preview-Phase, und Harvey plant, die darin validierten Fähigkeiten nach und nach in das Produkt zu übernehmen.
Harveys Gründer Winston Weinberg war ursprünglich Prozessanwalt bei O'Melveny & Myers, und Gabe Pereyra hat bei Google Brain und Meta an Large-Model-Studien gearbeitet. OpenAI investierte früh in das Unternehmen; danach trainierten beide gemeinsam auch ein Modell für Fallrecht (case law). Dabei wurden etwa 10 Milliarden Token an US-Fallrechtsdaten in das Training eingebracht. In den Kundencases, die OpenAI damals veröffentlichte, sagte Pereyra: Harvey habe verschiedene Ansätze bewertet und am Ende nur dem Ansatz vertraut, der gemeinsam mit OpenAI für dieses maßgeschneiderte Training umgesetzt wurde.
In den vergangenen Jahren war es fast durchgehend ein Closed-Source-Modell – und zwar das typischste Kundenmodell der professionellen Servicebranche. Es konnte stets auf eine der stärksten Closed-Source-Modellgruppen weltweit zugreifen. Aber als es zum ersten Mal entschied, seine eigenen juristischen Aufgaben, die Bewertungsmaßstäbe der Anwälte und die Rechenleistung von zwei Monaten wirklich in ein Set von Gewichten zu schreiben, war das ausgewählte Basismodell ein offenes Gewichtsmodell aus China.
Sobald ein Modell veröffentlicht ist, erfährt die Branche sehr schnell zwei Dinge: wie klug es ist – und wie viel diese Fähigkeiten kosten. Innerhalb weniger Stunden werden Benchmarks aktualisiert, Ranglisten in Arenen ändern sich, und all die Koordinatendiagramme aus „Intelligenz“ und „Preis“ beginnen sich zu verbreiten. Schließlich wird ein Modell, das mehrere Monate trainiert wurde und viel Rechenleistung verbraucht hat, zu nur einem Punkt auf dem Diagramm komprimiert.
Für die meisten Entwickler funktioniert diese Methode weiterhin. Die zugrunde liegende Voraussetzung ist, dass die Fähigkeiten im Wesentlichen „eingefroren“ sind, sobald das Modell dem Nutzer übergeben wird. Bei vorherrschendem Closed-Source-API ist diese Voraussetzung gegeben. Die Modellfirma macht Vortraining und Nachtraining und kapselt die Fähigkeiten dann zu einer Schnittstelle. Unternehmen in der Folgekette können Prompts anpassen, Retrieval durchführen und Agents bauen, aber sie können das Modell selbst kaum weiter verändern.
Offene Gewichte durchbrechen diese Voraussetzung. Wenn Unternehmen die Gewichte erhalten, können sie ihre eigenen Daten und Experten-Feedback weiter hineingeben und so echte Aufgaben und Bewertungsmaßstäbe ins Training bringen. Zwei Modelle, die bei der Veröffentlichung beide 90 Punkte erreichen – aber mit denselben Daten und derselben Rechenleistung weitertrainiert: eines bleibt am Ende bei 91 Punkten stehen, das andere kann bis auf 97 Punkte kommen. Für Unternehmen, die mehrere Monate in Zeit, Rechenleistung und Expertenressourcen investieren wollen, bedeuten „bei Veröffentlichung 90 Punkte“ – bei identischer Ausgangslage – bereits Welten.
Aber dafür gibt es eine Voraussetzung: Unternehmen sind bereit, ein paar Monate Zeit und eine Portion Rechenleistung zu investieren, um weiter zu trainieren. Zuerst muss es aber eine Reihe von Gewichten geben, die sich wirklich lohnt. In den vergangenen Jahren gab es zwischen offenen Modellen und den jeweils modernsten Closed-Source-Modellen stets eine Lücke. Bei allgemeinem Frage-Antwort und beim alltäglichen Schreiben von Code ist diese Lücke nicht so groß. Sobald man aber in professionelle Szenarien mit hohen Fehlerkosten geht, wird diese Distanz deutlich vergrößert. Recht ist außerdem eine der anspruchsvollsten Disziplinen. In der Vergangenheit konnten nur die Closed-Source-Modelle mit den stärksten Fähigkeiten überhaupt in das Kerngeschäft solcher Firmen wie Harvey gelangen. Open Weights lassen sich zwar leichter kontrollieren und umbauen, aber wenn man nicht einmal die grundlegenden professionellen Aufgaben bewältigen kann, gibt es auch keine Grundlage mehr, um überhaupt über den Spielraum für das weitere Training zu sprechen.
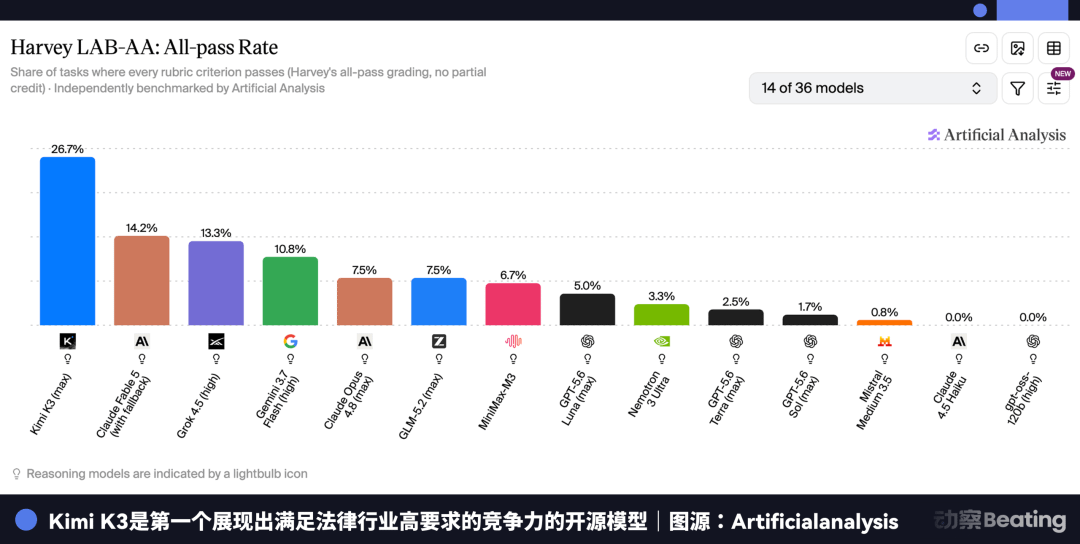
Kimi K3 hat diese seit langem bestehende Hürde zum ersten Mal überwunden. Seine Gesamtparameterzahl liegt bei 2,8 Billionen, es unterstützt Kontextlängen von 1 Million Tokens und verfügt damit bereits über eine solide Grundlage für Langaufgaben, Tool-Nutzung und komplexes Schließen. Für Harvey sind offene Gewichtsmodelle damit erstmals nicht mehr nur eine günstigere Alternative mit mehr Kontrolle – sondern sie bewegen sich in einen Bereich, der ernsthaft gemeinsam mit den führenden Frontier-Modellen bewertet werden kann.
So begannen sie sich für eine Frage zu interessieren, die früher selten separat diskutiert wurde: Wie gut lassen sich diese Gewichte wohl weiter trainieren?
Cursor trainierte Composer 2 nicht nach den üblichen Ranglisten für Programmier-Agenten. Die Einschätzung war: Fähigkeiten von Agenten und Langaufgaben ändern sich im Verlauf des Reinforcement-Learnings stark; die anfängliche Rangfolge vor Trainingsbeginn sagt nicht zwingend das finale Ergebnis voraus. Statt auf Ranglisten-Punkte achtete Cursor stärker auf das Programmierwissen des Modells, die Fähigkeit zur Zustandsverfolgung, die Verwirrung (Perplexity) im internen Codebestand sowie die Laufzeiteffizienz in der eigenen Infrastruktur. Als Basis wurde schließlich das Kimi K2.5-Modell ausgewählt.
Auch Cognition, das Unternehmen hinter Devin, traf eine ähnliche Einschätzung. Nachdem K3 als Open-Weight-Modell freigegeben wurde, verband es das Modell sehr schnell mit Devin Desktop und CLI. Auf dessen eigener FrontierCode 1.1 Extended erreichte K3 58,2% Punkte und 63,6% Durchlaufquote. Dieser Test prüft echte Engineering-Aufgaben: Ob der Code am Ende in den Hauptzweig integrierbar ist und ob die Qualität ausreicht, fließt beides ein. Cognition erwähnte außerdem, dass K3 besonders gut darin ist, Bugs zu reproduzieren und seine eigene Laufumgebung zu verwalten – genau das sind die Stellen, an denen Langstrecken-Programmieraufgaben am leichtesten aus dem Ruder laufen. Anschließend wurde auch auf diesen Gewichten nachtrainiert.
Wirklich knapp sind nicht juristische Daten
Harveys Wachstum ist rasant: Im März dieses Jahres versorgt es etwa 1300 Institutionen und mehr als 100.000 Anwälte. Fünf Monate später hat sich die Zahl der Kunden fast verdoppelt, in 70 Ländern ist es verfügbar. In mehr als drei Viertel der Kanzleien im AmLaw 100 wird Harvey eingesetzt.
Juristische Dienstleistungen sind teuer, und die Toleranz für Fehler ist sehr niedrig. Ein M&A-Due-Diligence-Bericht muss möglicherweise aus Hunderten oder Tausenden Dokumenten Klauseln zum Kontrollwechsel herausziehen, prüfen, ob die Transaktion dadurch ausgelöst wird, und anschließend Risiken identifizieren und mit Originalquellen belegen. Dazwischen müssen oft Dutzende Urteile fortlaufend alle zutreffen. Wenn man nur eine einzige echte, transaktionsrelevante Frage übersieht, verlieren die meisten der zuvor korrekten Arbeiten ihren großen Nutzen.
Mit der Zahl der betreuten Kanzleien, die weiter steigt, hat Harvey auch eine Art Basismodell-Daten angesammelt, die eine solche Firma oft nicht selbst beschaffen kann. Es weiß, wie Anwälte eine Aufgabe strukturieren, und es weiß auch, wo die Partner typischerweise Fehler im Ergebnis auswählen.
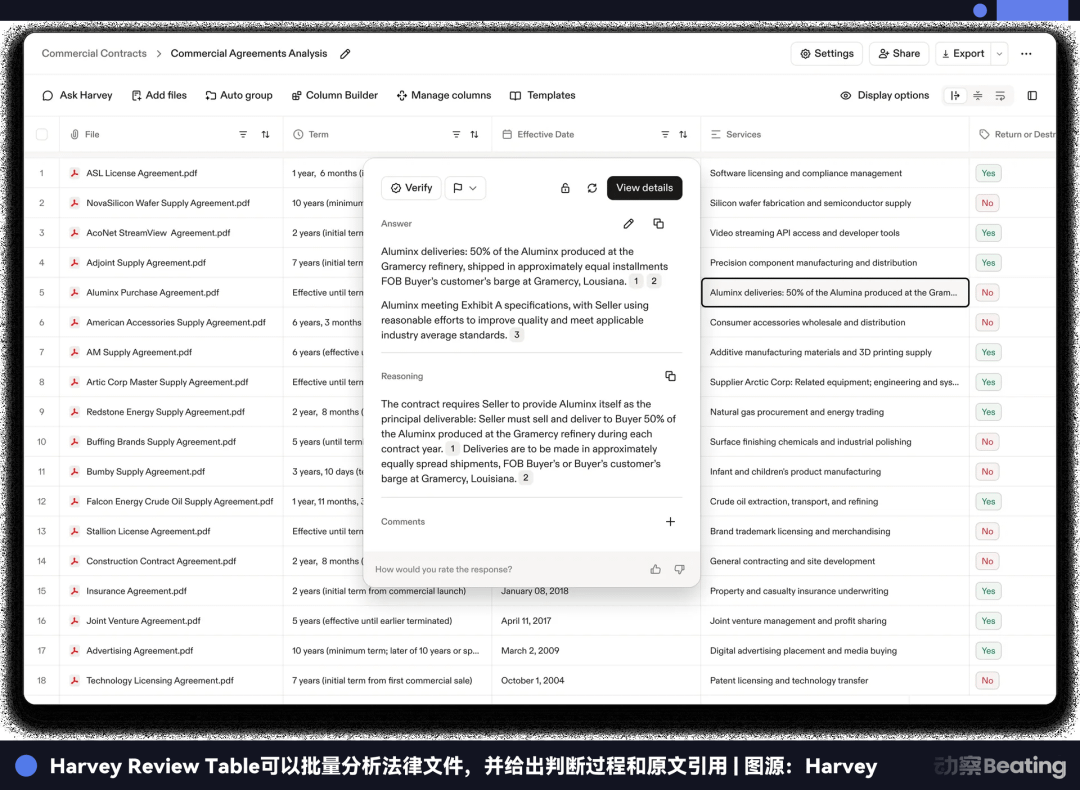
Diese Erfahrungen wurden später zum Legal Agent Benchmark gemacht. Dort gibt es bereits mehr als 1200 juristische Langaufgaben, die 24 Berufsfelder abdecken. Jede Aufgabe hat im Schnitt nur etwa 50 Wörter Beschreibung; das Modell wechselt anschließend in eine abgeschlossene Umgebung mit einem „Kundenfall“. Relevante Dokumente und viele unzutreffende Materialien liegen durcheinander. Das Modell muss selbst suchen, lesen, beurteilen und am Ende ein Arbeitsergebnis liefern, das Schritt für Schritt überprüft werden kann.
Jede Aufgabe hat im Schnitt etwa 50 Bewertungsmaßstäbe; komplexe Aufgaben können auch mehrere hundert haben. Ob die Fakten vollständig gesucht wurden, ob die Schlussfolgerungen tragfähig sind, ob die Zitate wirklich zum Originaltext passen, ob die Risikostufe und die Empfehlungen angemessen sind – all das wird in einzelne, unabhängig beurteilbare Bewertungspositionen zerlegt. Eine Aufgabe kann sich über maximal mehr als 1000 Runden erstrecken und dabei Hunderttausende Tokens verbrauchen.
Nach ein paar Jahren Praxis kennen junge Anwälte langsam, wovor sich Mandanten wirklich Sorgen machen – und sie merken sich auch, welche scheinbar unauffälligen Klauseln auf keinen Fall übersehen werden dürfen. Diese Erfahrungen lassen sich früher nur schwer vollständig in Lehrbücher schreiben; sie bleiben meist in den Änderungen der Partner, in den internen Arbeitsgewohnheiten des Teams sowie in den vielen einzelnen Dokumenten, die bereits ausgeliefert wurden.
Harvey zerlegte einen Teil davon in Aufgaben, Materialien und Bewertungsmaßstäbe. Damit hat jeder Schritt, den das Modell bei der Ausführung seiner Arbeit macht, eine Rückmeldung, die berechnet und verglichen werden kann.
Prompts und Retrieval sagen dem Modell, wo es suchen soll; die Bewertungsmaßstäbe beginnen dann, eine andere Frage zu beantworten: In welchem Umfang gilt eine juristische Arbeit überhaupt als „abgeschlossen“? Harvey hat in den vergangenen Jahren nicht nur Kunden und juristische Daten gesammelt, sondern auch ein professionelles Bewertungssystem aufgebaut, das direkt für das Modelltraining genutzt werden kann.
Juristische Erfahrung in die Gewichte schreiben
Diese Aufgaben und Bewertungsmaßstäbe gehen nun wirklich ins Training ein. Die Daten stammen aus öffentlich verfügbaren juristischen Materialien, aus synthetischen Daten sowie aus Daten von menschlichen Experten. Praktizierende Anwälte sind an der Konstruktion der Aufgaben, am Bewerten und an der Gegenprüfung synthetischer Daten beteiligt. Harvey hat insgesamt rund 1750 juristische Task-Umgebungen für Legal Agent vorbereitet.
Sobald das Modell in einen Arbeitsbereich gelangt, der Materialien und Tools enthält, muss es selbst Dokumente lesen, Tools aufrufen und Ergebnisse einreichen. Das System prüft dann die gesamte Arbeits-„Trajektorie“ anhand von Bewertungsmaßstäben, die von Anwälten festgelegt wurden: Wie viele konkrete Anforderungen wurden erfüllt, und wie weit wurden die juristischen Fragen gelöst. Wenn alle zentralen Anforderungen bestanden sind, gibt es zusätzlich eine Belohnung.
Jeder Trainingszyklus erzeugt mehr als zehntausend Task-„Trajektorien“. Harvey nutzt eine Sequenz-Strategie zur Optimierung, nämlich GSPO. Das bedeutet: Das Modell erzeugt für dieselbe Aufgabe verschiedene Vorgehensweisen, und es aktualisiert die Gewichte anhand der Qualitätsunterschiede der Ergebnisse. Wenn die Punktzahlen zweier Trajektorien zu ähnlich ausfallen, bewertet das System erneut, um den Einfluss von Bewertungsrauschen auf das Training zu verringern.
Der gesamte Prozess dauert etwa zwei Monate, unter Einsatz von ungefähr 150 NVIDIA B300-Karten. Das Vortraining eines einzelnen, modernen Modells erfordert normalerweise den Einsatz von Zehntausenden Karten; Harveys Rechenbudget lag dieses Mal in einer anderen Größenordnung. Harvey verwendet rank-64 LoRA und deckt die Attention-Layer, die Feedforward-Netze sowie die Routing-Expert-Gewichte von Kimi K3 ab; beteiligt sind etwa 500.000 Expert-Tensoren.
Das Long-Trajectory-Training steht außerdem vor einem Engineering-Problem. Eine juristische Aufgabe kann sich über Hunderte von Runden erstrecken. Während das Modell dabei seine Task-Trajektorie generiert, werden auf der Trainingsseite bereits die Gewichte aktualisiert. Wenn der Trainer später zurückkommt, um diese Trajektorie zu berechnen, und sich der Zustand der beiden Modelle unterscheidet, verändert sich die Wahrscheinlichkeit, die jeder einzelne Schritt zum damaligen Zeitpunkt hatte. Damit lässt sich die Belohnung nur schwer exakt auf die ursprüngliche Entscheidung zurückwirken.
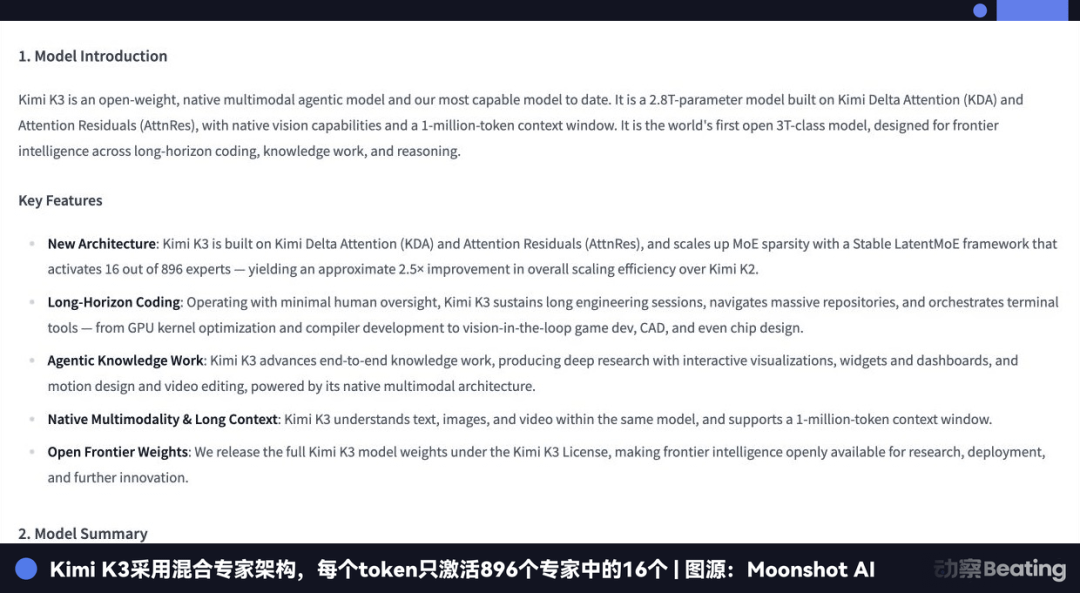
Die Misch-Experten-Struktur von Kimi K3 macht das Problem noch komplizierter. Sobald ein Token in das Modell gelangt, wählt der Router aus 896 Experten genau 16 zur Berechnung aus. Schon kleinste Unterschiede in numerischer Präzision oder im Batch-Verfahren zwischen Trainings- und Ausführungsseite können dazu führen, dass dasselbe Token unterschiedlichen Experten zugewiesen wird – und die ursprüngliche Trajektorie lässt sich dann kaum noch vollständig replizieren.
Harvey und seine Zulieferer haben deshalb das Training-Framework und die Ausführungsumgebung im Kernel-Level numerisch aufeinander abgestimmt. Nach jedem Gewichts-Update wird direkt „hot-loaded“ in die Ausführungsumgebung – ohne das wiederholte Anhalten und Generieren von Tasks. Das System protokolliert außerdem Token-entsprechende Experten-Routing-Ergebnisse, damit der Trainer beim Neuberechnen möglichst zu dem Pfad zurückkehren kann, den das Modell bei der Generierung dieser Trajektorie durchlaufen hat.
Ab hier ist Tenet nicht mehr ganz so sehr eine übliche Fine-Tuning-Routine, bei der juristisches Textmaterial einfach in ein Modell hineingefüttert wird. Harvey baut vielmehr einen Trainingsprozess, der sich immer wieder erneut ausführen lässt. Juristische Aufgaben kommen fortlaufend in die Umgebung, das Modell erledigt die Arbeit, Anwälte bewerten die komplette Trajektorie anhand festgelegter Standards, die Gewichte werden anschließend aktualisiert, und das neue Modell geht wieder in die Umgebung zurück, um die nächste Runde Aufgaben zu bearbeiten.
Ob Kimi K3 sich stabil weiter trainieren lässt, wird auch genau in so einem Kreislauf praktisch überprüft.
Nach dem Training wirkt es noch stärker wie ein Legal Agent
Was Harvey wirklich verbessern will, ist die Fähigkeit des Modells, Langstrecken-Aufgaben im juristischen Kontext zu bewältigen. Es verwendet einen sehr strengen „all-pass“-Maßstab: Die entscheidenden Bewertungsmaßstäbe in einer Aufgabe müssen alle bestanden werden. Nach den von Harvey veröffentlichten internen Ergebnissen – auf einem LAB-Aufbewahrungsset, das nicht am Training beteiligt war – liegt die Zahl der vollständig erledigten Tenet-Aufgaben bei fast dem Doppelten der ursprünglichen Kimi K3. Die All-pass-Rate stieg von etwa 11% auf 19,7%, also um rund 9 Prozentpunkte.
In den speziellen LAB Contracts-Tests zum Vertragsentwurf, zur Prüfung und Verhandlung stieg die Anzahl der erledigten Aufgaben um etwa 20%, und die All-pass-Rate erreichte 11,3%, also eine Verbesserung um ungefähr 2 Prozentpunkte. Laut Harveys eigener Rangliste liegt Tenet bei LAB Contracts auf Platz 1 und im vollständigen LAB-Ranking auf Platz 2.
Danach brachte es Tenet auch in zwei externe Tests: Mercors APEX Agents Corporate Law und Crosbys Redline Bench. Ersterer testet Langstrecken-Fachaufgaben in einer simulierten Arbeitsumgebung; letzterer verlangt, dass das Modell Verträge fortlaufend abändert und anschließend nach von Anwälten festgelegten Standards bewertet wird.
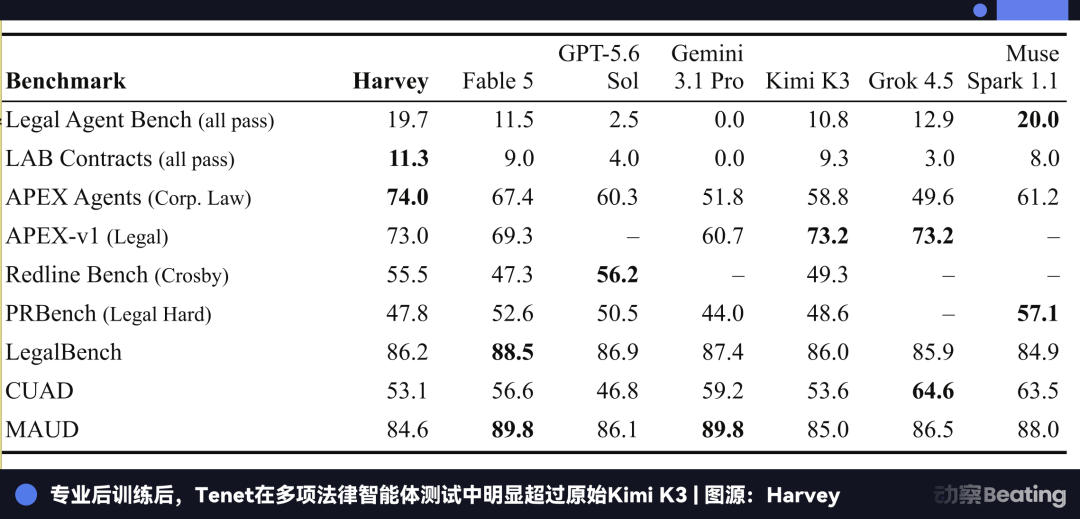
Tenet hatte keinen Kontakt mit Trainingsdaten aus diesen beiden Tests, die Leistungen liegen dennoch deutlich höher als beim ursprünglichen Kimi K3. Das zeigt: Die in Harvey-Task-Umgebungen trainierten Fähigkeiten lassen sich auf neue juristische Aufgaben übertragen.
Das Problem ist jedoch, dass nachträgliches Training Fachmodelle oft immer besser in einer bestimmten Art von Arbeit macht – und dabei einen Teil des ursprünglichen Wissens sowie der Schlussfolgerungs- und Argumentationsfähigkeiten wieder verliert.
Auf LegalBench, CUAD und MAUD gab es bei Tenet keine klaren Rückschritte. Beim Scale Professional Reasoning Benchmark konzentrierten sich die schwierigen Subtasks; dort stieg die Punktzahl sogar leicht von 36,0% auf 36,8%. Zumindest anhand dieser Ergebnisse zeigt sich: Nachdem Kimi K3 bei juristischen Aufgaben stärker wurde, trat kein deutliches Problem des „Capability Forgetting“ auf.
Harveys Belohnungsdesign bevorzugt bei ähnlicher Ergebnisqualität eher kürzere Trajektorien. Denn bei juristischen Agenten bedeutet jede zusätzliche Lektüre eines Dokuments und jeder zusätzliche Tool-Aufruf: mehr Token-Verbrauch und längere Wartezeit. Nach dem Training reduzierte Tenet einen Teil der ineffektiven Schritte. Während die Qualität der Aufgaben stieg, blieb die Kostenstruktur für die Erledigung der Arbeit im Wesentlichen stabil.
Das nachträgliche Training hat dieses Mal mehr verändert als nur Kleinigkeiten: vor allem den Umgang von Kimi K3 mit komplexen juristischen Aufgaben. Es plant Schritte besser, ruft Tools gezielter auf und lässt deutlich weniger zentrale Anforderungen in den Aufgaben aus.
Harvey begann bereits im Jahr 2025, Multi-Model-Strategien einzusetzen. Auch in diesem Jahr werden weiterhin neue Modelle von OpenAI und Anthropic integriert. Tenet sorgt schließlich in diesem System zum ersten Mal dafür, dass neben den bisherigen Modellen auch ein von Harvey selbst trainiertes und selbst kontrolliertes Open-Weight-Modell hinzugekommen ist.
Es braucht ein Fundament, das als Modell selbst schon „durchgeprüft“ ist. Harveys juristische Aufgaben müssen unter Umständen massenhaft Dokumente verarbeiten, Hunderte bis sogar Tausende Runden hintereinander ausführen, und das Modell muss während der langen Arbeit seinen Zustand beibehalten. Nachtraining kann weiterhin formen, wie es juristische Arbeit bewältigt; aber es kann kaum von Grund auf eine komplette Basiskompetenz „nachholen“, die das Fundament ursprünglich nicht mitgebracht hat.
Eine weitere Bedingung ist die Kontrolle. Harvey kann zwar per API GPT und Claude aufrufen, aber es kann die 1750 juristischen Task-Umgebungen und die Bewertungsmaßstäbe der Anwälte nicht weiter in diese Closed-Source-Modelle hineinschreiben. Open Weights erlauben es Harvey, selbst zu entscheiden, wie es trainiert und wie die Belohnungen gestaltet werden – und die daraus entstehenden professionellen Fähigkeiten im eigenen Satz Gewichte zu behalten.
Doch nachdem man die Gewichte bekommen hat, muss man außerdem prüfen, ob sich dieses Modell sinnvoll weiter trainieren lässt. Ob Long-Trajectory Reinforcement Learning stabil durchläuft, ob das Routing mit Misch-Experten die Verhältnisse genau replizieren kann, ob es nach der Verbesserung der Fachfähigkeiten dazu kommt, dass ursprüngliches Wissen verloren geht, und ob die Inferenzkosten noch im produktionsfähigen Rahmen kontrollierbar sind – all das muss man erst einmal wirklich ausprobieren, um es zu wissen.
Nachdem Tenet zwei Monate durchlief, lieferte Kimi K3 die Antwort für diese Runde. Der Trainingsprozess konnte stabil laufen, die Fähigkeit bei juristischen Aufgaben nahm deutlich zu. Es zeigte sich kein signifikantes „Capability Forgetting“, und die Kosten liefen auch nicht außer Kontrolle, selbst nicht bei spürbarem Effekt.
Für Harvey sind diese Ergebnisse wichtiger als „offene Gewichte“ an sich. Gewichte lassen sich herunterladen – das zeigt nur, dass ein Unternehmen berechtigt ist, weiter zu trainieren. Wie viel Fähigkeit nach dem Training wirklich übrig bleibt, entscheidet darüber, ob sich die weiteren Investitionen in Rechenleistung, Daten und Expertenzeit für dieses Modell lohnen.
Ein weiteres Geschäftsfeld der Modellfirma
Harvey sagt, das Ziel sei, dass Kanzleien auf offenen Gewichten eigene proprietäre Modelle trainieren können – und die Fähigkeiten, die sich nach dem Training daraus ergeben. Tenet sei weniger eine einzelne Modellvariante als vielmehr ein Vorgehen.
Früher fand das Geschäft der Basismodellfirmen vor allem bei den Aufrufen nach der Veröffentlichung des Modells statt. Open Weights bringen eine andere Beziehung: Eine Firma kann ein vorhandenes Basismodell aufnehmen und weiter trainieren, die Branchenkenntnis in die Gewichte einarbeiten und am Ende ein Modell erhalten, das näher an ihrem eigenen Geschäft ist.
Solche Anforderungen ließen sich früher nur schwer zu einem echten Markt machen. Wenn die allgemeinen Modellfähigkeiten nicht stark genug sind, ist es für vertikale Unternehmen – selbst wenn sie die Gewichte bekommen – kaum möglich, allein durch nachträgliches Training die Langzeit-Argumentation, den Tool-Einsatz und das Handling komplexer Aufgaben nachzurüsten. Von Grund auf selbst vortrainieren ist zudem zu teuer, und für die meisten Unternehmen gibt es dafür keinen Bedarf.
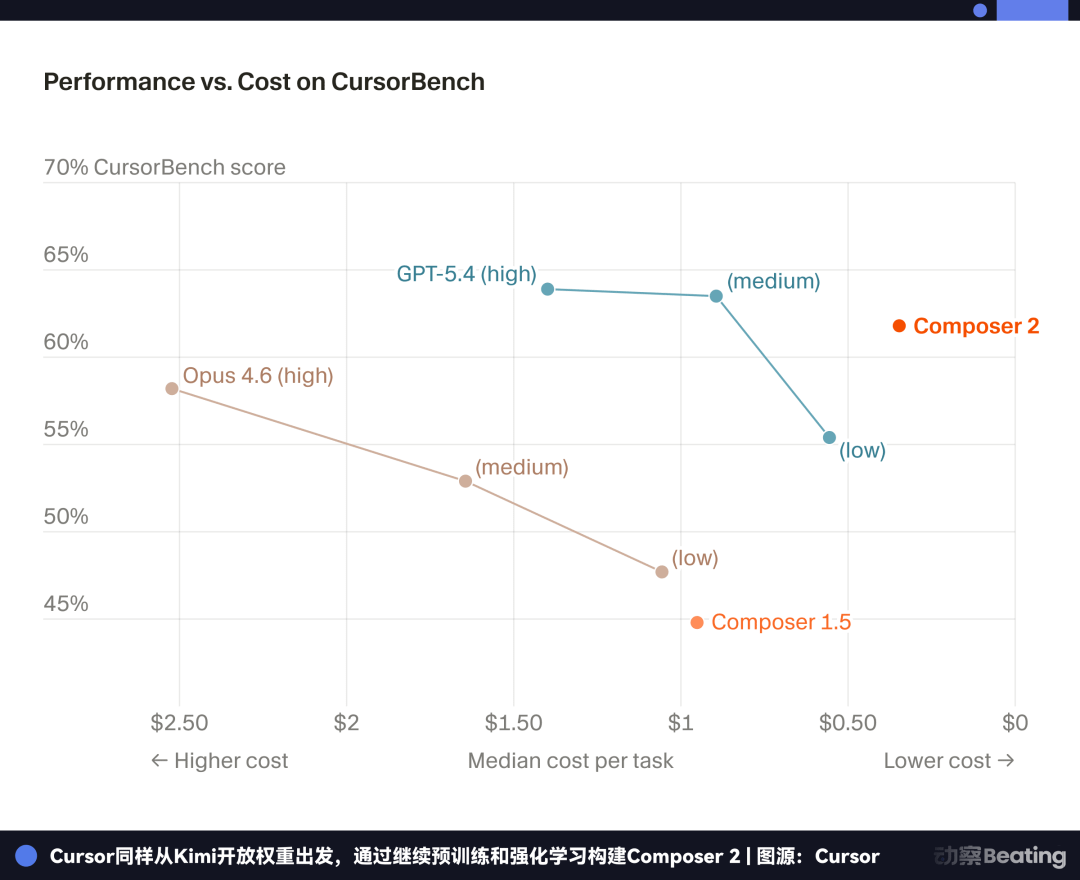
Cursor hat in der Programmierung Composer 2 trainiert; Cognition hat daraufhin auf denselben Gewichten weiter das Modell trainiert, das Devin nutzt. Und Harvey hat in der Juristerei Tenet umgesetzt. Programmierung und Recht liegen weit auseinander – beide haben jedoch den Weg gewählt, von den bereits bei Kimi trainierten allgemeinen Fähigkeiten auszugehen und die jeweils vertrauteste professionelle Arbeit anschließend weiter hineinzubauen.
Tenet macht diese Sache auch konkreter in Bezug auf die Hürde. Zwei Monate, etwa 150 Karten, plus ein Bewertungssystem, das von praktizierenden Juristen definiert wird – damit kann ein Unternehmen eine Reihe allgemeiner Gewichte bis zur Spitze der eigenen Branche bringen. Die Hürde bei der Rechenleistung ist bereits um eine Größenordnung gesunken; der schwerer replizierbare Teil beginnt auf der anderen Seite zu liegen: Wer kann überhaupt klar erklären, bis zu welchem Grad eine professionelle Arbeit als „fertig“ gilt?
Softwareentwicklung und Recht sind nur zwei Beispiele, die bereits sichtbar geworden sind. Finanzen, Beratung, Pharma, Buchhaltung und viele andere spezialisierte Servicebranchen haben jeweils ihre eigenen Daten, Workflows und Expertenurteile. Diese Branchen sind an sich schon ein Wissensarbeitsmarkt, gemessen in Billionen. Die ganz vorne stehenden Firmen trainieren ihre Basismodelle zwar nicht unbedingt selbst vor, haben aber zunehmend die Voraussetzungen, auf einem Satz ausgereifter Gewichte weiterzubauen und ihre eigenen Modelle weiterzu trainieren.
Wenn diese Route weiter Bestand hat, besteht der Markt, dem Kimi gegenübersteht, nicht mehr nur darin, wie viele Menschen es aufrufen. Als Nächstes ist vor allem zu beobachten, wie viele Unternehmen nach Harvey, Cursor und Devin wählen werden, eigene Modelle auf Kimi zu trainieren.
Link zum Originaltext