#dusk $DUSK @Dusk
Ich hätte fast auf den Reset-Button gegriffen, weil ein Dusk-Node aussah, als wäre er hängen geblieben.
Das wäre die falsche Lösung gewesen.
In der Werkstatt sind eine langsame Maschine und eine tote Maschine zwei völlig unterschiedliche Probleme. Die Node-Dokumentation von Dusk macht diese Unterscheidung genauso.
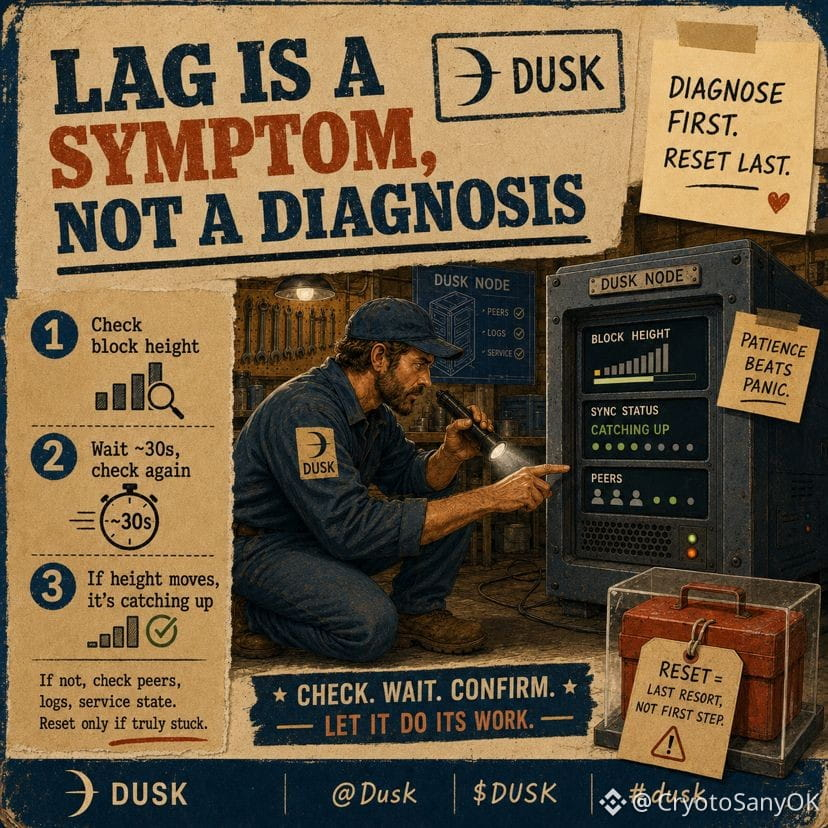
Wenn die Blockhöhe hinterherhinkt, aber dennoch weiter steigt, holt der Node möglicherweise einfach nur auf.
Bevor ich an den Zustand gehe, würde ich also eine langweilige, aber wichtige Prüfung machen:
Lese die Blockhöhe,
warte etwa 30 Sekunden,
der lese sie erneut.
Wenn sie sich bewegt hat, habe ich einen Hinweis auf Fortschritt.
Wenn nicht, beginne ich damit, Peers, Logs und den Service-Status zu prüfen.
Das ist wichtig, denn ein kompletter Reset ist kein harmloser „Noch mal probieren“-Button. Er löscht lokalen Zustand, Archivdaten, Wallet-Cache und Logs und zwingt den Node dann, erneut zu synchronisieren.
Also lautet meine Regel ganz einfach:
Verzögerung ist ein Symptom, keine Diagnose.
Lösche nicht die Beweise, bevor du nachgewiesen hast, dass der Node wirklich feststeckt.
Ich hätte fast auf den Reset-Button gegriffen, weil ein Dusk-Node aussah, als wäre er hängen geblieben.
Das wäre die falsche Lösung gewesen.
In der Werkstatt sind eine langsame Maschine und eine tote Maschine zwei völlig unterschiedliche Probleme. Die Node-Dokumentation von Dusk macht diese Unterscheidung genauso.
Wenn die Blockhöhe hinterherhinkt, aber dennoch weiter steigt, holt der Node möglicherweise einfach nur auf.
Bevor ich an den Zustand gehe, würde ich also eine langweilige, aber wichtige Prüfung machen:
Lese die Blockhöhe,
warte etwa 30 Sekunden,
der lese sie erneut.
Wenn sie sich bewegt hat, habe ich einen Hinweis auf Fortschritt.
Wenn nicht, beginne ich damit, Peers, Logs und den Service-Status zu prüfen.
Das ist wichtig, denn ein kompletter Reset ist kein harmloser „Noch mal probieren“-Button. Er löscht lokalen Zustand, Archivdaten, Wallet-Cache und Logs und zwingt den Node dann, erneut zu synchronisieren.
Also lautet meine Regel ganz einfach:
Verzögerung ist ein Symptom, keine Diagnose.
Lösche nicht die Beweise, bevor du nachgewiesen hast, dass der Node wirklich feststeckt.