


Originaltitel: (DeepSeek veröffentlicht ein Modell für visuelles Verständnis, und Augen wie die vom Großen Blauen Wal kommen zu spät)
Originalautor: 动察Beating
Am 21. August 2026 hat DeepSeek ein neues visuelles Verständnismodell, deepseek-v4-flash-vision-exp, vorgestellt; die Multi-Modal-API wurde offiziell freigegeben. Entwickler können zum ersten Mal Bilder direkt an die offiziellen Schnittstellen von DeepSeek übergeben.
Das Modell behält den 1-Million-Token-Kontext von V4 Flash und die maximale Ausgabe von 384.000 Token bei. Es unterstützt JSON Output, Tool Calls und die Responses API und ist zudem mit der Anthropic-API kompatibel.
Die Preise werden ebenfalls vollständig von V4 Flash übernommen. Für je 1 Million Token Eingabe, wenn der Cache nicht getroffen wird, in der Hauptverkehrszeit 3 Yuan, in der Randzeit 1,5 Yuan; wenn der Cache trifft, jeweils 0,1 Yuan und 0,05 Yuan. Für die Ausgabe: Hauptverkehrszeit 9 Yuan, Randzeit 4,5 Yuan. In Peking gilt täglich von 9 bis 12 Uhr sowie von 14 bis 18 Uhr als Hauptverkehrszeit; die übrigen 17 Stunden sind zum halben Preis.
Bilder werden ebenfalls nach Tokens abgerechnet. Vor dem Eintritt ins Modell wird jedes Bild automatisch entsprechend der Größe skaliert: Was kleiner als etwa 384×384 Pixel ist, wird hochskaliert, große Bilder werden auf ungefähr 800×800 Pixel bzw. auf eine Gesamtpixelzahl in dieser Größenordnung gedrückt. Ein einzelnes Bild kann maximal 384 Tokens belegen. Ein 2000×2000-Bild und ein 5000×5000-Bild können am Ende also möglicherweise genau dieselbe Token-Anzahl verbrauchen.
Gemäß dem Limit von 384 Tokens kostet ein Bild in der Hochlastphase und bei einem Cache-Miss für die Eingabe ungefähr 0,001152 Yuan. Wenn man tausend solcher Bilder verarbeitet, liegt der reine Bild-Eingabeanteil nur bei etwa 1,152 Yuan; Text und Modell-Ausgabe werden separat abgerechnet.
Mit live ging außerdem die Files API. Entwickler können Bilder im Voraus hochladen und dann die file_id in die Anfrage einsetzen. Für dasselbe Bild muss man es nur einmal übermitteln; danach kann man es in unterschiedlichen Anfragen wiederholt referenzieren. In einer einzelnen Anfrage können außerdem maximal 600 Bilder übergeben werden. Bei Verwendung externer Links oder Base64 liegt die Obergrenze für ein einzelnes Bild bei 32 MiB; nach dem Referenzieren via Files API kann sie auf 64 MiB steigen.
Diese API ist an sich kostenlos. Eine einzelne Datei hat maximal 64 MiB, und pro Nutzer können höchstens 25 GiB bzw. 10.000 Dateien gespeichert werden. Dateien können auf einen Ablauf zwischen 1 Stunde und 30 Tagen gesetzt werden; wenn keine Gültigkeitsdauer festgelegt wird, können sie dauerhaft erhalten bleiben. Aktuell stellt der offizielle Anbieter außerdem keine Schnittstelle bereit, um den Inhalt der Dateien herunterzuladen. Entwickler können jedoch hochladen, abfragen und löschen; das Modell kann sie lesen. Es ist eher ein kostenloses Bilderarchiv, das speziell für das Schließen von Schlussfolgerungen vorbereitet ist, nicht einfach ein gewöhnliches Cloud-Drive.
Aber das Merkwürdige daran ist nicht, dass DeepSeek erst bis heute Bilder sehen kann.
Zwei Zeitleisten
Wenn man nur auf die Forschung schaut, ist DeepSeeks Vision nicht wirklich spät dran.
Wenn man nur auf Produkt und API schaut, ist es in der Tat auch sehr viel zu spät.
Am 11. März 2024 wurde DeepSeek-VL Open Source gestellt.
Es gibt zwei Versionen, 1,3B und 7B. Es kann natürliche Bilder, Webseiten, Formeln, Diagramme und Dokumente verstehen. Im Oktober tauchte Janus auf und brachte Bildverständnis und -generierung in dasselbe autoregressive Framework. Am 13. November folgte JanusFlow. Im Dezember veröffentlichte DeepSeek-VL2 und wechselte zu einer Mixture-of-Experts-Architektur—die Gesamtparameterzahl wurde auf drei Stufen aufgeteilt: 3B, 16B und 27B.
Am frühen Morgen des 28. Januar 2025, zum Neujahrstag nach dem Mondkalender (Chinesisches Neujahr), wurde Janus-Pro Open Source. Das offizielle Repository verzeichnet es nach UTC auf den 27. Januar.
Die 7B-Version erreicht in GenEval bei der Aufgabe zur Bildgenerierung aus Text eine Befolgung der Instruktionen von 0,80 und liegt damit über dem im Paper angegebenen DALL-E 3-Wert von 0,67. Es gibt offene Gewichte, die man lokal bereitstellen kann, und zudem eine öffentliche Demo.
DeepSeek hat es nicht in seine eigene gehostete API eingebunden.
Nur eine Woche davor hatte R1 DeepSeek bereits ins Rampenlicht gerückt. Janus blieb bei GitHub und Hugging Face. Für die allermeisten normalen Nutzer verschwand es allerdings sehr schnell wieder aus dem Blickfeld.
Am 20. Oktober 2025 wurde DeepSeek-OCR Open Source gestellt—mit visuellen Token zur Komprimierung langer Dokumente. Am 27. Januar 2026 erschien OCR 2.
Wenn man ab DeepSeek-VL mitrechnet, lassen sich in den zwei Jahren mindestens sieben öffentlich dokumentierte Einträge finden: DeepSeek-VL, Janus, JanusFlow, VL2, Janus-Pro, OCR und OCR 2.
Die visuelle Forschung wurde schon immer gemacht und wurde auch immer nach außen gegeben.
Es war nur so, dass gewöhnliche Entwickler dieses Einstiegstor die ganze Zeit nicht hatten.
Auf der anderen Seite, bis März 2024, konnten die Entwickler-Schnittstellen mehrerer wichtiger Wettbewerber bereits Bilder entgegennehmen. OpenAI öffnete im November 2023 GPT-4 Turbo with Vision; Bilder konnten direkt in die Chat Completions API eingespeist werden. Einen Monat später ging Googles Gemini Pro Vision API live. Im März 2024 fügte Claude 3 in allen Varianten visuelle Fähigkeiten hinzu.
Am 25. April 2025 sagte Li Yanhong auf dem Baidu Create Summit: „DeepSeek ist auch nicht allmächtig.“ In den danach aufgelisteten Problemen gab es unter anderem eines, das die Modalität betrifft—nämlich, dass nur eine Modalität vorhanden ist.
Seine Einschätzung ist, dass Multimodal zum Standard für Basismodelle wird und der Markt für reine Textmodelle immer kleiner werden wird.
Damals hatte DeepSeek bereits ein Jahr lang visuelle Forschung betrieben.
In der Morgendämmerung
Am 7. und 8. April 2026 haben einige Nutzer DeepSeek geöffnet—plötzlich gab es in der Oberfläche drei zusätzliche Einstiegspunkte.
„Schnell“, „Experte“, „Vision“.
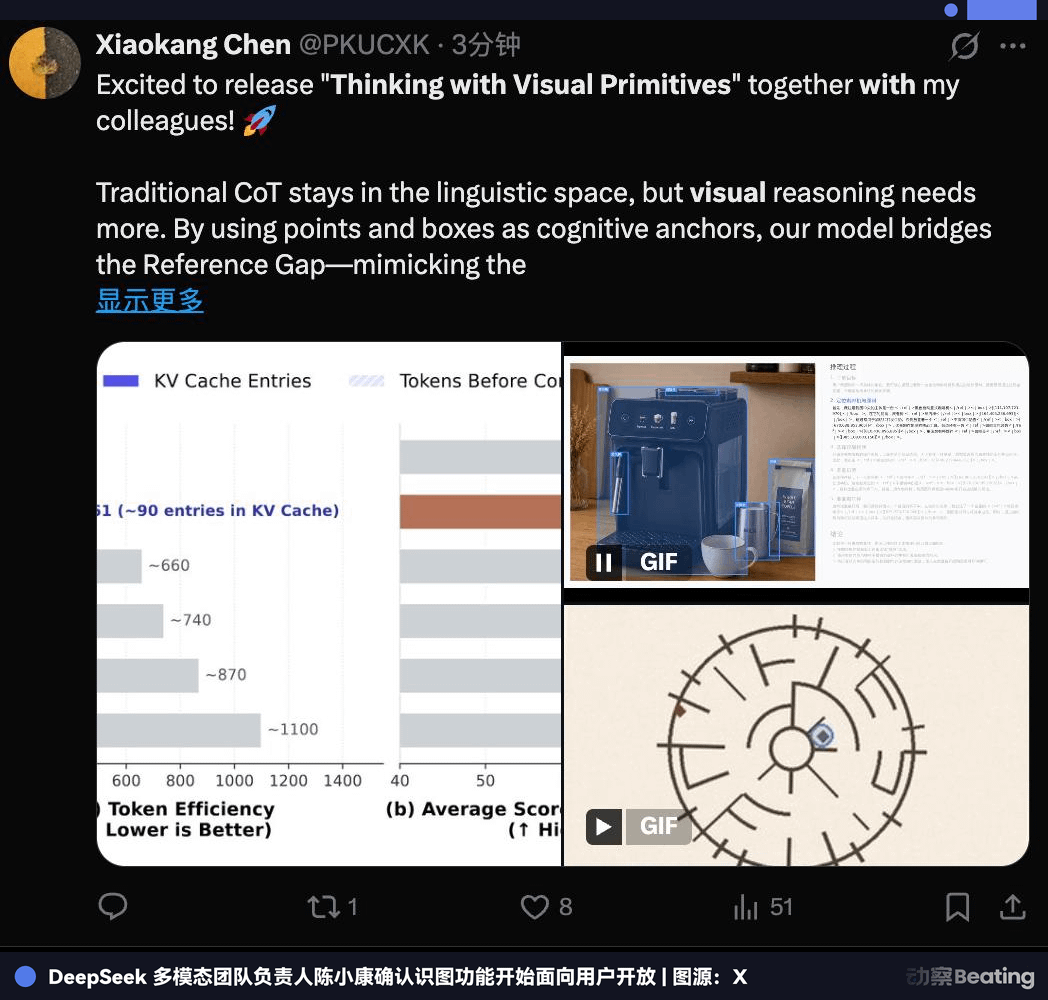
Am 29. April bestätigte Chen Xiaokang, Leiter des multimodalen Teams bei DeepSeek, dass die Funktion zum Erkennen von Bildern für einen Teil der Nutzer schrittweise eingeführt wird. Danach schrieb ein erfahrener Forscher bei DeepSeek: „Der kleine Wal kann jetzt sehen“. Die South China Morning Post setzte diesen Satz direkt in die Überschrift.
DeepSeeks Augen sind zum ersten Mal richtig aus der Produktoberfläche herausgekommen.
Am nächsten Tag stellte DeepSeek (Thinking with Visual Primitives) auf GitHub. Einige Stunden später wurden Repository und Paper wieder entfernt. Am 1. Mai war die ursprüngliche Adresse bereits 404. DeepSeek erklärte nichts; online blieben nur noch Paper-Spiegel und Medienzusammenfassungen.
Die Papierstudie befasst sich mit einem sehr konkreten Problem.
Wenn das Modell ein sehr überfülltes Bild sieht, weiß es oft, was es sagt—aber es kann nicht klar sagen, um welche konkrete Person oder um welche konkrete Linie es genau geht. Das Team hat Punktkoordinaten und Bounding Boxes direkt in den Schlussfolgerungsprozess eingefügt, sodass das Modell einerseits die Position zeigt und andererseits weiterdenkt.
Ein 756×756-Bild wird zuerst von einem visuellen Encoder in 2916 Bild-Token umgewandelt und dann durch eine 3×3-Raumkomprimierung auf 324 Token komprimiert. Die spärliche Attention von V4 Flash komprimiert den Cache weiter, sodass am Ende nur noch 81 visuelle KV-Einträge verbleiben.
Das Team hat außerdem für diese Methode mehr als 40 Millionen Trainingsbeispiele generiert, darunter Daten, die speziell für das Training von Labyrinth-Navigation und Pfadverfolgung gedacht waren.
Woran diese Arbeit mit viel Aufwand gearbeitet hat, ist im Grunde „wohin man zeigt“—also die Zielbestimmung.
Das Modell muss zuerst sehen und dann wissen, wo es gerade hinsieht. Nur so kann es die Schlussfolgerungen weiter vorantreiben.
DeepSeek hat dieses Mal nicht erklärt, ob Vision Exp die komplette Vision-Primitives-Lösung unverändert übernimmt. Noch wichtiger ist: Diese Forschung machte erstmals das Verständnis von DeepSeek für „visuelles Schließen“ nach außen sichtbar.
Am 18. Juni ging der Bild-Erkennungsmodus für Web und App offiziell live. Am nächsten Tag postete ein Medium einen Test mit Liang Wenfengs Foto—DeepSeek erkannte ihn zweimal hintereinander als Zhang Yiming. In einem anderen Gespräch erkannte es Zhang Yiming wiederum als Chen Tianshi, den Gründer von Cambrium.
Es kann bereits englische Screenshots lesen und Webseiten in Code umwandeln.
Aber als es vor die eigene Gesichtsfront kommt, erkennt es nicht einmal seinen eigenen Chef.
Am 19. August hinterließ DeepSeek Harness eine technisch präzise Datumsangabe. Offizielle Adapter konnten bereits Bildsequenzen zu image_url serialisieren; die Dokumentation stellte außerdem klar, dass das Standardmodellverzeichnis vorerst deepseek-v4-flash-vision-exp nicht anzeigen wird—man muss warten, bis die passenden API-Endpunkte verfügbar sind.
Am 20. August fanden außerdem Entwickler in einem Realtest: Wenn man dem noch nicht freigegebenen Modellnamen ein Bild zum Test sendet, bekommt man nur einen 400-Fehler.
Am 21. August wurde diese Einschränkung entfernt. Harness nahm deepseek-v4-flash-vision-exp in das Standardmodellverzeichnis auf; in dem dazugehörigen Merge-Commit stand direkt „publish the vision model“. Anschließend kündigten sowohl die offiziellen DeepSeek-API-Dokumente als auch der WeChat-Official-Account gleichzeitig an, dass Vision Exp live ist.
Erst jetzt trafen die beiden Linien endlich aufeinander.
Agent
In einer Audio-Transkription eines Investor-Meetings im Mai dieses Jahres stellte Liang Wenfeng seine AGI-Roadmap in mehrere Stufen dar: Sprachmodelle, Thought Chains, Agents, kontinuierliches Lernen, Selbstiteration—und schließlich verkörperte Intelligenz.
Multimodal platzierte er bei den Komponenten—ähnlich wie beim Search.
Wenn es um Videogenerierung geht, gibt es im Transkript einen Satz:
Geschäftlich gesehen ist es ein gutes Geschäft. Aber das hat nichts mit Intelligenz zu tun.
Seine Einschätzung lautet: Das Verhältnis zwischen Videogenerierung, Weltmodellen und dem aktuellen Stand der Intelligenz bzw. der intelligenten Obergrenze ist in dieser Phase nicht so entscheidend. Viel wichtiger sind jetzt das Training von KI und—nach dem Training—kontinuierliches Lernen.
Der Unterschied bei Multimodal ist, dass es zwar ebenfalls an den Platz der „Komponenten“ gesetzt wurde, DeepSeek aber ganz klar gesagt hat, dass es eine solche Komponente auch geben wird. Liang Wenfeng erwähnte damals außerdem, dass V4 und nachfolgende Versionen nativ Multimodal unterstützen würden.
In DeepSeeks Roadmap hatte Vision schon immer einen Platz—nur war es nicht ganz so weit vorne eingeordnet.
Wenn die Roadmap schließlich bis zum dritten Schritt Agent kommt, wird die Lage etwas anders.
DeepSeek hat nicht offen gesagt, dass diese Vision-API „nur für Agents“ live geht. Wenn man jedoch die Einschätzung von Liang Wenfeng zur Roadmap und die heutige Veröffentlichung zusammenbringt, lassen sich die beiden Linien kaum noch vollständig voneinander trennen.
Der Agent muss den Bildschirm lesen, Diagramme ansehen und Screenshots verarbeiten, die von Tools zurückgeworfen werden. Er kann nicht für immer in reinem Text leben. Diese visuellen Fähigkeiten, die schon zwei Jahre lang entwickelt wurden, sind schließlich—von Paper, Repository und Testseiten—bis hin zur API gereift.
Die drei Beispiele, die DeepSeek heute für Vision Exp zeigt, sind auch keine klassischen „Bild ansagen“-Szenarien: Ein Agent erstellt für einen Premium-Kunden eine PPT zur Tibet-Selbstfahrerreise, ein anderer gestaltet die DeepSeek-Harness-Website neu, und ein drittes erstellt ein Frontend-Demo mit dynamischen Effekten auf Basis visueller Vorgaben.
Sie alle brauchen, dass das Modell in langlaufenden Aufgaben visuelle Informationen wiederholt verarbeitet.
Auch das API-Design bewegt sich in diese Richtung. Die Responses API akzeptiert ebenfalls input_image; ein Browser-Agent kann nach dem Screenshot einer Webseite diesen erneut in die nächste Inferenzrunde einspeisen. Der Code-Agent kann Render-Ergebnisse prüfen; Diagramme, Scans und Software-Oberflächen können direkt zum Kontext werden.
Files API löst noch eine andere Sache: Ein und dasselbe Bild muss nicht in jeder Runde einer Anfrage wiederholt hochgeladen werden. Eine Datei kann dort langfristig liegen, und der Agent muss nur immer wieder die file_id übermitteln. In einer einzelnen Anfrage können außerdem maximal 600 Bilder untergebracht werden. Bei Nutzung externer Links oder Base64 liegt die Obergrenze für ein einzelnes Bild bei 32 MiB; nach dem Referenzieren über Files API kann sie auf 64 MiB steigen.
Das sieht inzwischen nicht mehr so aus, als wäre es nur eine „Bild hochladen“-Schaltfläche für das Chatfenster.
Es ist eher so, als würde man die Infrastruktur nachrüsten, die Agents brauchen, wenn sie visuelle Informationen verwenden.
Der Vergleich in vier Punkten, den DeepSeek für multimodale Agents veröffentlicht hat, bewertet außerdem nur selten im klassischen Sinn „Bilder anschauen und darüber reden“.
ApexBench konzentriert sich auf Langstreckenaufgaben wie Investmentbanken, Consulting und Recht. Agents' Last Exam basiert auf echten Arbeiten aus 55 Fachbereichen. Chartography testet speziell Kaplan-Meier-Kurven, Candlestick-/K-Linien, Konturlinien, Sankey-Diagramme und Streudiagramme/Börsen-Portfoliografiken. ZeroBench hingegen verwendet 100 künstlich entworfene schwierige Aufgaben, um mehrstufiges visuelles Schließen zu testen.
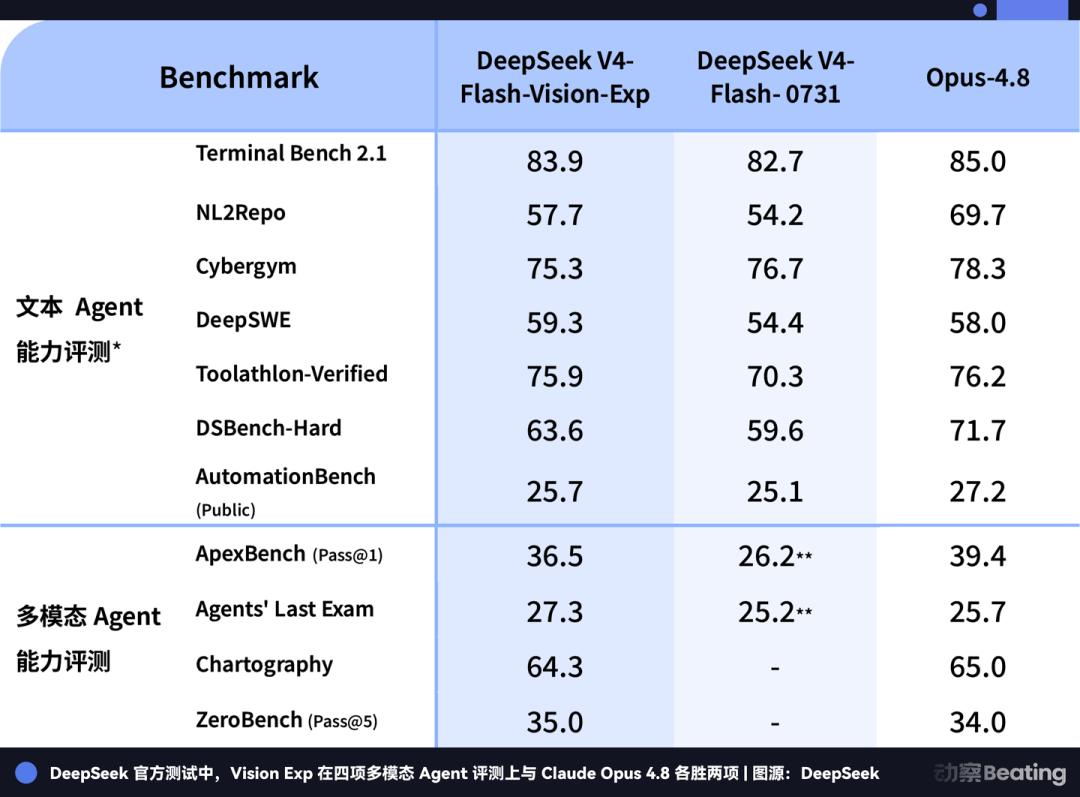
Vision Exp holt gegen Claude Opus 4.8 zwei Siege und zwei Niederlagen.
Agents' Last Exam liegt bei 27,3 zu 25,7; ZeroBench bei 35,0 zu 34,0. ApexBench bei 36,5 zu 39,4; Chartography bei 64,3 zu 65,0. In allen vier Bereichen beträgt der Abstand jeweils nicht mehr als 3 Punkte.
Noch interessanter ist: Mit zusätzlicher Vision sind die Fähigkeiten des ursprünglichen Text-Agent-Teils nicht eindeutig zurückgegangen.
Im detaillierten Vergleich mit dem reinen Text-V4 Flash, das am 31. Juli veröffentlicht wurde, zeigt die Website außerdem, dass alle fünf Text-Agent-Auswertungen für die jeweiligen Werte nach dem Wechsel gestiegen sind.
Terminal Bench 2.1 stieg von 82,7 auf 83,9; NL2Repo von 54,2 auf 57,7; DeepSWE von 54,4 auf 59,3; DSBench-Hard von 59,6 auf 63,6; AutomationBench von 25,1 auf 25,7. Auch DeepSWE mit 59,3 liegt über Opus 4.8 mit 58,0 in der Abbildung.
Allerdings stammen diese Zahlen aus den eigenen Tests von DeepSeek. Offiziell steht außerdem dabei, dass die DeepSeek-Modelle in den öffentlichen Code-Agent-Textaufgaben den DeepSeek Harness im Minimalmodus nutzen und der Inferenzmodus auf max gesetzt ist. Sie eignen sich eher dazu, die Veränderungen von Vision Exp gegenüber dem eigenen V4 Flash zu beobachten, nicht dazu, direkt als eigenständiges Dritt-Ranking zu gelten.
Der „exp“-Teil hinter dem Modellnamen wurde auch noch nicht entfernt.
DeepSeek hat es klar als experimentelles Modell markiert; die Versionen könnten sich weiterhin ändern. Die aktuellen Interfaces machen nur Bildverständnis; die Ausgabe bleibt Text. Bildgenerierung und Video wurden nicht geöffnet; die Files API akzeptiert auch nur JPEG, PNG, GIF und WebP—PDF kann man nicht direkt einfügen.
Im Jahr 2024 konnte der offizielle API noch nicht mit einer vom Entwickler gesendeten Bilddatei umgehen.
Am 21. August 2026 ist dieses Bild endlich angekommen.
DeepSeeks Augen sind tatsächlich spät aufgegangen.
Aber wenn es wirklich die Augen öffnet, ist der Weg davor bereits so, dass es nicht mehr mit geschlossenen Augen weitergehen kann.
Original-Link