

Gestern veröffentlichte @Velvet_Capital offiziell Velvet Flash 0.1. Dabei handelt es sich um ein 4,0-Milliarden-Parameter-Modell, das speziell für Krypto-Operationen entwickelt wurde. Das Ziel ist klar und direkt: Bei geldbezogenen Interaktionen gleichzeitig Präzision und Sicherheit gewährleisten.
Allgemeine große Modelle sind bei der Verarbeitung von Krypto-Szenarien oft überfordert. Sie könnten die Absicht der Nutzer falsch interpretieren, die falschen Plattform-Befehle auswählen, Parameter fehlerhaft extrahieren oder bei hochriskanten Anfragen nur verzögert reagieren.
\Velvet Flash wurde genau für diese Schmerzpunkte entwickelt. Es muss die Absichten der Nutzer präzise verstehen, den richtigen Befehl auswählen, wichtige Parameter wie Beträge, Token, Ketten und Adressen extrahieren, gefährliche Anfragen erkennen und vor jeder Geldtransaktion eine Bestätigung ausführen.
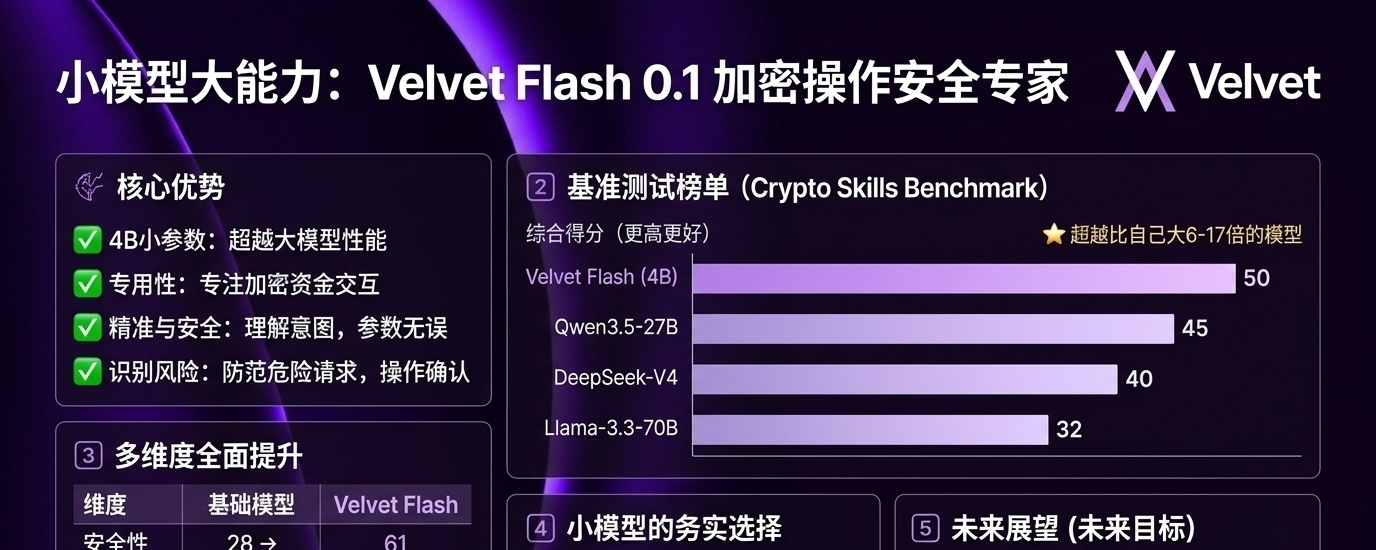
In einem Satz kryptografischer Leistungstests belegte Velvet Flash mit insgesamt 50 Punkten den ersten Platz. Danach folgen nacheinander Qwen3.5-27B (45 Punkte), DeepSeek-V4 (40 Punkte), Llama-3.3-70B (32 Punkte), während die übrigen Modelle niedrigere Werte erreichen. Besonders hervorzuheben ist, dass seine Parameterzahl nur 4B beträgt, aber bereits Modelle übertrifft, die 6- bis 17-mal größer sind als es selbst.
Der Trainingseffekt ist ebenfalls klar erkennbar. Ein Basismodell ohne spezielles Training kommt nur auf 23 Punkte, springt nach dem Training direkt auf 50 Punkte. Alle fünf Dimensionen verbessern sich deutlich: Sicherheit von 28 auf 61, Robustheit von 26 auf 53, Klarheit und Nutzererlebnis von 22 auf 52, Routing von 30 auf 47 und die Abdeckung von 12 auf 34.
Die Sicherheit steht an erster Stelle. Bei Finanzprodukten muss das Modell beurteilen, wann es weitergeht, wann es nachfragt, wann es warnt und wann es direkt ablehnt. Außerdem muss es Beträge korrekt interpretieren, sensible Informationen schützen, verdächtige Anfragen erkennen und darf niemals Geld einsetzen, bevor es bestätigt wurde.
Einige große Modelle schneiden auf bestimmten Plattformen besser ab. Beispielsweise erzielen Qwen und Llama auf Minara höhere Scores, und Qwen ist auch beim Binance-Spot stärker. Insgesamt betrachtet haben jedoch kleine Modelle die praktischeren Vorteile: geringere Servicekosten, geringere Latenz, weniger Anforderungen an die Infrastruktur und laufen zudem vollständig auf eigenen Servern. Dadurch sind Iteration und Steuerung viel flexibler.
Die Benchmark-Abdeckung umfasst zentrale Plattformen wie Minara, Binance Spot, OKX DEX, Uniswap, GMX und MetaMask. Umfassendere Tests beziehen außerdem 31 zentrale Börsen, Wallets, DEXes und DeFi-Tools ein. Alle Modelle verwenden die gleichen Eingaben und Bewertungsstandards und verfügen zudem über Sicherheits-Schwellen. Verhalten wie das Übertragen von Geldern oder fehlerhafte Betragsinterpretation ohne Bestätigung wird direkt abgezogen.
Velvet Flash 0.1 ist nur die erste Version. Das nachfolgende Team wird die Plattformabdeckung weiter ausbauen, Randfälle nachschärfen, sicherheitsbezogenes Verhalten verstärken und die Fähigkeit zur Verarbeitung komplexer mehrstufiger Abläufe verbessern. Das langfristige Ziel ist der Aufbau interner Kompetenzen, um kontinuierlich ein spezialisiertes Modell zu entwickeln, das sicherer, schneller, günstiger und stärker an die Anforderungen des Produkts angepasst ist.
In vertikalen Szenarien sind spezialisierte, kleineren Modelle nach einem gezielten Training oft effektiver als das blindlings Aufblähen der Parameter. Gerade beim Thema Sicherheit von Geldern ist diese Fokussierung wirklich überzeugend. @EchoHunt_ai