


Originaltitel: (DeepSeek verbindet sich mit Unitree: Wenn Intelligenz so billig wird, dass man sie verschwenden kann)
Originalautor: Dongcha Beating
Wie Technik die Welt wirklich verändert, passiert oft dann, wenn sie so billig geworden ist, dass man sie verschwenden kann.
Kürzlich haben sogar ausländische Medien angefangen, einen Begriff zu lernen, der sehr chinesisch ist: „Zhanxiaxian“ – die „Death Line“ zum Abwürgen/Erreichen der Grenze.
Am 31. Juli wurde DeepSeek V4 Flash aktualisiert. In der Abbildung von Artificial Analysis, die gleichzeitig die Modellintelligenz und die Nutzungskosten vergleicht, gilt: je weiter nach oben auf der y-Achse, desto schlauer das Modell; je weiter nach rechts auf der x-Achse, desto höher die Abrufkosten. Der Intelligence-Index von V4 Flash liegt bei 50 Punkten – bereits direkt an der globalen Spitzenliga. Die durchschnittlichen Kosten eines Testdurchlaufs liegen jedoch nur bei 3 Cent. Dieser Punkt wurde beinahe in die linke obere Ecke des Koordinatensystems gedrückt. Modelle, die günstiger sind, sind meist auch deutlich schwächer; Modelle, die schlauer sind, sind im Allgemeinen aber um eine ganze Stufe teurer.
Wenn ein Modell heute nicht deutlich stärker ist als DeepSeek, wird es immer schwieriger zu erklären, warum es das Dutzendfache so teuer sein soll. Das chinesische Internet nennt diese Grenze „Zhanxiaxian“. Ein paar Tage später nutzte auch Bloomberg in der Debatte über den Preisdruck, den chinesische Modelle auf US-KI-Unternehmen ausüben, in der Überschrift direkt den Begriff „Death Zone“.
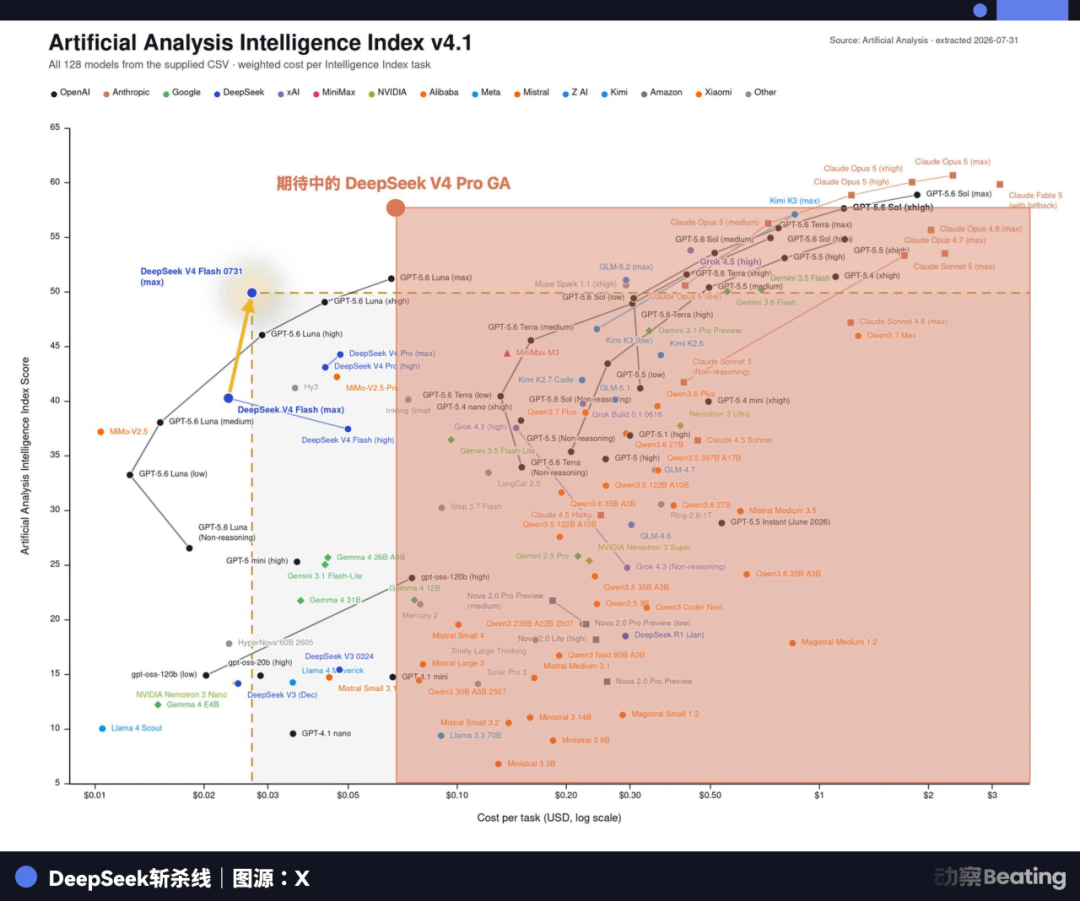
Seit V2 im Jahr 2024 drückt DeepSeek unaufhörlich die Kosten dafür nach unten, dass eine Maschine „einmal nachdenkt“. Je komplexer die Aufgaben werden, die das Modell bewältigen kann, desto weniger steigt der Preis – er explodiert nie mit der Leistungsfähigkeit. In den letzten zwei Jahren hat die Großmodellbranche den Fortschritt häufig über größere Parameter, längere Kontextfenster und höhere Benchmarks beschrieben. DeepSeek verfolgt jedoch seit jeher noch einen anderen Standard: dieselbe Intelligenz – aber weniger Kosten.
Auf der anderen Seite von Hangzhou machte Wang Xingxing seit mehr als zehn Jahren eine ähnliche Sache.
Als er noch im Studium war, machte er bei XDog – von Anfang an gab es nicht viel Geld, das man „verbrennen“ konnte. Man konnte das teure Hydrauliksystem nicht nutzen, also untersuchte man kostengünstigere Motoren. Reife Lösungen konnte man sich nicht kaufen, also zeichnete man Antriebsplatinen selbst, schrieb Programme und baute ein Steuerungssystem. Viele technische Entscheidungen, die heute bereits zu Unitrees Standardkomponenten gehören, entstanden zuerst aus einer sehr einfachen Ingenieur-Ge ist: erst nicht fragen, wie es die Branche normalerweise macht, sondern erst prüfen, ob es eine günstigere Lösung gibt.
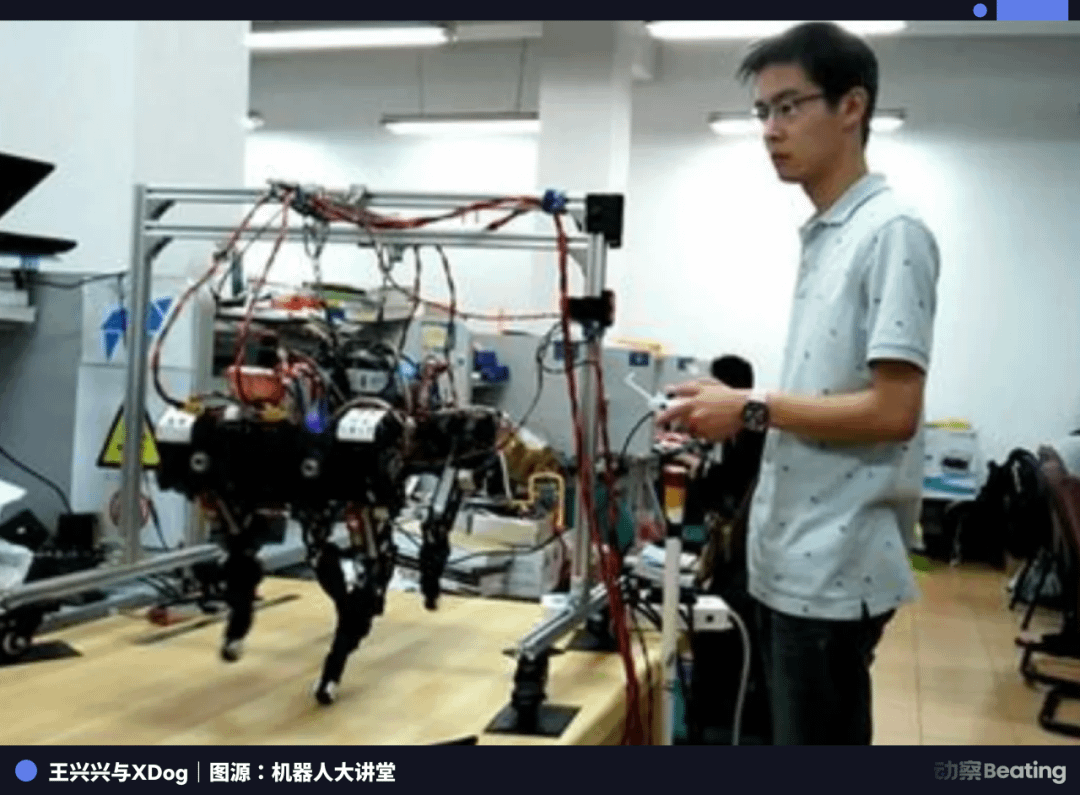
Später erinnerte sich Wang Xingxing: Als sie 2010 Zweibein-Roboter bauten, kosteten die mechanischen Teile zusammen nur 200 Yuan. Jahre später fragte man, ob Unitree die Kosten weiter senken könne. Er antwortete: „Vergleicht nicht unsere Kostensenkung mit der von uns. Wir können noch sehr viel weiter runtergehen.“
Eine Firma senkt die Preise für das Denken, eine andere senkt die Preise für das Handeln. Lange Zeit gingen sie zwar beide in Hangzhou ihren eigenen Weg, aber noch immer gingen sie getrennte Routen.
Bis zum 6. August.
Unitree Technology veröffentlichte die Ergebnisse der strategischen Zuteilung für die IPO im STAR Market. DeepSeek stellte 140,8 Mio. Yuan zur Zeichnung neuer Aktien von Unitree bereit. Auch die offen gelegten Kooperationsabsprachen sind ziemlich direkt: Wenn Unitree Modell-Trainingsdienstleistungen und technische Lösungen braucht, sollte DeepSeek bevorzugt werden; wenn DeepSeek Roboter benötigt und Anwendungen für verkörperte Intelligenz erforschen will, sollte Unitree bevorzugt werden.
Dieses Geld ist in die heutige KI-Branche gesteckt betrachtet noch nicht einmal besonders erstaunlich. Wirklich spannend ist, dass zwei Menschen, die seit über einem Jahrzehnt teure Technologien möglichst in Richtung Schnäppchenpreis drücken wollten, erstmals ihre eigenen Kostenkurven miteinander verbunden haben. So tauchte eine Frage auf, die noch lohnender ist als: „Ein Großmodell verbindet endlich einen Roboter mit einem Körper“:
Wenn die Kosten dafür, dass Maschinen denken, und die Kosten dafür, dass Maschinen handeln, beide weiter sinken, wie würde KI am Ende aussehen?
Die Antwort könnte nicht nur lauten: „Mehr Menschen können es sich leisten.“
Noch größere Veränderung: Wir fangen an, nicht mehr so kostbar damit umzugehen.
Zwei Preis-Metzger
Das Ähnlichste an Liang Wenfeng und Wang Xingxing ist, dass sie beide nicht so recht daran glauben, dass „billig durch Subventionen“ langfristig funktioniert. Die Preisliste kann man natürlich über Nacht ändern – aber das Wolle, das man vom Schaf geholt hat, wächst nicht aus dem Nichts. Solche Niedrigpreise halten gewöhnlich nicht lange. Wenn etwas wirklich langfristig billig verkauft werden soll, muss man am Ende zurück ins Engineering: Diese Kosten, die bisher selbstverständlich existierten, Stück für Stück abbauen.
DeepSeek-V2 ist das typischste Beispiel. Nachdem 2024 das Modell veröffentlicht wurde, wurde die inländische Großmodellbranche sehr schnell in einen Preiskampf hineingezogen. Von außen sieht man am leichtesten die API-Preisgestaltung – doch das, was eine Senkung wirklich tragen kann, steckt im Modellaufbau verborgen. V2 erreicht 236 Milliarden Gesamtparameter; pro Token werden in der Praxis nur 21 Milliarden aktiviert. Im Vergleich zur vorherigen Generation sanken die Trainingskosten um 42,5 %, der KV-Cache um 93,3 %, und die maximale Generation-Throughput stieg auf das 5,76-Fache.
Mit V3 wurde dieser Ansatz weitergedacht. Das Modell wurde größer: Das offizielle Training verbrauchte 2,788 Mio. H800-GPU-Stunden. DeepSeek optimierte dann die Effizienz erneut durch Mixture-of-Experts, Training mit niedriger Präzision und Kommunikationsoptimierung.
Dieser Blick auf die Kosten hat später sogar angefangen, Produkte umgekehrt zu definieren.
Im Mai dieses Jahres wandelte DeepSeek einen ursprünglich nur zu 75 % rabattierten V4-Pro-Förderpreis direkt in einen dauerhaften Preis um, und auch die Flaggschiff-Stufe wurde weiter nach unten gedrückt. Liang Wenfeng hatte zuvor die Preislogik erklärt: nach realen Kosten kalkulieren, nicht dauerhaft draufzahlen, und auch nicht auf übermäßigen Profit aus sein.
Wang Xingxings Verständnis von Robotern ist im Grunde genauso.
Bei einem Interview, das sie 2025 (später) annahmen, wurde gefragt: H1 wurde damals für 90.000 US-Dollar verkauft. Später wurde die flexiblere G1 Low-End-Variante angeboten – der Einstiegspreis liegt nur noch bei 99.000 Yuan. Rechnet sich das überhaupt noch?
Wang Xingxing antwortete: „Unternehmenshandlungen müssen auf jeden Fall einen angemessenen Unternehmensgewinn haben. Kosten sind das KPI für alles, was wir machen. Der Kern ist: Geld verdienen.“
Was er danach außerdem sagte, hatte kaum noch etwas mit dem üblichen Satz zu tun: „Wenn man erst in die Skalierung kommt, senkt der Lieferant von selbst die Preise.“ Was wirklich die Untergrenze für den Roboterpreis bestimmt, sind: wie man den Motor auswählt, wie man das Getriebe gestaltet, wie viele Teile ein Gelenk braucht, ob das Gesamtsystem noch leichter werden kann und welche Komponenten man unbedingt in eigener Hand behalten muss.
Diese Art der Kostensenkung hat eine sehr starke „Industriezeit“-Anmutung: Einen Pfennig in zwei Hälften spalten und beide ausgeben.
Wenige Zentimeter weniger bei einer Leiterplatte, zwei Teile weniger bei einem Gelenk, ein Kabelbaum, der einen anderen Weg ermöglicht – einzeln genommen ist das keine große Durchbruchmeldung. Aber wenn man dutzende solcher Änderungen stapelt, wirkt es am Ende direkt auf den Verkaufspreis.
Genau so sahen die Preisentwicklungen von Unitree in den letzten Jahren aus. 2023 kam der erste H1 in voller Größe auf den Markt – verkauft wurden nur 5 Stück, der durchschnittliche Verkaufspreis lag bei 593.400 Yuan. 2024 trat das kleinere G1 in den Markt ein: Die Stückzahlen stiegen auf 410, der durchschnittliche Preis fiel auf 260.700 Yuan. Bis Ende 2025, in den ersten neun Monaten, erreichten die Absatzzahlen humanoider Roboter 3.551 Stück, der durchschnittliche Preis sank erneut auf 167.600 Yuan.
Jeder Preisrutsch um eine Stufe nach unten bedeutet, dass Käufer von Robotern eine neue Welle erhalten. Geräte für fünfzig bis sechzigtausend Yuan brauchen ein Projektbudget im Labor, müssen eingeplant und begründet werden – man muss erklären, was man damit eigentlich untersuchen will. Geräte im Bereich von Zehntausenden Yuan können dagegen schon in mehr Hochschulen, Entwicklungsteams und Unternehmen gelangen.
Viele technische Entwicklungen überschreiten ihren Verbreitungs-Punkt genau in dieser Art von Veränderung. Vom Sonderbudget wird es zum Budget eines Fachbereichs, vom Fachbereichsbudget zur normalen Beschaffung. Und irgendwann an einem bestimmten Tag rechnet niemand mehr für jede einzelne Nutzung nach.
Teure Technologien sind von Natur aus nur dafür geeignet, teure Probleme zu lösen. Wenn die Preise fallen, beginnen jene Kleinigkeiten, die früher überhaupt nicht wert waren, dass Technik auf den Plan kommt, erst jetzt in ihre Welt einzutreten.
Zwei Kostenkurven treffen endlich aufeinander
Unitree arbeitet bereits selbst an Weltmodellen und VLA. Daher besteht der Wert von DeepSeek nicht nur darin, Robotern „ein Gehirn anzuschließen“. Was die beiden Unternehmen wirklich ineinandergreifen lässt, ist der derzeit teuerste Trainingszyklus für verkörperte Intelligenz.
Diese Schleife passiert zur Hälfte in der realen Welt. Der Roboter greift wirklich, geht wirklich, holt wirklich etwas. Menschen oder andere Systeme geben ihm fortlaufend Vorführungen – daraus entstehen erfolgreiche und gescheiterte Trajektorien.
Die andere Hälfte passiert im Rechnen. Daten werden gereinigt, gelabelt, in ein Modelltraining überführt, neue Strategien werden erlernt. Danach werden sie durch Inferenz und Validierung erneut an den Roboter zurückgespielt. Der Roboter geht raus, probiert weiter, bringt neue Daten mit – das Modell lernt noch einmal. Je schneller diese Schleife rotiert, desto mehr von der Welt trifft der Roboter.
Das Problem ist: Es ist an beiden Enden teuer. Ein echtes Gerät ist teuer, wodurch man es schwer schafft, dass Hunderte Roboter Tag für Tag im Labor herumstürzen. Und wenn Training und Inferenz teuer sind, lassen sich jene Daten, deren Wert man auf den ersten Blick nicht erkennt, ebenfalls nicht beliebig oft trainieren und verifizieren.
So waren Roboterexperimente in der Vergangenheit immer so wertvoll. Es gab nur ein paar Maschinen – also musste man sich im Voraus überlegen, welche Daten man heute sammelt. Rechenleistung gab es nur in begrenzter Menge – ob sich eine Charge Trajektorien noch einmal lohnt, musste man mit den Fingern abzählen. Je teurer die Ressourcen sind, desto eher wählen Forschende Fragen, die scheinbar am wertvollsten sind und die höchste Erfolgswahrscheinlichkeit haben.
Doch ausgerechnet die Realität ist nun mal nicht so.
Worin liegt der Unterschied, ob ein Becher 3 Zentimeter oder 5 Zentimeter vom Tischrand entfernt steht? Wo greift man hin, wenn das Handtuch nur halb nass ist? Wenn eine Schublade klemmt: übt man weiter Druck aus oder zieht man erst ein Stück zurück? Wie richtet man den Arm aus, wenn man in einem Plastiksack einen Apfel und in einem anderen drei Äpfel verstaut? Für sich genommen ist keine dieser Dinge es wert, eine Pressekonferenz abzuhalten – geschweige denn lohnt sich sogar ein eigenes Projekt im Labor. Doch sobald Roboter in ein Zuhause, ein Restaurant, ein Lager oder ein Büro einziehen, besteht die Welt, der sie jeden Tag gegenüberstehen, genau aus solchen lästigen Kleinigkeiten.
Wenn man jetzt DeepSeek und Unitree zusammen betrachtet, wird die Logik sehr klar.
Unitree drückt die Kosten für den ersten Teil nach unten – damit mehr echte Roboter ins Labor, in die Entwicklungsteams und in reale Szenarien gelangen. DeepSeek löst langfristig den zweiten Teil: das Training, die Inferenz und die Validierung der Modelle werden immer günstiger.
Die meisten Trajektorien landen am Ende nicht im Produkt, die meisten Experimente werden auch keine Nachrichten. Manche Roboter greifen hundertmal hintereinander den falschen Becher – eine Reihe teurer Datenläufe kann am Ende sogar nur beweisen, dass die ursprüngliche Idee von Anfang an nicht stimmte.
Wenn Ressourcen teuer sind, werden diese Dinge „weggeworfen“; wenn die Kosten niedrig genug sind, haben sie das Recht, als „Erfahrung“ bezeichnet zu werden.
Wenn Smartphones ein bisschen billiger sind, können mehr Menschen sie kaufen. Wenn Roboter ein bisschen billiger sind, heißt das außerdem, dass sie selbst mehr Zeit besitzen können, in der sie keine Produktionsergebnisse liefern müssen: im Labor einen Nachmittag lang üben, Bewegungen ausprobieren, die am Ende vielleicht gar nicht gebraucht werden, in mehr seltsame Umgebungen gehen und mehr Situationen begegnen, an die Ingenieure vorher nicht gedacht haben.
Wenn Körper und Intelligenz gleichzeitig billiger werden, bekommt die verkörperte Intelligenz zuerst die Berechtigung für mehr Fehler.
Wie haben Menschen gelernt, Technik zu verschwenden?
Solche Dinge sind in der Geschichte menschlicher Technologie schon oft passiert.
Im Jahr 1865 entdeckte der britische Ökonom William Stanley Jevons bei seinen Forschungen über Dampfmaschinen und Kohle etwas Unintuitives: Je effizienter eine Dampfmaschine wurde, desto weniger Kohle brauchte man, um eine Arbeit zu erledigen. In England sank aber der Kohleverbrauch nicht, sondern stieg sogar. Denn sobald Dampfenergie billiger wird, beginnen die Dinge wieder verwendet zu werden, die man vorher aus Scham/Geiz nicht einsetzen wollte. Die Kohle, die man durch Effizienz gespart hatte, wurde bald von immer mehr neuen Anforderungen „aufgefressen“.
Später nannte man dieses Phänomen „Jevons-Paradox“.
Wer in den letzten zwei Jahren KI genutzt hat, hat diese andere Phase im Grunde schon erlebt. Als Modelle noch teuer waren, hatten wir zuerst gelernt, wie man Intelligenz spart. Startups diskutieren zwar auf der Oberfläche über die Nutzererfahrung – aber Produktmanager mussten innerlich trotzdem eine Preisliste für Tokens im Kopf behalten. Ein Feature, das technisch machbar ist, könnte am Ende dennoch gestrichen werden, weil „es zu teuer ist, dass jeder Nutzer das Modell fünfmal mehr laufen lassen muss“.
Doch wenn die Technik wirklich ins Leben einzieht, muss sie meist noch eine andere Hürde nehmen: Sie wird so billig, dass wir anfangen, sie für Dinge zu verwenden, die nicht ganz so wichtig sind.
Heute rechnet niemand aus, wie viel wirtschaftlichen Wert diese eine Stunde Beleuchtung im Wohnzimmer schafft, bevor er die Lampe einschaltet. Und niemand findet es Verschwendung, wenn ein Smartphone im Hintergrund ein paar zusätzliche Netzwerkanfragen sendet – und niemand denkt dabei an die große Internet-Infrastruktur, die dadurch „ausgeplündert“ wird.
Strom und Netzwerk haben Kosten. Nur ist diese Art von Kosten mittlerweile so niedrig, dass es nicht mehr lohnt, für jede einzelne Nutzung eine Entscheidung zu treffen. Die Menschen sind bei solchen Dingen längst grob und verschwenderisch geworden – und ohne jede Schuldgefühle.
Wenn Intelligenz eines Tages wirklich hier ankommt, wird sich auch unsere Beziehung zu KI verändern. Sitzung vorbei, im Handumdrehen das Modell etwas ordnen lassen; wenn ein Artikel fertig ist, sollen mehrere Modelle jeweils Fehler finden; wenn ein Agent es nicht geschafft hat, werden ein paar Pfade gewechselt und weiter getestet – erst wird mit/ohne „Belege“ drei Schüsse abgegeben. Der Roboter räumt den Tisch auf: Beim ersten Mal kippt er die Tasse um, beim zweiten Mal greift die Hand schief, beim dritten Mal ist die Bewegung zu langsam – dann kommt der vierte Versuch.
Wenn sich eine Technologie erst wirklich durchsetzt, werden Menschen nicht immer ernster damit rechnen, wie effizient sie eingesetzt wird. Sogar der Mensch vergisst, dass er sie gerade verwendet.
Bis wir anfangen, diese Rechnung nicht mehr zu machen
Im Jahr 1911 schrieb der britische Mathematiker und Philosoph Alfred North Whitehead in (Einführung in die Mathematik) einen Satz:
„Der Fortschritt der Zivilisation liegt darin, dass wir immer mehr wichtige Operationen ausführen können, ohne nachdenken zu müssen.“
Heute ist die KI offensichtlich noch nicht so weit. Wir diskutieren immer noch, welcher Auftrag es wert ist, mit dem teuersten Modell gemacht zu werden. Entwickler wechseln nicht selten den Anbieter, nur weil ein paar Yuan Unterschied pro Million Tokens bestehen. Und Roboterfirmen müssen zwischen Ausstellungsraum, Labor und Fabrik dasjenige Szenario finden, das sich am leichtesten durchrechnen lässt. Diese Branche trägt immer noch stark diesen Geruch von „Alltag mit Hähnchen, Reis und Öl“.
Und genau diese Investition von 140,8 Mio. Yuan verbindet am Ende das Ganze miteinander – mit einer Rechnung, die in Diskussionen der Branche bisher selten auftauchte: Was kostet ein einmaliger Fehler der Maschine wirklich?
Heute ist diese Antwort noch nicht billig genug. Also müssen jede echte Welt-Datenserie sorgfältig gesammelt werden, jede Trainingsrunde muss abgewogen und selektiert werden, und jede einzelne Robotermaschine sollte so schnell wie möglich eine Aufgabe finden, aus der sich Ergebnisse ableiten lassen.
Wenn der Tag kommt, an dem Intelligenz wirklich verbreitet ist, wird es vielleicht keine Pressekonferenz geben, die das Anbrechen einer neuen Ära verkündet. Wir werden nur langsam merken, dass es niemanden mehr interessiert, wenn ein Roboter in einer Ecke im Lager einen Nachmittag lang Kisten greifen übt und dreihundertmal scheitert. Auch wenn ein Agent, um eine Antwort zu finden, dutzende Pfade selbst ausprobiert und niemand mehr auf die Token-Abrechnung starrt und dabei Mitleid mit den Kosten hat. Und im Labor braucht man einfach nicht mehr für jedes Gerät einzeln eine Einkaufsbegründung zu schreiben.
Darum könnten die wirklich entscheidenden Preise für die Zukunft von KI gar nicht sein, wie teuer exakt eine Million Tokens sind, oder wie teuer exakt ein humanoider Roboter ist. Sondern: Wann wir endlich zu faul sind, diese Zahlen überhaupt noch auszurechnen.
Wenn Maschinen schon ein paar Mal mehr nachdenken, ein paar Schritte mehr gehen und ein paar Mal mehr Fehler machen, bis es nicht mehr wehtut, Menschen zu kümmern, dann wird Intelligenz wirklich von einer teuren Fähigkeit zur Basisinfrastruktur.
Wie Technik die Welt wirklich verändert, passiert oft dann, wenn sie so billig geworden ist, dass man sie verschwenden kann.
DeepSeek bringt das Denken näher an diesen Preis heran, Unitree bringt den Körper näher an diesen Preis. Der Rest ist: dafür zu sorgen, dass Maschinen ein ganzes Leben lang so billig sind, dass man sie kaum noch anpreist.
So billig, dass man es immer wieder ausprobieren kann. So billig, dass man ständig Fehler machen kann. So billig, dass jene heute noch sinnlosen Fehlschläge endlich so zahlreich werden, dass sie genug „Intelligenz“ zusammenbauen.
Original-Link