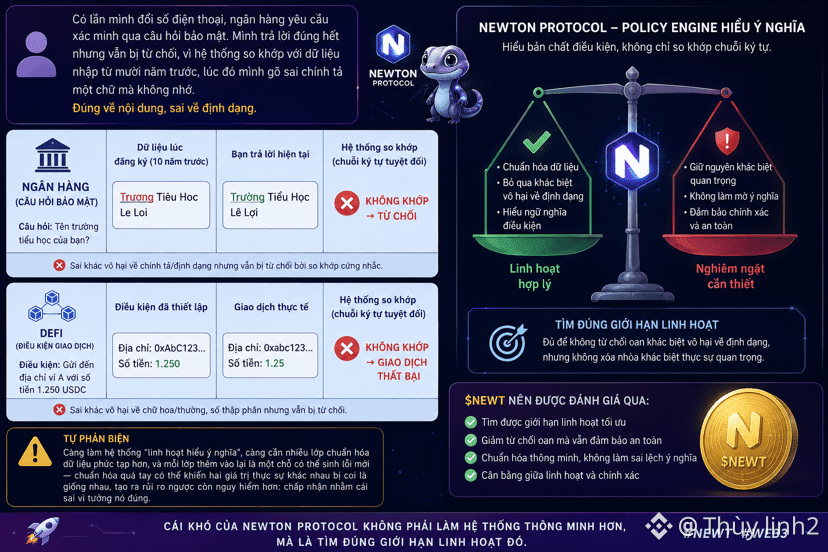
Einmal habe ich meine Telefonnummer geändert, und die Bank verlangte eine Verifizierung per Sicherheitsfrage. Ich habe alles korrekt beantwortet, aber trotzdem wurde ich abgelehnt, weil das System mit den Daten abgleicht, die vor zehn Jahren eingegeben wurden. Damals hatte ich bei einem einzigen Buchstaben einen Tippfehler, den ich nicht mehr wusste. Inhaltlich richtig, aber formal falsch – und das System unterscheidet die beiden Fehlerarten nicht.
DeFi verwechselt das Ganze genauso – eine Wallet-Adresse in Groß- und Kleinschreibung unterscheidet sich, eine Zahl wird gerundet und stimmt nicht exakt mit den Dezimalstellen überein; beides kann dazu führen, dass eine Bedingung, die inhaltlich eigentlich erfüllt wäre, als nicht übereinstimmend gilt, nur weil stattdessen ein exakter String-Abgleich vorgenommen wird, statt die Bedeutung zu verstehen.
@NewtonProtocol Wenn man einen Policy-Engine baut, die die Bedeutung von Bedingungen versteht und nicht nur starr Strings vergleicht, könnte man viele Fälle dieser Art von unberechtigten Ablehnungen reduzieren.
Selbstkritik: Aber je „intelligenter“ man das System macht, um Bedeutungen zu verstehen, desto mehr komplexe Daten-Validierungs- und Normalisierungsschichten braucht man – und jede zusätzliche Schicht ist wiederum eine neue Fehlerquelle. Zu viel Normierung kann sogar dazu führen, dass zwei tatsächlich unterschiedliche Werte als gleich behandelt werden und damit ein umgekehrtes Risiko entsteht, das genauso gefährlich ist: den Fehler fälschlich zu akzeptieren, weil man ihn für richtig hält.
Die Schwierigkeit von @NewtonProtocol besteht nicht darin, das System klüger zu machen, sondern die richtige Grenze für Flexibilität zu finden – genug, um andere Formunterschiede, die harmlos sind, nicht pauschal abzulehnen, aber ohne dabei auch die tatsächlich wichtigen Unterschiede zu verwischen.
$NEWT Daher sollte man daran gemessen werden, wo diese Grenze gefunden wird – nicht nur daran, ob Technologien für semantisches Verstehen eingesetzt werden oder nicht.
#newt $LAB $SAROS