
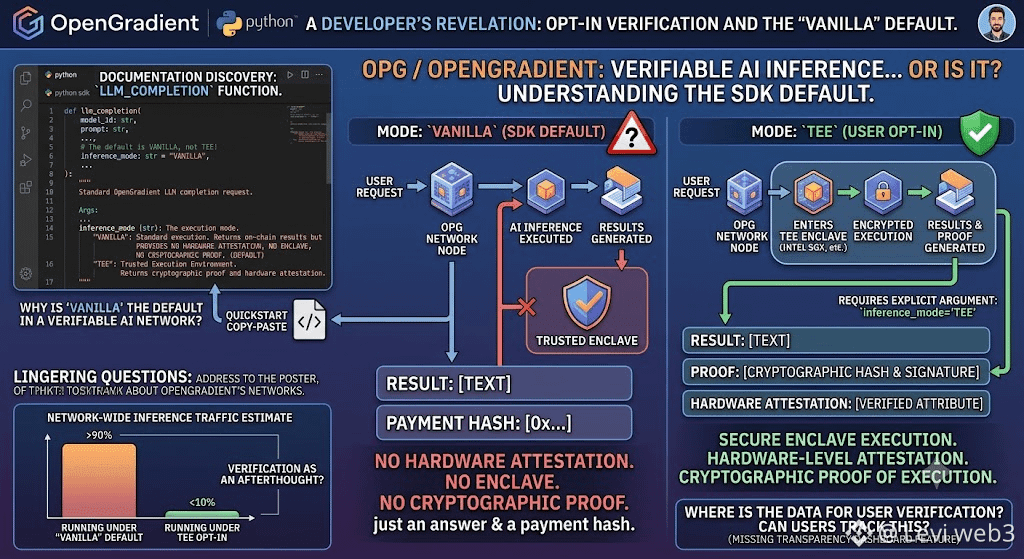
Ich habe das OpenGradient ($OPG , #OPG ) Python SDK-Handbuch durchsucht und erwartet, dass die Verifikation das zentrale Feature ist, mit dem die Projektleitung wirbt — @OpenGradient rahmt sein Netzwerk so ein, wie es von Grund auf für überprüfbare KI-Inferenz entworfen wurde. Die Funktion für die LLM-Vervollständigung nimmt ein Argument inference_mode mit zwei Optionen entgegen: VANILLA oder TEE, wobei der in der Funktionssignatur angegebene Standard VANILLA ist. Die Dokumentation beschreibt diesen Standard ganz offen: Standardausführung, die On-Chain-Ergebnisse zurückgibt, aber keine Hardware-Attestierung bietet. Kein Enklave, kein kryptografischer Ausführungsnachweis — nur eine Antwort und ein Payment-Hash. Um die Garantie zu bekommen, auf die die Vision tatsächlich ausgerichtet ist, muss eine Entwickler*in explizit TEE als Argument übergeben; andernfalls läuft jeder Aufruf in dem Modus, den die Dokumentation selbst als das Überspringen dieses Schritts beschreibt. Es ist ein einzelnes Schlüsselwort in einem Funktionsaufruf — leicht zu übersehen, wenn man ein Quickstart-Beispiel kopiert — und es kehrt die Reihenfolge stillschweigend um, mit der ich gerechnet habe: Verifikation liest sich wie das Fundament, wird aber als etwas ausgeliefert, das man erst nachträglich auswählt. Ich frage mich ständig, welcher Anteil des Inferenz-Traffics im Netzwerk tatsächlich unter dem nicht attestierten Standard läuft, und ob diese Zahl irgendwo auftaucht, wo eine Nutzer*in sie überprüfen könnte.

Veröffentlichen
Haftungsausschluss: Enthält Meinungen von Drittanbietern. Keine Beratung. Binance AI wird ohne Gewähr bereitgestellt. Siehe AGB.