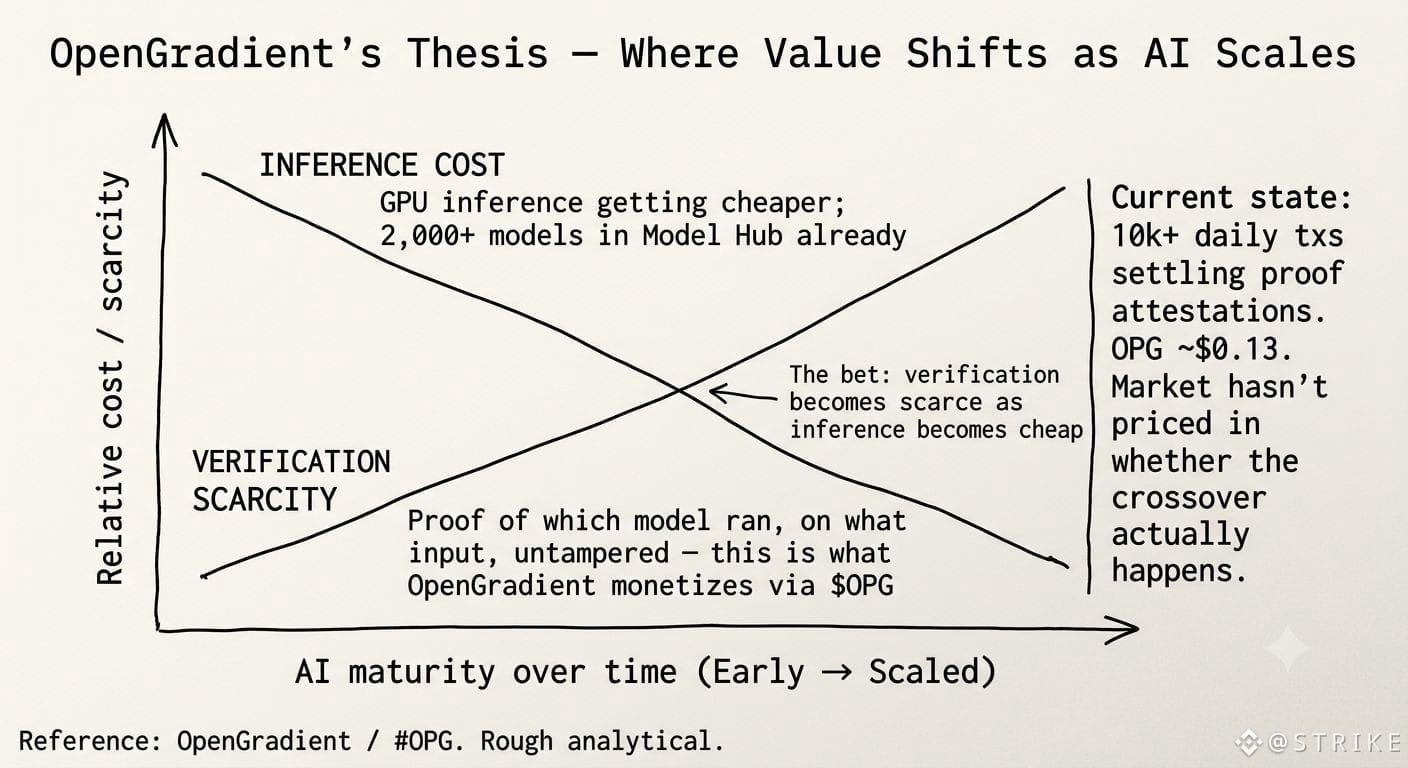
Etwas hat mich während dieser Aufgabe aufgehalten – kein Feature, sondern eine Rahmung. @OpenGradient hat diese Woche gepostet: „Wenn Intelligenz billig wird, wird Verifikation zur knappen Ressource.“ Das ist tatsächlich die These hinter dem Fokus von OpenGradient auf Verifikationsschichten. Nicht nur, weil KI-Ausgaben gefälscht werden können. Sondern weil sich Inferenz zunehmend verbilligt und das, wofür man zahlen sollte, sich verschiebt. $OPG #OPG
In der Praxis bildet sich das direkt in der Art ab, wie das Netzwerk aufgebaut ist. Die Proof-Verification-Layer existiert unabhängig von der Ausführung – genau deshalb, weil Ausführung bereits billig und schnell wird: die GPU-Kosten fallen, Modelle vermehren sich, 2.000+ sind bereits in der Model Hub. Was weiterhin teuer und schwierig bleibt, ist zu wissen, ob das richtige Modell auf die richtige Eingabe lief und eine unmanipulierte Ausgabe erzeugte. Genau um diese Schicht baut OpenGradient wirtschaftliche Anreize auf – mit inzwischen 10.000+ täglichen Transaktionen auf seiner eigenen Chain, die jetzt Proof-Attestierungen als Evidenz zur Verfügung stellen.
Ich will ehrlich sein: Ich habe einen Teil dieser Aufgabe skeptisch erlebt. Es liest sich eher wie eine stimmige Erzählung als wie eine nachgewiesene Bedarfs-Kurve. Günstige Inferenz plus teure Verifikation … funktioniert hervorragend, wenn der Markt tatsächlich anfängt, für Entscheidungen in hoher Tragweite eine Proof-of-Inference zu verlangen. Unklarer wird es, wenn die meisten Entwickler weiterhin mit Vanilla-API-Aufrufen ausliefern und das Vertrauensrisiko selbst abfangen.
Worauf OpenGradient setzt, ist, dass der Verifikationsbedarf mit der Skalierung der KI-Implementierung wächst. Und wir wissen noch nicht wirklich, ob das stimmt.
In der Praxis bildet sich das direkt in der Art ab, wie das Netzwerk aufgebaut ist. Die Proof-Verification-Layer existiert unabhängig von der Ausführung – genau deshalb, weil Ausführung bereits billig und schnell wird: die GPU-Kosten fallen, Modelle vermehren sich, 2.000+ sind bereits in der Model Hub. Was weiterhin teuer und schwierig bleibt, ist zu wissen, ob das richtige Modell auf die richtige Eingabe lief und eine unmanipulierte Ausgabe erzeugte. Genau um diese Schicht baut OpenGradient wirtschaftliche Anreize auf – mit inzwischen 10.000+ täglichen Transaktionen auf seiner eigenen Chain, die jetzt Proof-Attestierungen als Evidenz zur Verfügung stellen.
Ich will ehrlich sein: Ich habe einen Teil dieser Aufgabe skeptisch erlebt. Es liest sich eher wie eine stimmige Erzählung als wie eine nachgewiesene Bedarfs-Kurve. Günstige Inferenz plus teure Verifikation … funktioniert hervorragend, wenn der Markt tatsächlich anfängt, für Entscheidungen in hoher Tragweite eine Proof-of-Inference zu verlangen. Unklarer wird es, wenn die meisten Entwickler weiterhin mit Vanilla-API-Aufrufen ausliefern und das Vertrauensrisiko selbst abfangen.
Worauf OpenGradient setzt, ist, dass der Verifikationsbedarf mit der Skalierung der KI-Implementierung wächst. Und wir wissen noch nicht wirklich, ob das stimmt.