Wir alle haben das Muster gesehen.
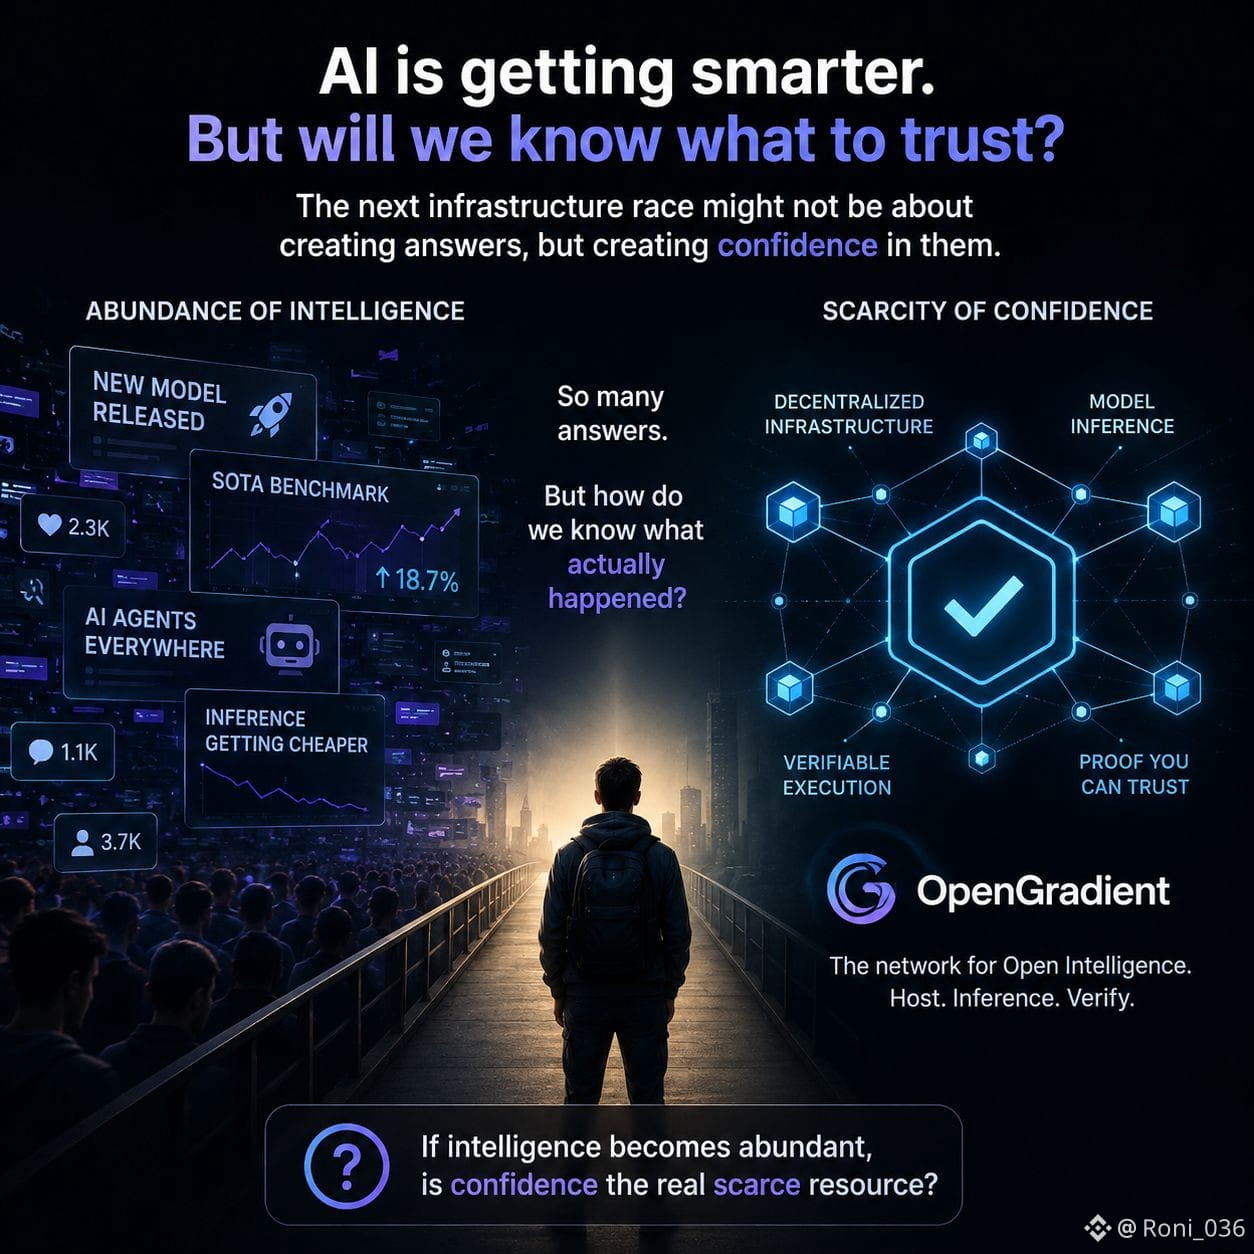
Ein neues KI-Modell wird veröffentlicht, in den sozialen Medien füllen sich die Feeds mit Benchmark-Diagrammen, Trader beginnen über Gewinner und Verlierer zu diskutieren, und Investoren versuchen herauszufinden, welcher Teil des KI-Stacks am Ende den größten Wert abschöpft.
Die übliche Schlussfolgerung ist ziemlich einfach: Die klügsten Modelle gewinnen.
Eine Zeit lang habe ich das genauso gesehen.
Aber je länger ich darüber nachdenke, desto mehr frage ich mich, ob Intelligenz überhaupt nur die halbe Geschichte ist.
Stell dir eine Welt ein, ein paar Jahre in der Zukunft, in der KI-Modelle überall sind. Inferenz ist günstig, das Bereitstellen von Modellen ist unkompliziert, und neue Versionen erscheinen schneller, als irgendjemand Schritt halten kann. Zu diesem Zeitpunkt könnte es womöglich gar nicht schwer sein, Intelligenz zu finden.
Wissenswert wäre dann vor allem, wem man vertrauen kann.
Deshalb haben Projekte wie @OpenGradient meine Aufmerksamkeit erregt – nicht weil sie KI leistungsfähiger machen, sondern weil sie mich über ein anderes Problem nachdenken lassen. In einer Zukunft voller maschinengenerierter Ausgaben: Wie werden Nutzer, Unternehmen und Märkte verifizieren können, was tatsächlich hinter den Kulissen passiert ist?
Wenn Intelligenz reichlich vorhanden wird, könnte Vertrauen zur knappen Ressource werden.
Und wenn Vertrauen zur knappen Ressource wird: Verbringen wir dann zu viel Zeit damit, die Modellleistung zu messen, und zu wenig damit, den Beleg zu messen?
#opg $OPG @OpenGradient