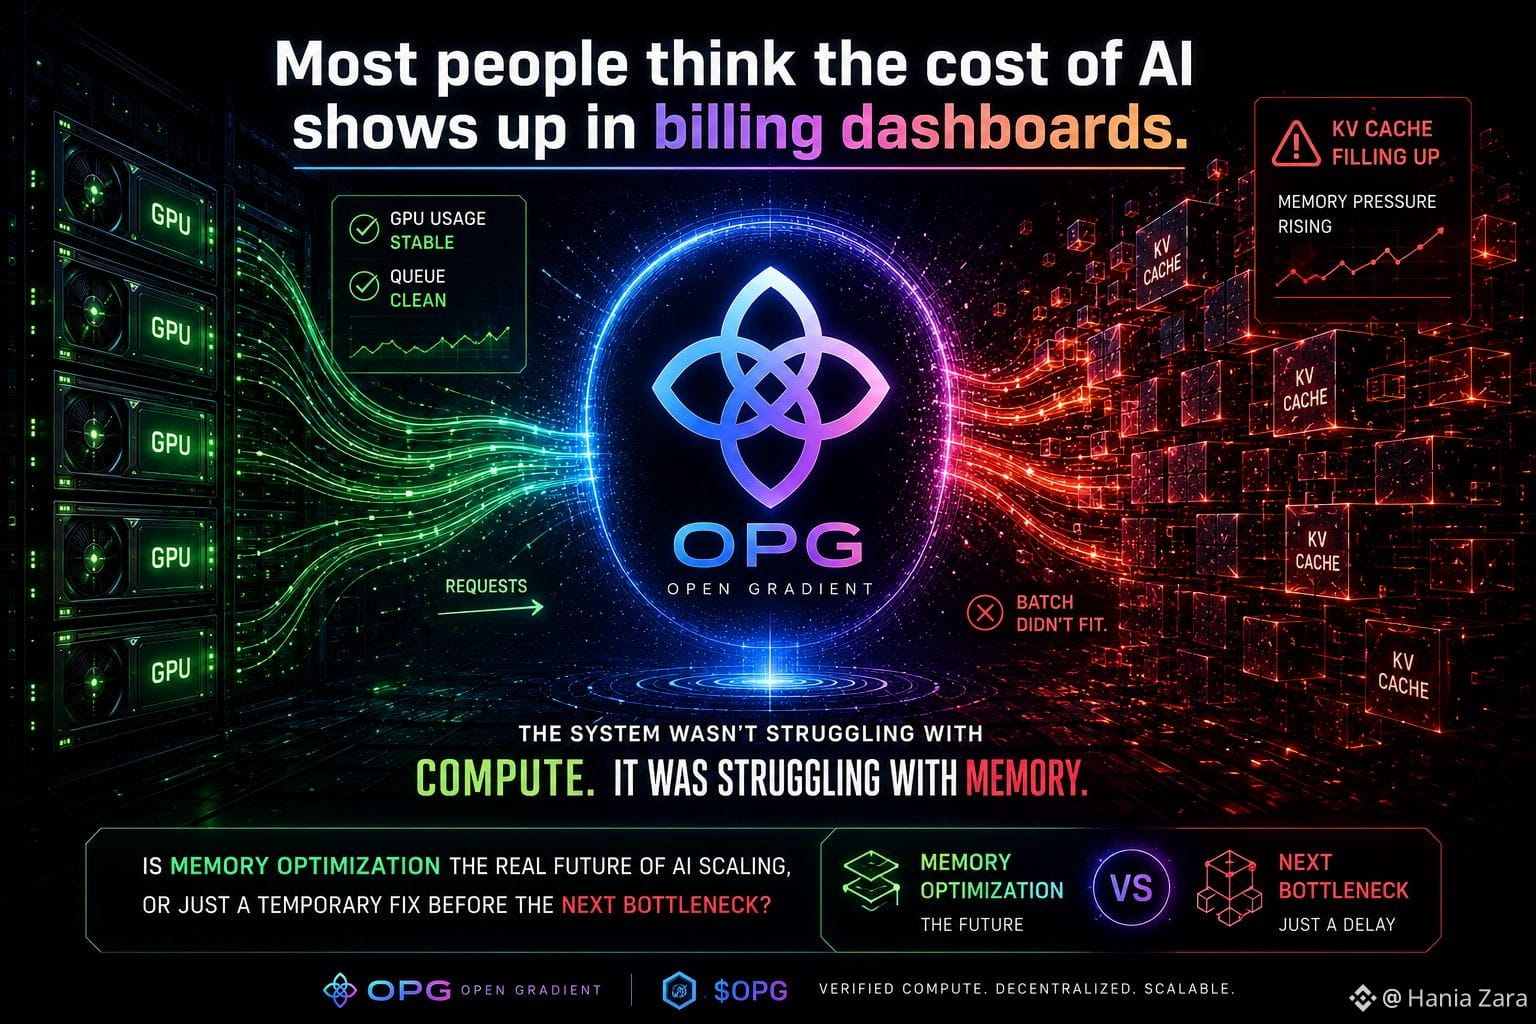
Die meisten Leute denken, die Kosten für KI zeigen sich in Abrechnungs-Dashboards.
Aber ganz ehrlich… das ist nicht der Punkt, an dem man es wirklich spürt.
Das erste Mal, als ich es bemerkte, sah alles perfekt aus – GPU-Nutzung stabil, Queue sauber, nichts Alarmierendes.
Aber ein Batch passte trotzdem nicht.
Und da wurde mir klar… das System hatte nicht mit der Rechenleistung zu kämpfen.
Es hatte mit dem Speicher zu kämpfen.
Lange Prompts hielten still KV-Cache wie temporären Speicher, der sich nie vollständig freigibt – was langsam reduziert, wie viel das System tatsächlich verarbeiten kann.
Das paging-basierte KV-Cache-Management versucht, dies zu beheben, indem es den Speicher in kleinere wiederverwendbare Seiten aufteilt. Mehr Anfragen passen, lange Gespräche werden nicht sofort zum Engpass.
Aber hier ist die echte Debatte:
Reicht das aus für die Zukunft von KI-Systemen wie OpenGradient Chat (https://chat.opengradient.ai)?
Oder verzögern wir nur den nächsten Engpass?
Denn skalierte verifizierte Rechenleistung mit $OPG ist nicht mehr nur ein Leistungsproblem… es ist ein Architekturproblem.
Was denkst du:
👉 Ist die Speicheroptimierung die wirkliche Zukunft der KI-Skalierung oder nur ein temporärer Fix?
@OpenGradient
#opengradientchat
#OPG
$OPG
Aber ganz ehrlich… das ist nicht der Punkt, an dem man es wirklich spürt.
Das erste Mal, als ich es bemerkte, sah alles perfekt aus – GPU-Nutzung stabil, Queue sauber, nichts Alarmierendes.
Aber ein Batch passte trotzdem nicht.
Und da wurde mir klar… das System hatte nicht mit der Rechenleistung zu kämpfen.
Es hatte mit dem Speicher zu kämpfen.
Lange Prompts hielten still KV-Cache wie temporären Speicher, der sich nie vollständig freigibt – was langsam reduziert, wie viel das System tatsächlich verarbeiten kann.
Das paging-basierte KV-Cache-Management versucht, dies zu beheben, indem es den Speicher in kleinere wiederverwendbare Seiten aufteilt. Mehr Anfragen passen, lange Gespräche werden nicht sofort zum Engpass.
Aber hier ist die echte Debatte:
Reicht das aus für die Zukunft von KI-Systemen wie OpenGradient Chat (https://chat.opengradient.ai)?
Oder verzögern wir nur den nächsten Engpass?
Denn skalierte verifizierte Rechenleistung mit $OPG ist nicht mehr nur ein Leistungsproblem… es ist ein Architekturproblem.
Was denkst du:
👉 Ist die Speicheroptimierung die wirkliche Zukunft der KI-Skalierung oder nur ein temporärer Fix?
@OpenGradient
#opengradientchat
#OPG
$OPG