

Speicher ist kein Kostenstellenposten, sondern das Wertzuweisungssystem des Bitroot AI Stack. Viele Teams merken erst nach mehr als einem halben Jahr im Produktbetrieb, dass man diese Speicherschicht damals viel sorgfältiger hätte auswählen müssen. Die Daten sind nicht verloren gegangen, der Service lief weiter—doch das Problem taucht auf eine andere Weise wieder auf: Abgerufenes Trainingsmaterial aus dem Archiv wird immer langsamer, die Tail-Latenz bei Hot-Vector-Queries schwankt von Millisekunden- auf Sekundenebene. Und wenn dann eine Online-Störung rekonstruiert werden soll, kann niemand mehr klar sagen, welche Version der Trainingsdaten das Modell damals verwendet hat. Ab diesem Punkt geht es nicht mehr nur ums Skalieren, sondern um drei deutlich schwierigere Fragen: Wer kann nachweisen, dass die Daten dauerhaft verfügbar sind? Wer trägt die Verantwortung für die Version? Und wer zahlt für die langfristigen Kosten?
Verstehe Storage als das Verschieben von Dateien von einem zentralisierten Cloud-Setup ins Off-Chain-Netzwerk. In der Ära von NFT-Metadaten kann diese Denkweise noch tragen. Sobald das Geschäft auf KI-Trainingskorpora, Modellgewichte und Vektorindizes erweitert wird, wird diese Idee schnell unbrauchbar.
Viele Teams betrachten Storage bislang als eine Wartungskostenposition, die man so weit wie möglich reduziert. Genau das ist der Teil, der am stärksten unterschätzt wird und am leichtesten in die falsche Wahl mündet: In einer KI-Blockchain ist Storage in Wahrheit die Wertverteilungs-Schicht, die entscheidet, wer Daten kontrolliert und wer welchen Anteil am Ertrag erhält. Dieser Artikel beantwortet eine einzige Frage: Wie baut man in einem Szenario, in dem KI und öffentliche Chains zusammenkommen, eine verifizierbare, governbare und nachhaltige verteilte Storage-Lösung? Im Folgenden werden zuerst die Fähigkeiten von drei gängigen Paradigmen auseinandergebaut, danach die besonderen Herausforderungen für KI-Daten erklärt und am Ende in eine umsetzbare Architektur mit fünf Schichten sowie die Voraussetzungen für einen rollierenden, schrittweisen Rollout gegossen. Die Bewertungsgrundlage basiert hauptsächlich auf offiziellen Protokolldokumenten und möglichst auf verifizierbaren Materialien.
Am Beispiel Bitroot ist die genauere Positionierung der Storage-Schicht die Value-Distribution-Basis im AI-Stack. Bitroot bietet einerseits durch parallelisiertes EVM und Pipeline BFT eine leistungsstarke On-Chain-Ausführungsumgebung; andererseits verbindet Bitroot über verteiltes Training, Inferenznetzwerke, Trusted Execution und AI-Asset-Management Daten, Modelle, Rechenleistung und Agent-Anwendungen zu einem abrechenbaren Netzwerk. In diesem Netzwerk ist Storage kein isoliertes Modul, sondern die Infrastruktur, die bestimmt, ob Daten eindeutig zugewiesen werden können, ob Modelle reproduzierbar sind, ob Rechenleistung abgerechnet werden kann und ob Beitragsleistende dauerhaft Erträge erhalten.
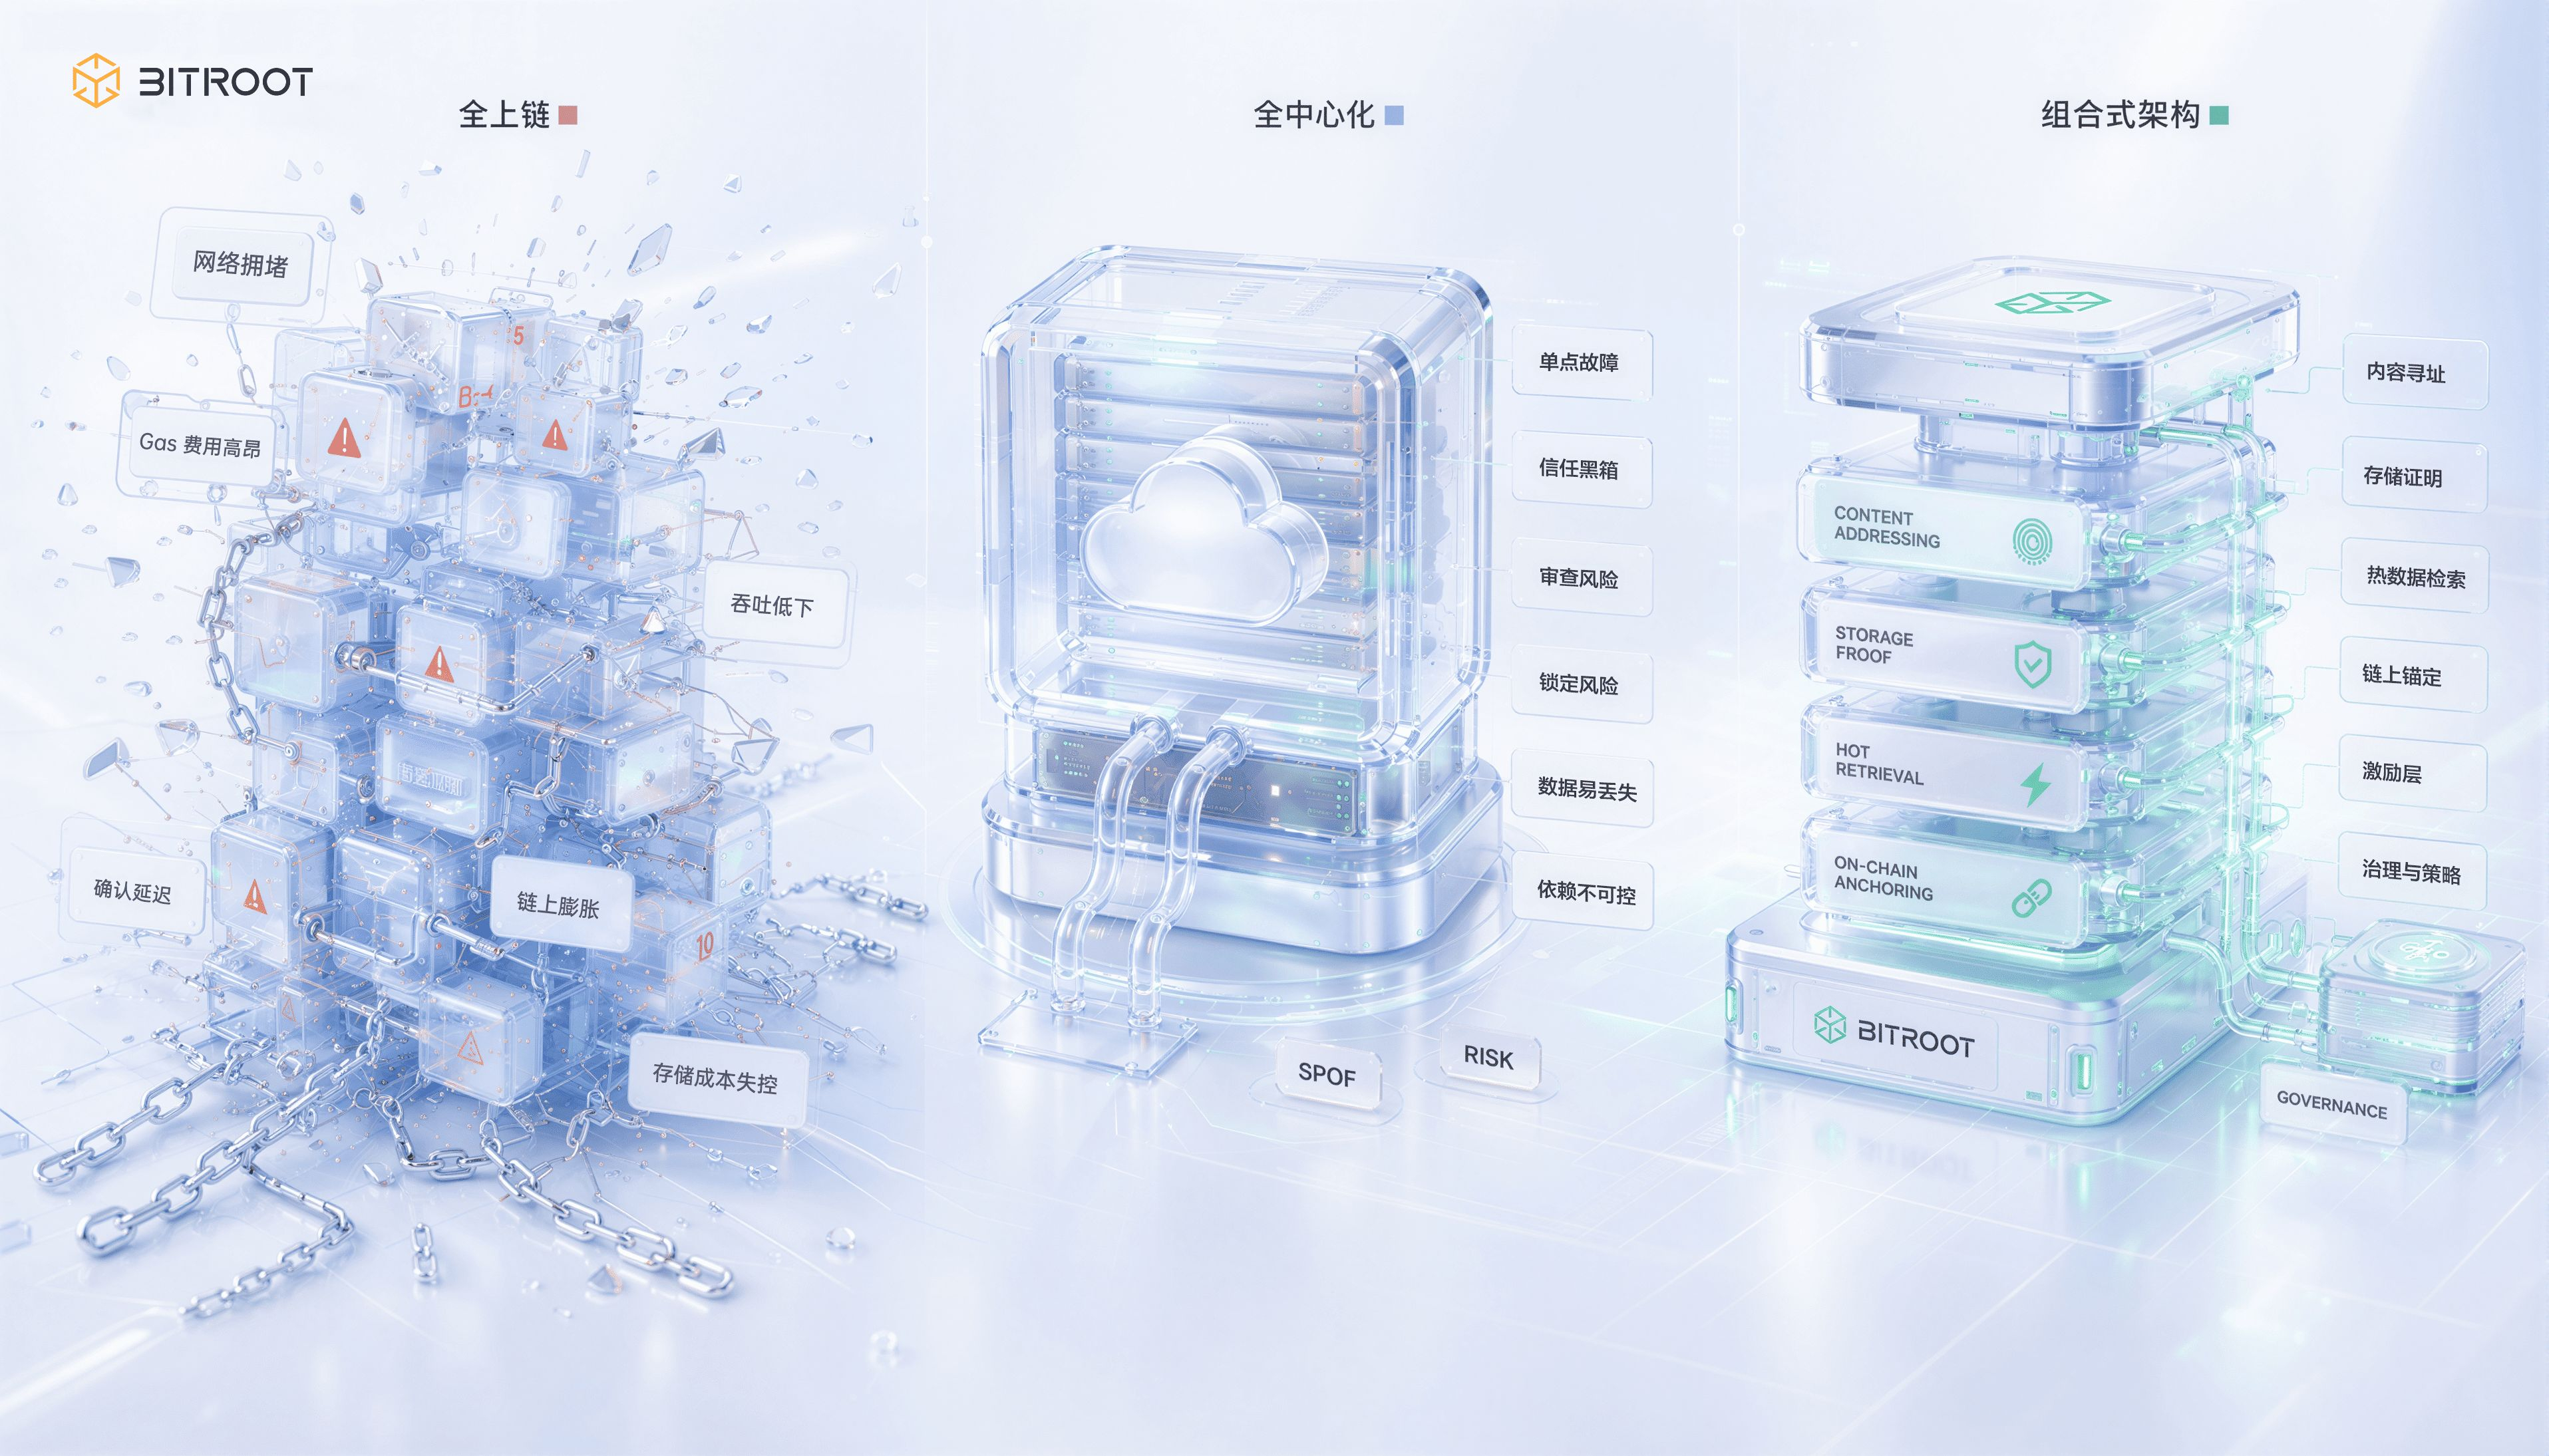
Alles vollständig On-Chain oder alles vollständig zentralisiert – beides führt in KI-Szenarien nicht zum Ziel. In den letzten Jahren wurde das Speicherproblem oft auf „Entweder komplett On-Chain oder komplett zentralisiert“ vereinfacht. Beide Wege sind im KI-Kontext nicht nachhaltig.
Der Druck, alles On-Chain zu machen, ist sehr konkret: Trainingsdaten, Modellgewichte, Inferenz-Logs und Vektorindizes sind üblicherweise von hohem Volumen und hoher Änderungsfrequenz. Selbst wenn man zuerst schneidet und dann erst On-Chain schreibt, prallt man gleichzeitig gegen das Durchsatz-Limit und gegen die Kostenkurve. Vollständig zentralisiert läuft zwar schneller, aber die Vertrauensgrundlagen – für Verifizierbarkeit, Nachvollziehbarkeit, Datenhoheit und Zusammenarbeit über mehrere Akteure – sind dort zu fragil. Sobald Multi-Party-Abrechnung und Zuweisung von Rechtsansprüchen (Claims) ins Spiel kommen, steht man ohne tragfähige Vertrauensbasis nicht fest.
Noch wichtiger ist die Veränderung: KI macht Storage von einem Kostenposten zu einer Produktionskomponente. Wer die Datenversionen verwaltet, bestimmt, bei wem die Initiative für Modelliterationen liegt; ob sich Daten verfügbar beweisen lassen, beeinflusst direkt Prioritäten bei der Scheduling- und Abrechnungslogik. Und die Fähigkeit, Daten zu Assets zu machen, entscheidet, ob ein Team langfristige Anreize im Ökosystem aufbauen kann. Bis zu dieser Stufe ist die Storage-Schicht keine reine Backoffice-Infrastruktur mehr, sondern ein Wertverteilungssystem.
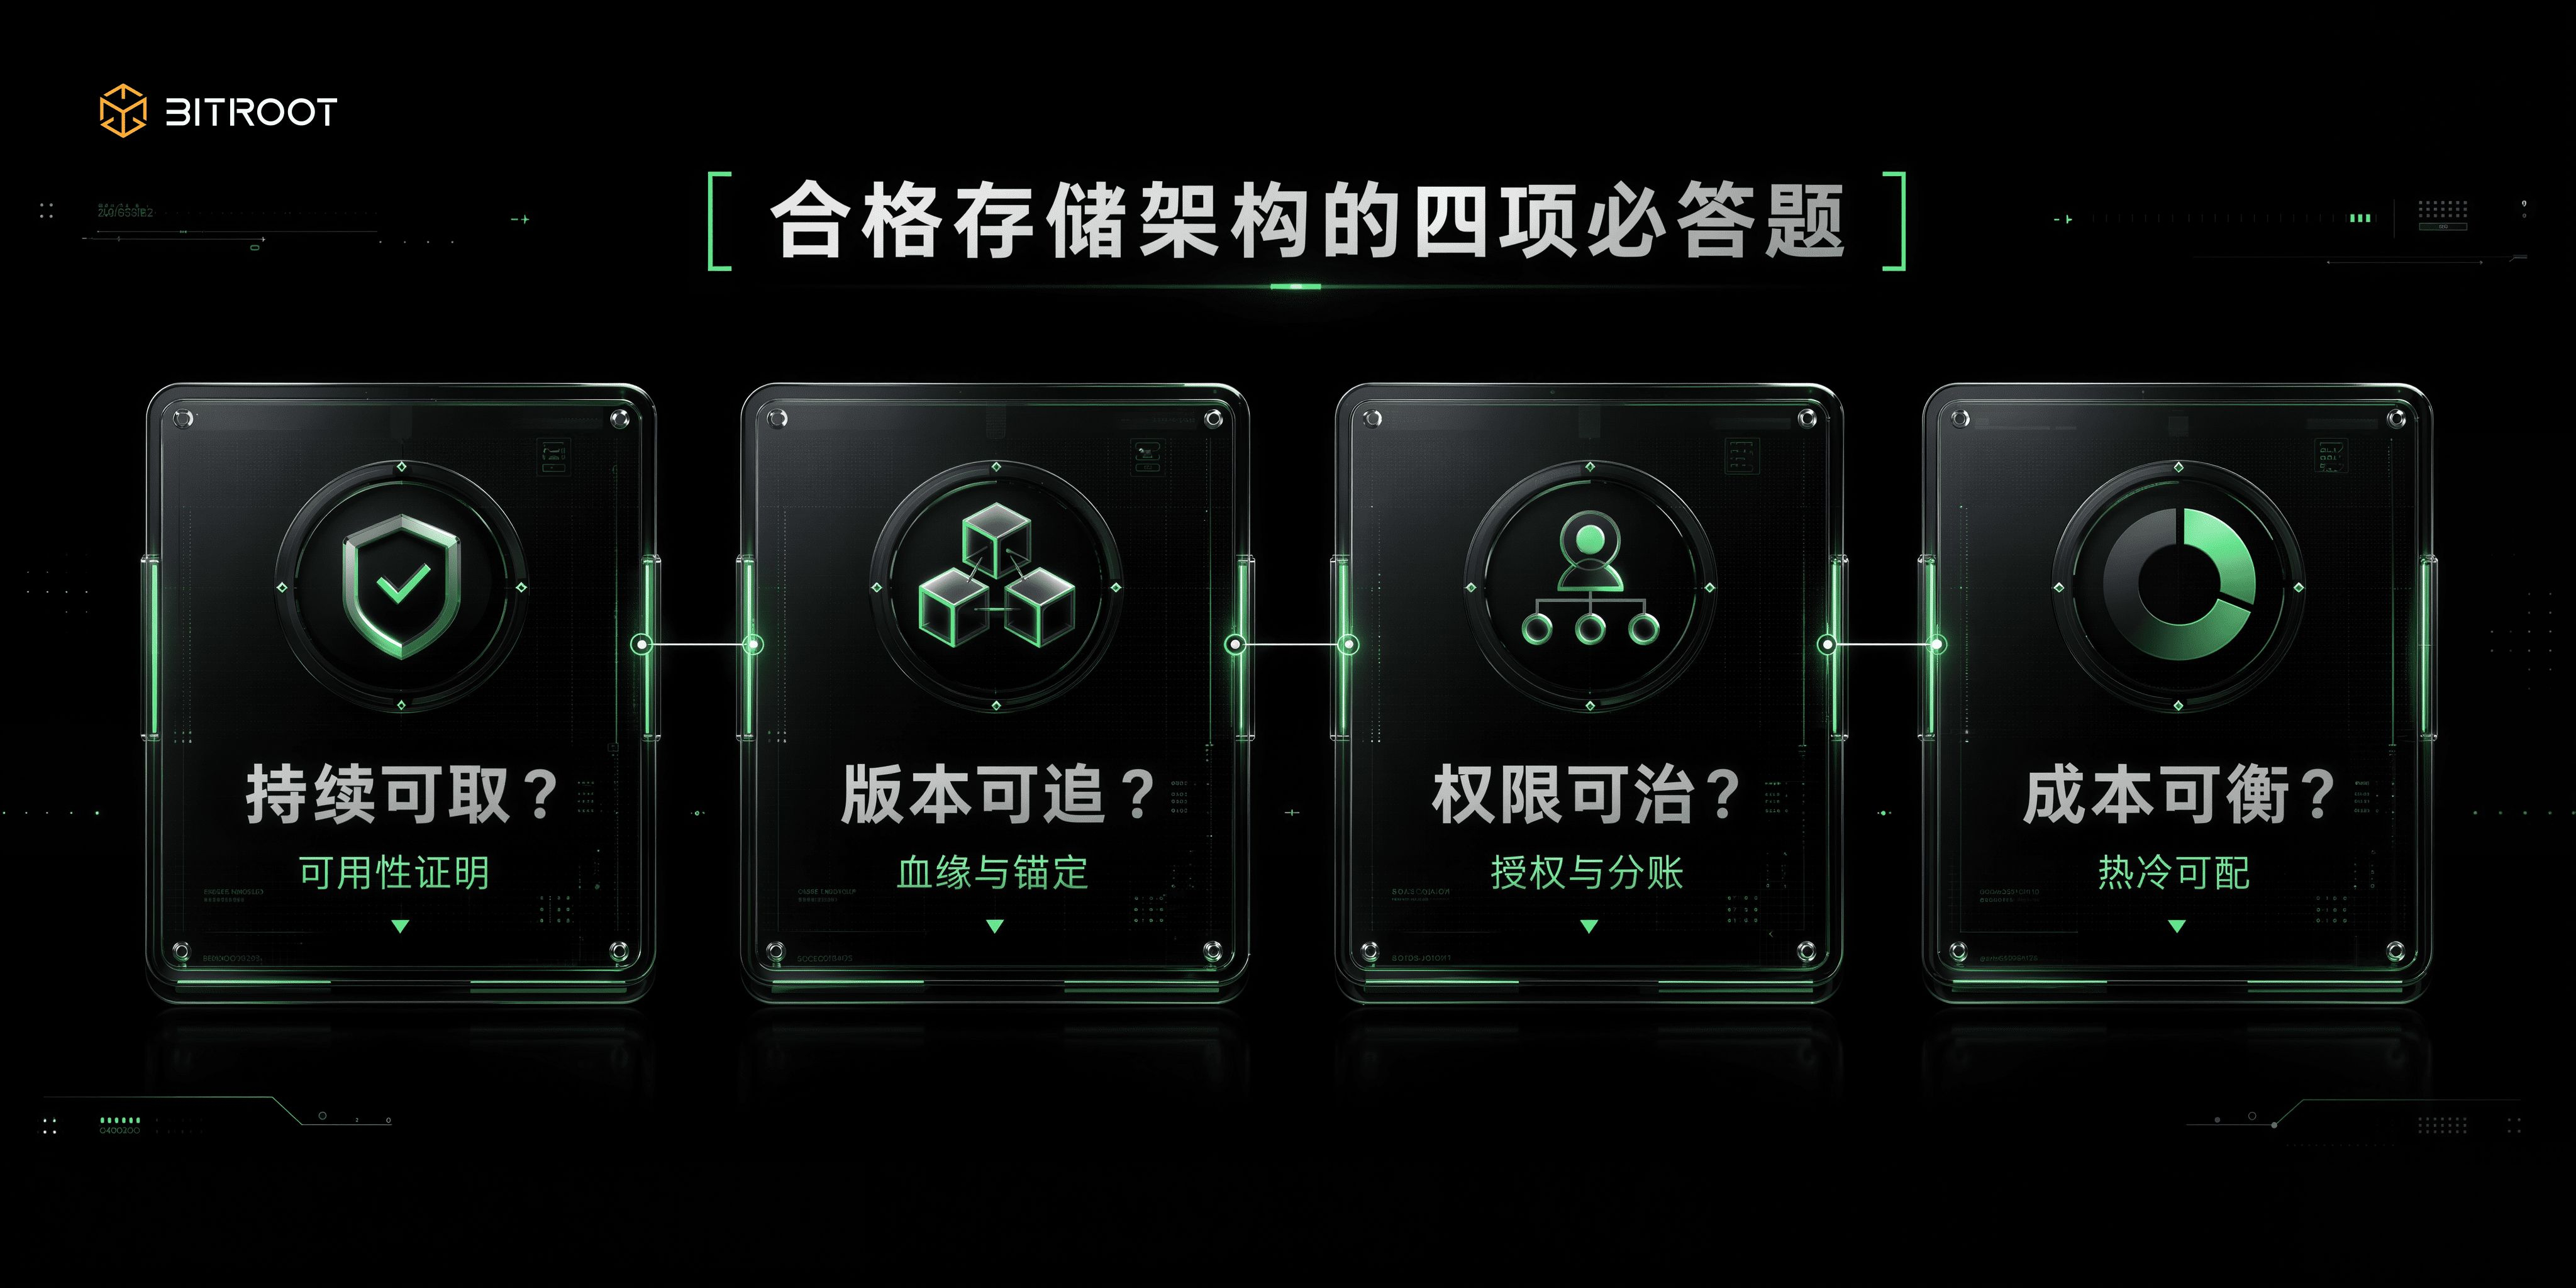
Daher muss eine hinreichend gute Storage-Architektur gleichzeitig vier Fragen beantworten: Existieren die Daten wirklich und bleiben sie dauerhaft abrufbar? Ist die Versionsbeziehung zwischen Daten und Modellen nachverfolgbar? Können Berechtigungen und Erträge governbar gemacht werden? Und kann das System langfristig ein Gleichgewicht zwischen Kosten und Performance halten?
Bitroots Einstiegspunkt: KI-Daten von „speicherbar“ zu „abrechenbar“ bringen
Das ist genau die Position, die Bitroot ergänzen muss. Als hochperformante Parallel-EVM-öffentliche Chain für KI-Szenarien sollte sich die Storage-Erzählung von Bitroot nicht auf „wo die Daten abgelegt werden“ beschränken, sondern die Fragen beantworten: „Wie werden die Daten bewiesen? Wie werden sie aufgerufen? Wie nehmen sie an der Aufteilung teil?“ Trainingskorpora, Modellgewichte, Vektorindizes und Inferenz-Logs können in einer verteilten Storage-Schicht liegen, die besser für große Objekte geeignet ist. Doch ihre Hash-Zusagen, Versionsbeziehungen, Berechtigungsstrategien, Aufrufprotokolle und Ertragsereignisse müssen als einheitliche On-Chain-Evidenz auf Bitroot entstehen.
Aus dieser Perspektive sind Bitroots hohe Durchsatzrate und geringe Latenz nicht nur „DeFi-Transaktionen bedienen“, sondern Dienste für fein granulierte, hochfrequente Governance-Ereignisse im AI-Stack: Datenaktualisierungen müssen verankert werden, Modellversionen müssen registriert werden, KI-Agent-Aufrufe müssen abgerechnet werden, Streit über Suchergebnisse muss geschlichtet werden, und die Verfügbarkeit von Storage-Knoten muss kontinuierlich challengt und belohnt werden. Nur wenn die On-Chain-Basis diese Ereignisse trägt, bleiben KI-Daten-Assets nicht in einer zentralisierten Datenbank gefangen und werden auch nicht zu nicht zur Verantwortung ziehbaren Off-Chain-Black-Boxen.
Drei gängige Paradigmen – keines durchstößt allein alle Szenarien. Der Wettbewerb verteilter Speicherung besteht nie darin, wer am innovativsten ist, sondern wer am besten zu deiner Datenstruktur passt.
Content Addressing Networks lösen das Problem: Ob es sich um „diese“ Daten handelt. Niemand garantiert hier, dass sie online sind. Laut IPFS-Official-Dokumentation ist der CID ein Identifikator basierend auf einem Content-Hash und hängt nicht von Position Addressing ab: Derselbe Inhalt erzeugt bei identischen Encode/Decode-Einstellungen denselben CID. Schon eine Änderung um ein einzelnes Byte verändert den CID. Dieses Merkmal eignet sich natürlich für Integritätsprüfungen, Duplikatenerkennung und Querverweise zwischen Systemen – also für eine Basisfunktion der Datenrechtszuweisung. Aber Content Addressing bedeutet nicht automatisch wirtschaftliche Persistenz und Verfügbarkeit. Der CID beantwortet die Identitätsfrage, nicht die Frage, wer die Daten dauerhaft online garantiert. Die erste typische Falle, in die viele Teams nach dem Go-Live tappen: Technisch haben sie den CID, geschäftlich aber keine Verfügbarkeitszusage.
Das Storage-Markt-Netzwerk kauft die Verfügbarkeit als Zeitdimension mit ökonomischen Mechanismen ein. Gemäß den Filecoin-Dokumenten etabliert das Netzwerk Mechanismen zur Storage-Zusage und zu kontinuierlichen Beweisen über Proof-of-Replication und Proof-of-Spacetime. PoRep beweist beim initialen Packaging, dass die einzigartige Replikatkopie wirklich gespeichert wurde; PoSt beweist in nachfolgenden Perioden wieder und wieder, dass sie noch existiert. WindowPoSt-Proof-Zyklen werden typischerweise in 24-Stunden-Blöcke organisiert und in mehrere 30-Minuten-Proof-Fenster unterteilt. Wenn ein Storage-Anbieter innerhalb eines Fensters keinen gültigen Proof einreicht, werden eine Collateral-Strafe und ein Abfall der Storage-Fähigkeit ausgelöst. In diesem System ist Verfügbarkeit ein fortlaufend bewertetes Kriterium, keine einmalige Zusage nach Vertragsabschluss. Solche „vertraglich“ und auditierbaren Modelle eignen sich für mittel- bis langfristiges Archivieren, Backups und Datenmärkte, sind aber eher wie ein „langfristiges Lagerhaus mit Beweisen“ als ein natürlicher Low-Latency-Onlineservice. Wenn man hochfrequente Online-Queries direkt darauf setzt, wird die Experience durch Tail-Latenzen ausgebremst.
Das permanente Storage-Netzwerk geht einen anderen Weg: Einmalzahlung für einen unveränderlichen Verlauf. Gemäß dem Arweave-Protokoll und Whitepaper-Material fließt ein Teil der Upload-Kosten in einen Storage-Spendenpool (endowment), der die langfristigen Storage-Incentives abdecken soll. Damit schiebt man langfristige Nachhaltigkeit in das Abrechnungsmodell nach vorne, statt sich auf spätere Renewal-Gewohnheiten zu verlassen. Es eignet sich für historisches Archiv, wichtige Beweismittel und Urheberrechtsmaterialien – also unveränderliche Aufzeichnungen. Die Schwäche ist ebenfalls klar: Dauerhaftigkeit bedeutet nicht automatisch High-Concurrency und Low-Latency. In der Praxis muss man zusätzlich Caching, Gateways oder Nearline-Index-Schichten hinzufügen, um die Echtzeit-Erfahrung der Nutzer zu erfüllen.
Neben diesen drei Basis-Paradigmen gibt es engineering-seitig zwei weitere gängige Kombinationen, die man abwägen kann. Eine ist die Hybridlösung aus einer Datenverfügbarkeits-Schicht plus Object Storage: Datenveröffentlichung und Proofs-of-Availability sind standardisierter, aber die Zusammenarbeit zwischen Schichten wird komplexer, und die Kosten für Interface-Governance steigen. Eine andere ist Multi-Cloud plus Edge-Kooperation: Latenz und Ausfallsicherheit sind besser, aber Kosten-Governance und Konsistenzmanagement sind schwieriger, sauber zu einem Ende zu bringen.
Egal wie man es wählt: Ein einzelnes Protokoll, das alle Szenarien frisst, funktioniert engineering-seitig nicht. Die wirksame Methode ist, nach Datentypen zu kombinieren: Dauerhaftigkeit, Suchlatenz und Compliance werden getrennt, jeweils passend zu entsprechenden Fähigkeitsschichten, und dann werden sie mit On-Chain-Ankerung und Governance-Schichten einheitlich orchestriert.
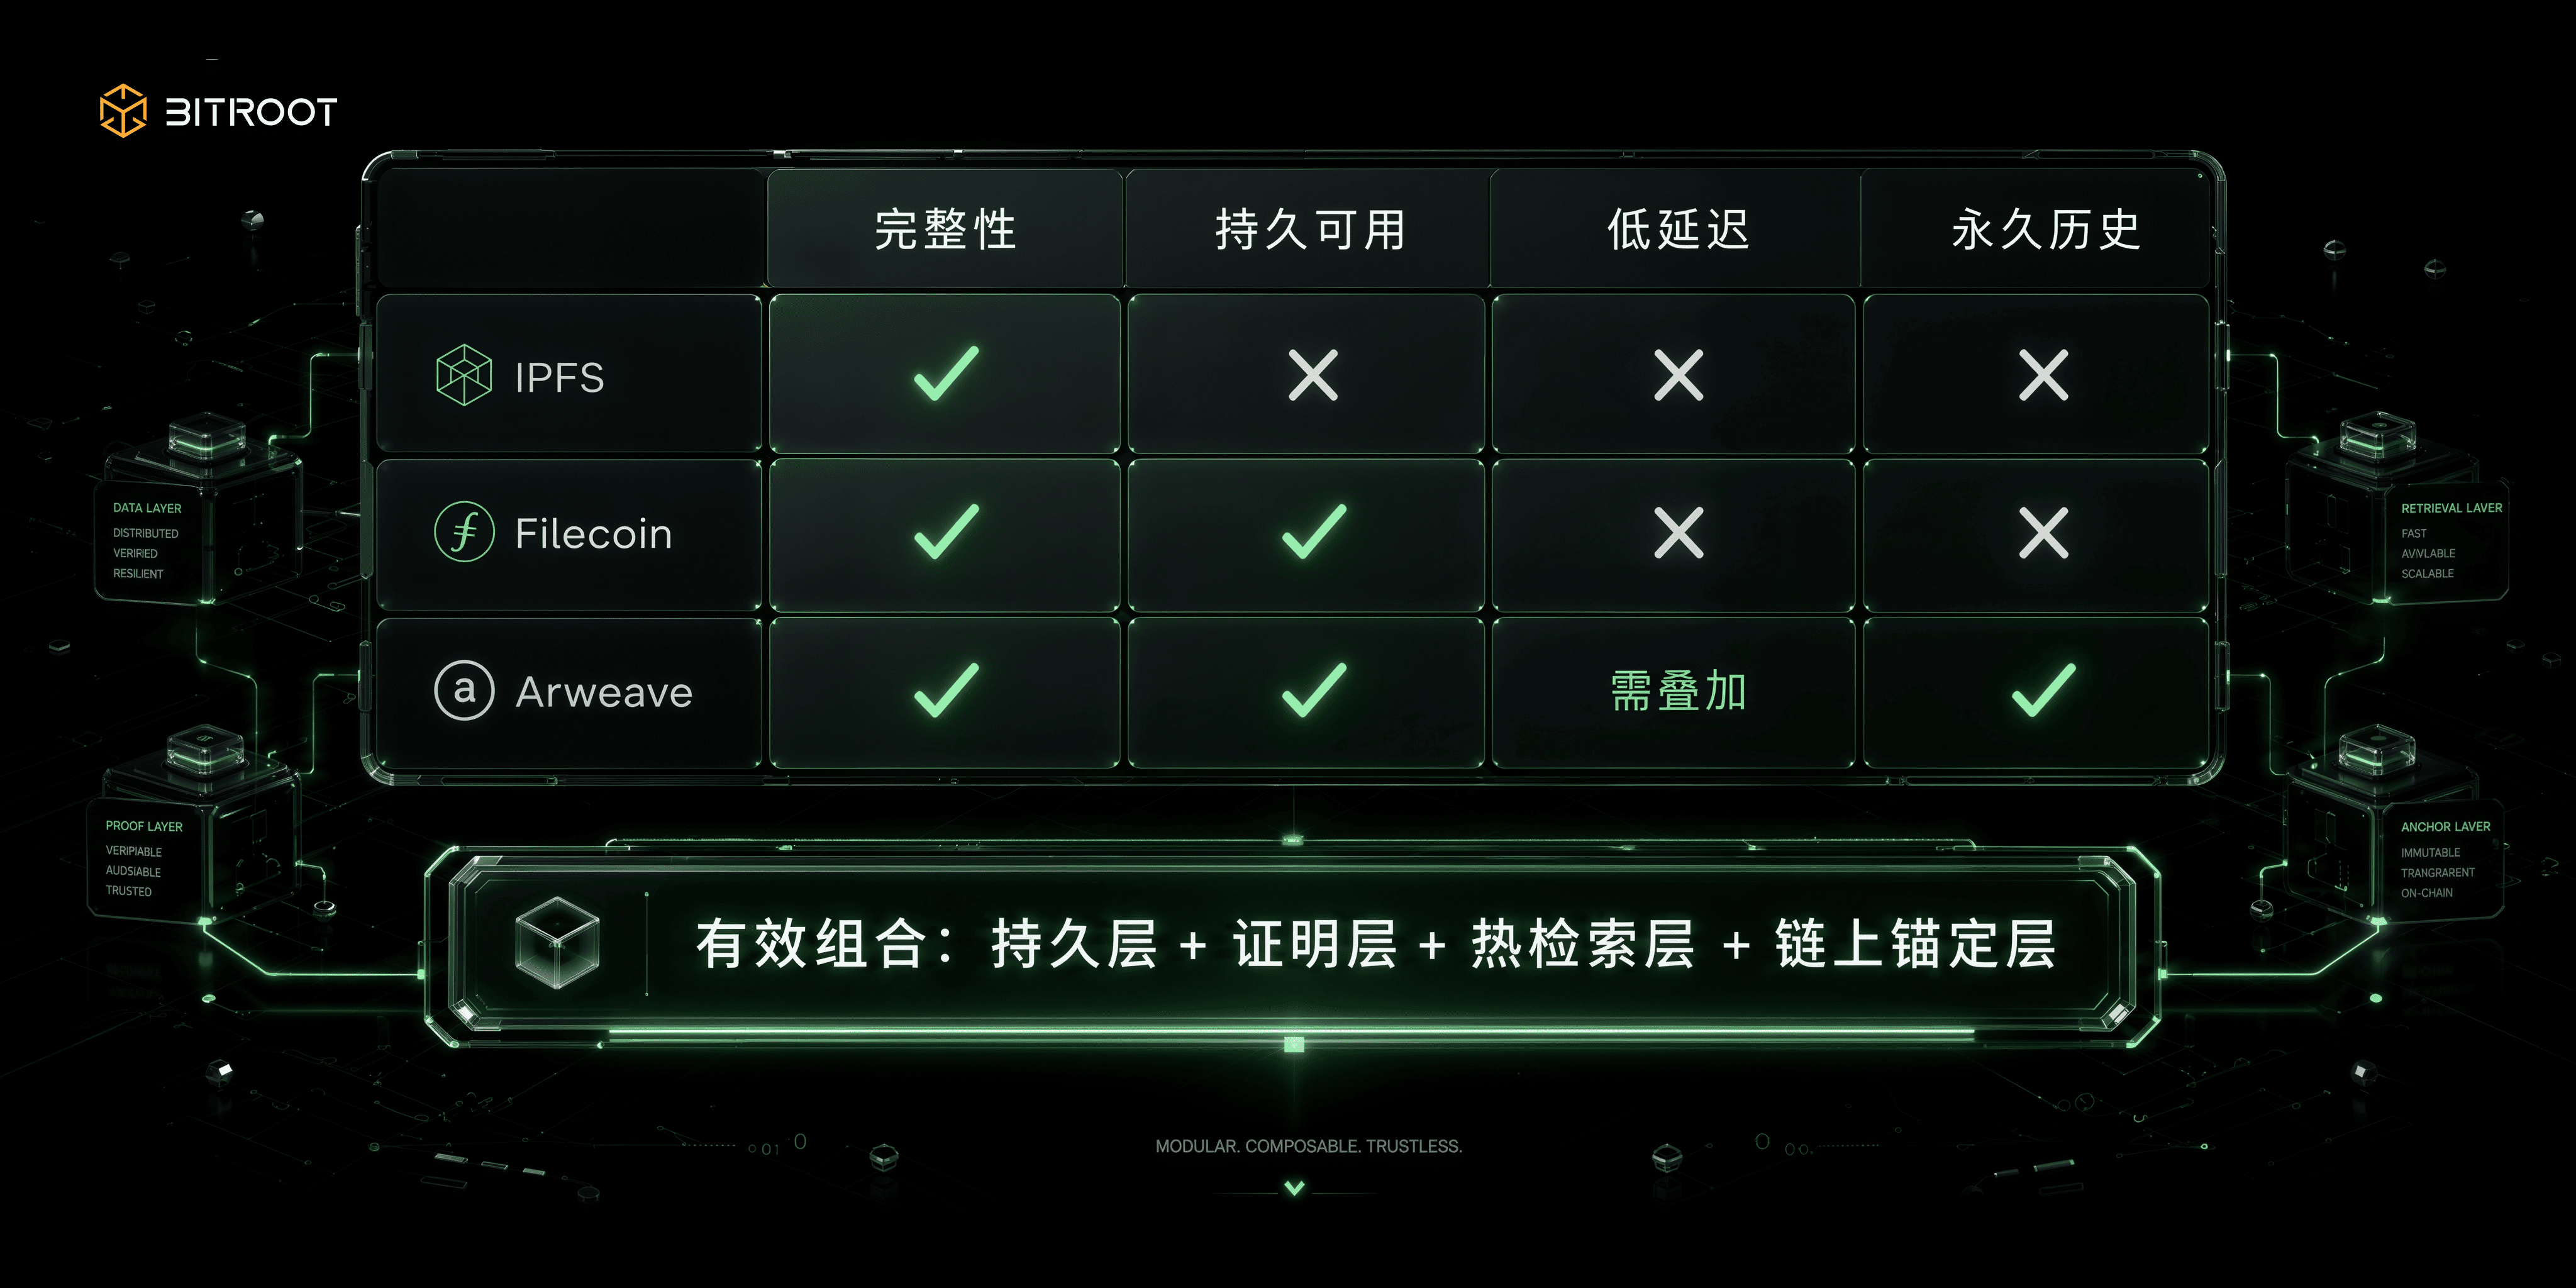
Der Entscheidungsraum von Bitroot sollte auf dieser Kombinationslogik beruhen: Nicht IPFS, Filecoin, Arweave oder Object Storage gegeneinander austauschen, sondern sie in unterschiedliche Verantwortungs-Schichten einordnen. Content Addressing dient der Datenidentität und Integrität, Storage Proof der langfristigen Verfügbarkeit, die permanente Schicht der kritischen Historie und den Belegen, die Hot-Search-Schicht dem KI-Anwendungs-Erlebnis, und die On-Chain-Schicht von Bitroot vereinheitlicht Version-Ankerung, Berechtigungsstrategien, Aufrufabrechnung und Streitbehandlung. Anders gesagt: Bitroot muss kein physischer Lagerplatz für alle Daten werden, sondern ein verlässliches Ledger für den Wertstrom von KI-Daten.
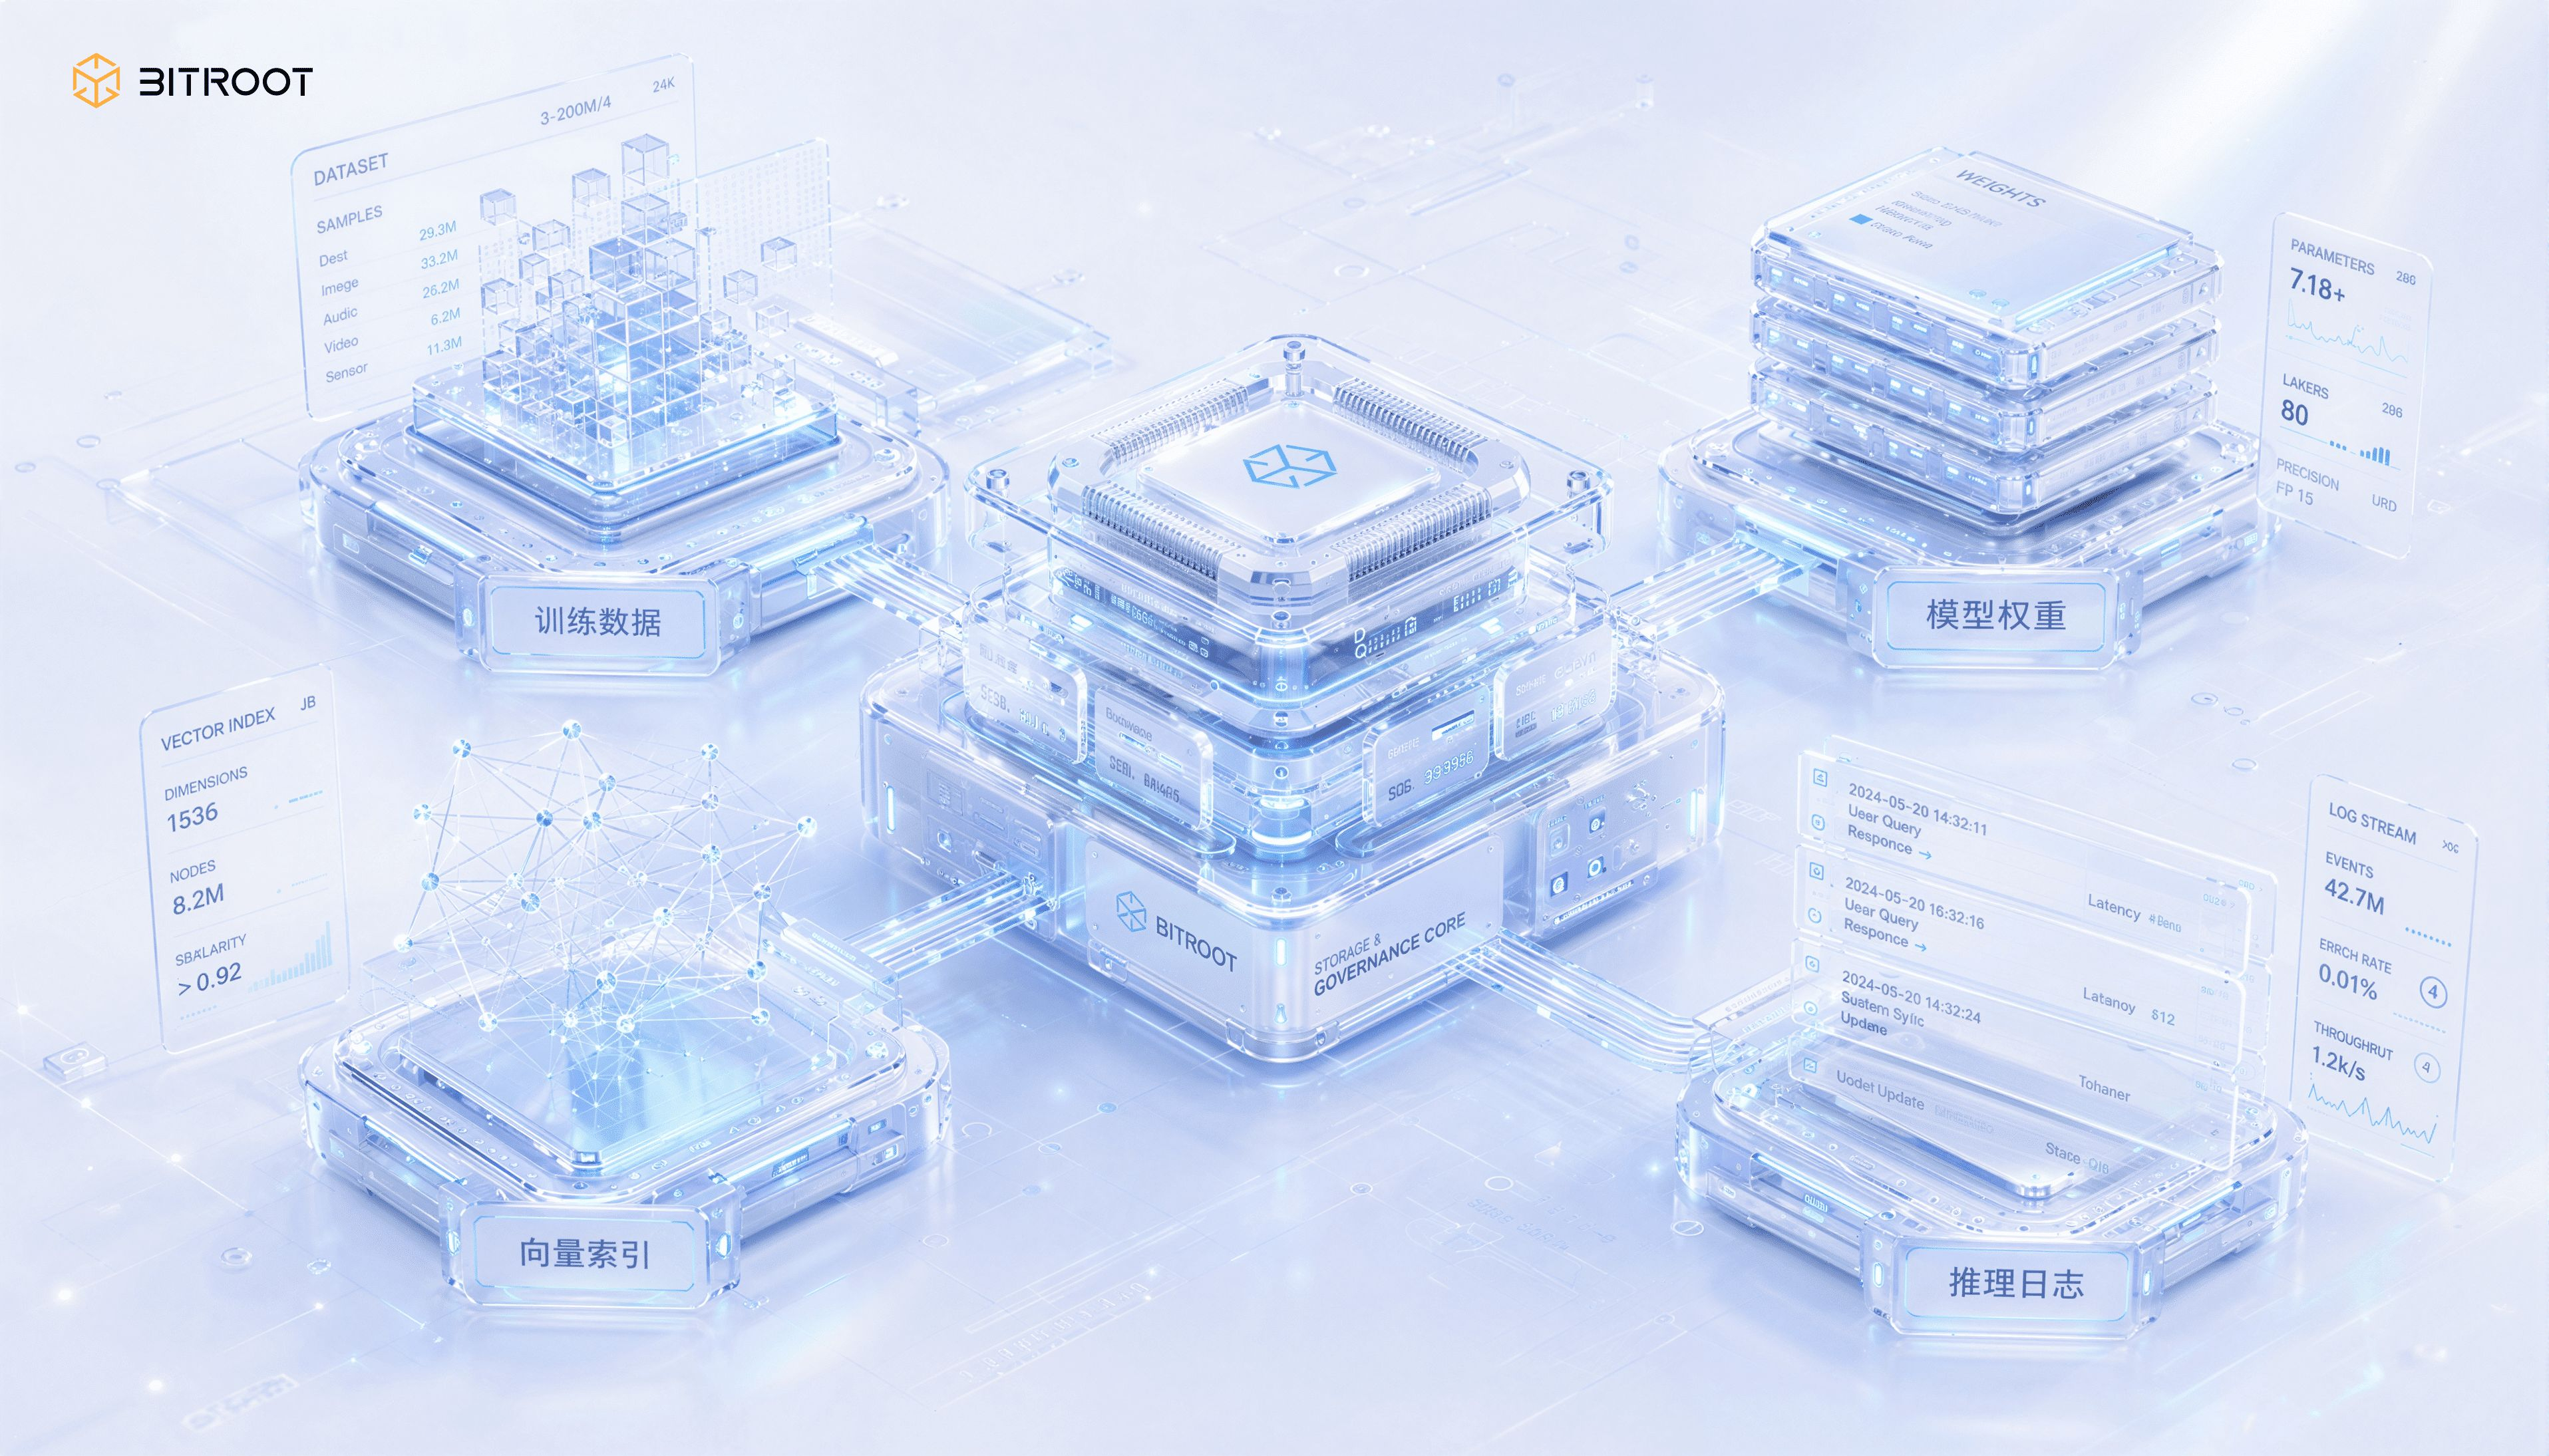
Die Schwierigkeit von AI-Storage liegt nicht darin, Dateien zu speichern, sondern darin, Produktionsketten zu managen. Im KI-Kontext werden Storage-Objekte mindestens in vier Kategorien aufgeteilt: Trainingsdaten, Modellgewichte, Vektorindizes und Inferenz-Logs. Die Lebenszyklen, Zugriffsmuster und Wertdichten dieser vier Objektarten unterscheiden sich vollständig. Wenn man sie mit einer einzigen Strategie verwaltet, spart man kurzfristig – aber langfristig verliert man die Governance-Kontrolle.
Die Mühe bei Trainingsdaten liegt nicht in der Kapazität, sondern im Versionsdrift. Viele Teams setzen Trainingsdatenfragen gleich mit den Kosten für TB-Level Storage; tatsächlich ist das Schwierigste der Drift: Sobald sich Reinigungsregeln, Stichproben-Auswahlschwellen oder Annotation-Interpretationen ändern, verändert sich das Modellverhalten – und ohne Bindung an Datenversionen und Modellversionen ist Offline-Evaluation schwer nachzuprüfen. Nach den Modell- und Daten-Tracking-Praktiken von MLflow ist die Bindung von Trainingsläufen an Datenversionen Voraussetzung, um Experimente reproduzierbar zu machen. Dieses Prinzip bleibt auch On-Chain gültig: Die Rohdaten müssen nicht komplett auf die Kette, aber Versionszusagen, wichtige Zusammenfassungen und Quell-Fingerprints müssen On-Chain verankert werden. Auf Engineering-Ebene sollten mindestens drei Identifier gebunden werden: Datenversion, Trainingslauf und Modellversion. Fehlt einer davon, wird die Rückverfolgung von On-Chain-Problemen vom Prüfen von Evidenz zu einem Raten über Ursachen.
Das Problem mit Modellgewichten liegt meistens nicht darin, ob man sie herunterladen kann, sondern darin, wer die Aufrufgrenzen kontrolliert. Wenn ein Modell in Produktion geht, durchläuft es typischerweise mehrere Zustände: Gradual Rollout, Main Use, Rollback, Retirement. Ohne standardisierte Registrierungs- und Autorisierungsmechanismen ist der On-Chain-Aufruf eine nicht auditierbare Blackbox. Eine reife Modellregistrierungsstelle hält gleichzeitig die Abstammung (lineage), Versionsaliases, Signatur-Constraints und Audit-Tags fest. Für On-Chain-Systeme sollte eine Modellversion nicht nur ein Dateihash sein, sondern fest mit Berechtigungsstrategien, Ertragsverteilung und Verantwortungsgrenzen verknüpft sein.
Die Schwierigkeiten bei Vektorindizes konzentrieren sich an einer Stelle: Konsistenz nach der Hot/Cold-Schichtung. Vektor-Suche hat einen inhärenten Widerspruch: Low-Latency und Low-Cost konkurrieren miteinander. Die Hot-Schicht muss über Speicher oder hochleistungsfähige Index-Services Online-Antworten sicherstellen, die Cold-Schicht muss mit Object Storage die langfristigen Kosten niedrig halten. Ohne einheitliche Metadaten und Synchronisationsstrategie werden die zwei Schichten schnell auseinanderlaufen, bis es zum Problem kommt, dass dieselbe Abfrage bei unterschiedlichen Knoten unterschiedliche semantische Ergebnisse liefert. Deshalb muss das Vektor-System zwei Dinge unterstützen: Der Indexaufbauprozess muss nachverfolgbar sein, und es muss abgleichbar sein, dass die Indexversion in der Hot-Schicht zur Masterdatenbasis in der Cold-Schicht stimmt. Genau darum geht es auch in der nachfolgenden „verifizierbaren Suche“.
Inferenz-Logs müssen so gestaltet werden, dass gleichzeitig Datenschutz, Audit und Compliance erfüllt sind – das ist schwierig. Sie sind sowohl Material für Sicherheits-Audits als auch eine Quelle für Datenschutzrisiken: Vollständiges Speichern im Klartext bringt Compliance-Risiken, und gar nichts zu speichern nimmt einem die Fähigkeit, Vorfälle für ein Post-Mortem zu rekonstruieren. Ein praktikabler Ansatz ist eine dreifache Stapelung: Entsensibilisierte Inhalte werden gespeichert, Hash-Zusagen werden On-Chain verankert, Zugriffe müssen über eine auditierbare Autorisierung erfolgen. Eine schichtweise Umsetzung für Unveränderbarkeit und widerrufbaren Zugriff schafft das Gleichgewicht.
In Bitroots KI-Stack lassen sich diese vier Objektarten vier Governance-Aktionen zuordnen: Trainingsdaten werden für Versions-Ankerung und Quellenregistrierung verwendet, Modellgewichte für Asset-Registrierung und autorisierte Aufrufe, Vektorindizes für Hot/Cold-Schichtung und Konsistenzbeweise, Inferenz-Logs für Entsensibilisierungsspeicherung und Audit-Zusagen. Sie müssen nicht alle auf dieselbe Weise On-Chain gehen, aber sie müssen auf Bitroot zu einer einheitlichen Asset-ID, einer Versionslinie und zu Aufrufereignissen zusammenlaufen. So erst kann zwischen Daten-Assets, Modell-Assets und Agent-Anwendungen ein wiederverwendbarer Business-Closed-Loop entstehen.
Verifizierbar ist die Untergrenze; Proof-of-Availability ist die eigentliche Trennlinie. Ohne Proof-of-Availability ist eine Storage-Zusage in Produktionsumgebungen praktisch keine Zusage. Um verteilter Storage in Produktion zu bringen, muss es mindestens drei Stufen bestehen: Integritätsbeweis, Verfügbarkeitsbeweis und Verhaltens-Audit. Wenn man zusätzlich in KI-Such-Szenarien geht, braucht man noch eine schwierigste Stufe oben drauf: Suchnachweis (Suchergebnis ist beweisbar).
Integrität ist beweisbar über Content Addressing plus Merkle-Verpflichtungen. Content Addressing garantiert stabile Daten-Fingerprints, Merkle-Verpflichtungen garantieren lokale Verifizierbarkeit. Der Engineering-Sinn: Du kannst anhand von fragmentbasierten Beweisen ein Teilset eines Objekts verifizieren, ohne jedes Mal alles vollständig zu lesen. Bei Gewichten großer Modelle, großen Korpora und Multimedia-Daten bestimmt das direkt die Verifizierungskosten.
Proof-of-Availability basiert auf dem Challenge-Mechanismus und Sampling-Verifikation. Die Praxis von Filecoin zeigt: Verfügbarkeit ist kein reines mündliches SLA, sondern periodische Challenges plus On-Chain-Belege. Als allgemeines Architekturmodell besteht es aus einem dreiteiligen Paket: passives Abfragen, aktives Wachen (Monitoring) und Strafmechanismen für Fehlschläge. Knoten müssen in dem vorgegebenen Zeitfenster auf Challenges reagieren, sonst gibt es Abzüge oder ein Absinken von Gewichten. Der gleiche Ansatz geht in der Datenverfügbarkeits-Schicht noch weiter. Gemäß dem Data-Availability-Sampling-Design von Celestia wird ein k×k-Erweiterungsschema zu einer 2k×2k-Matrix; leichte Knoten erreichen Wahrscheinlichkeitsvertrauen über mehrere Runden zufälliger Sampling und probabilistische Akkumulation, ohne komplette Datenblöcke herunterladen zu müssen. Das ist eine übertragbare Erkenntnis für KI-Szenarien: Angesichts riesiger Objekte und hoher Parallelzugriffe muss nicht jede Verfügbarkeit durch vollständiges Downloaden verifiziert werden; statistische Bestätigung ist in großen Systemen realistischer.
Nachverfolgbarkeit und Auditierbarkeit erreichen wir über On-Chain-Ankerung plus Ereignis-Trails. Das Schwerste im Speichersystem sind in Wahrheit die Handlungen: Wer hat welche Daten hochgeladen, wer hat welche Richtlinien geändert, wer hat wann Migrationen ausgelöst und wer hat zu welchem Zeitpunkt sensible Modelle aufgerufen. Wenn diese Handlungen nicht zu einem einheitlichen Ereignisstrom zusammenlaufen, führt jeder Streitfall zurück zu „Mündliche Behauptung ohne Beweis“. Governance sollte deshalb nicht alle Details auf die Kette verlagern, sondern im Streitfall eine minimale, eindeutige und verifizierbare Evidenzsammlung in der Hand haben.
Verifizierbare Suche ist einzigartig für KI-Szenarien und die schwierigste Stufe. Das Problem liegt in einer leicht übersehbaren Lücke: Ein Ergebnis zurückzugeben heißt nicht, das richtige Ergebnis zurückzugeben. Ein Vektor-Suchknoten kann durchaus einen abgelaufenen Index nutzen, ja sogar echte Nachbarn überspringen und dir ein top-k liefern, das auf den ersten Blick plausibel aussieht. Wenn du nur die Rückgabewerte betrachtest, kannst du es nicht unterscheiden. Die Ausgabe einer semantischen Suche hat selbst keine Selbstbeweisfähigkeit; Fehler werden nicht „gemeldet“, sie senken nur stillschweigend Recall-Qualität und Modellleistung. Wenn Suchergebnisse für Abrechnung, Autorisierung oder On-Chain-Entscheidungen genutzt werden sollen, wird diese Lücke von einem Qualitätsproblem zu einem Vertrauensproblem.
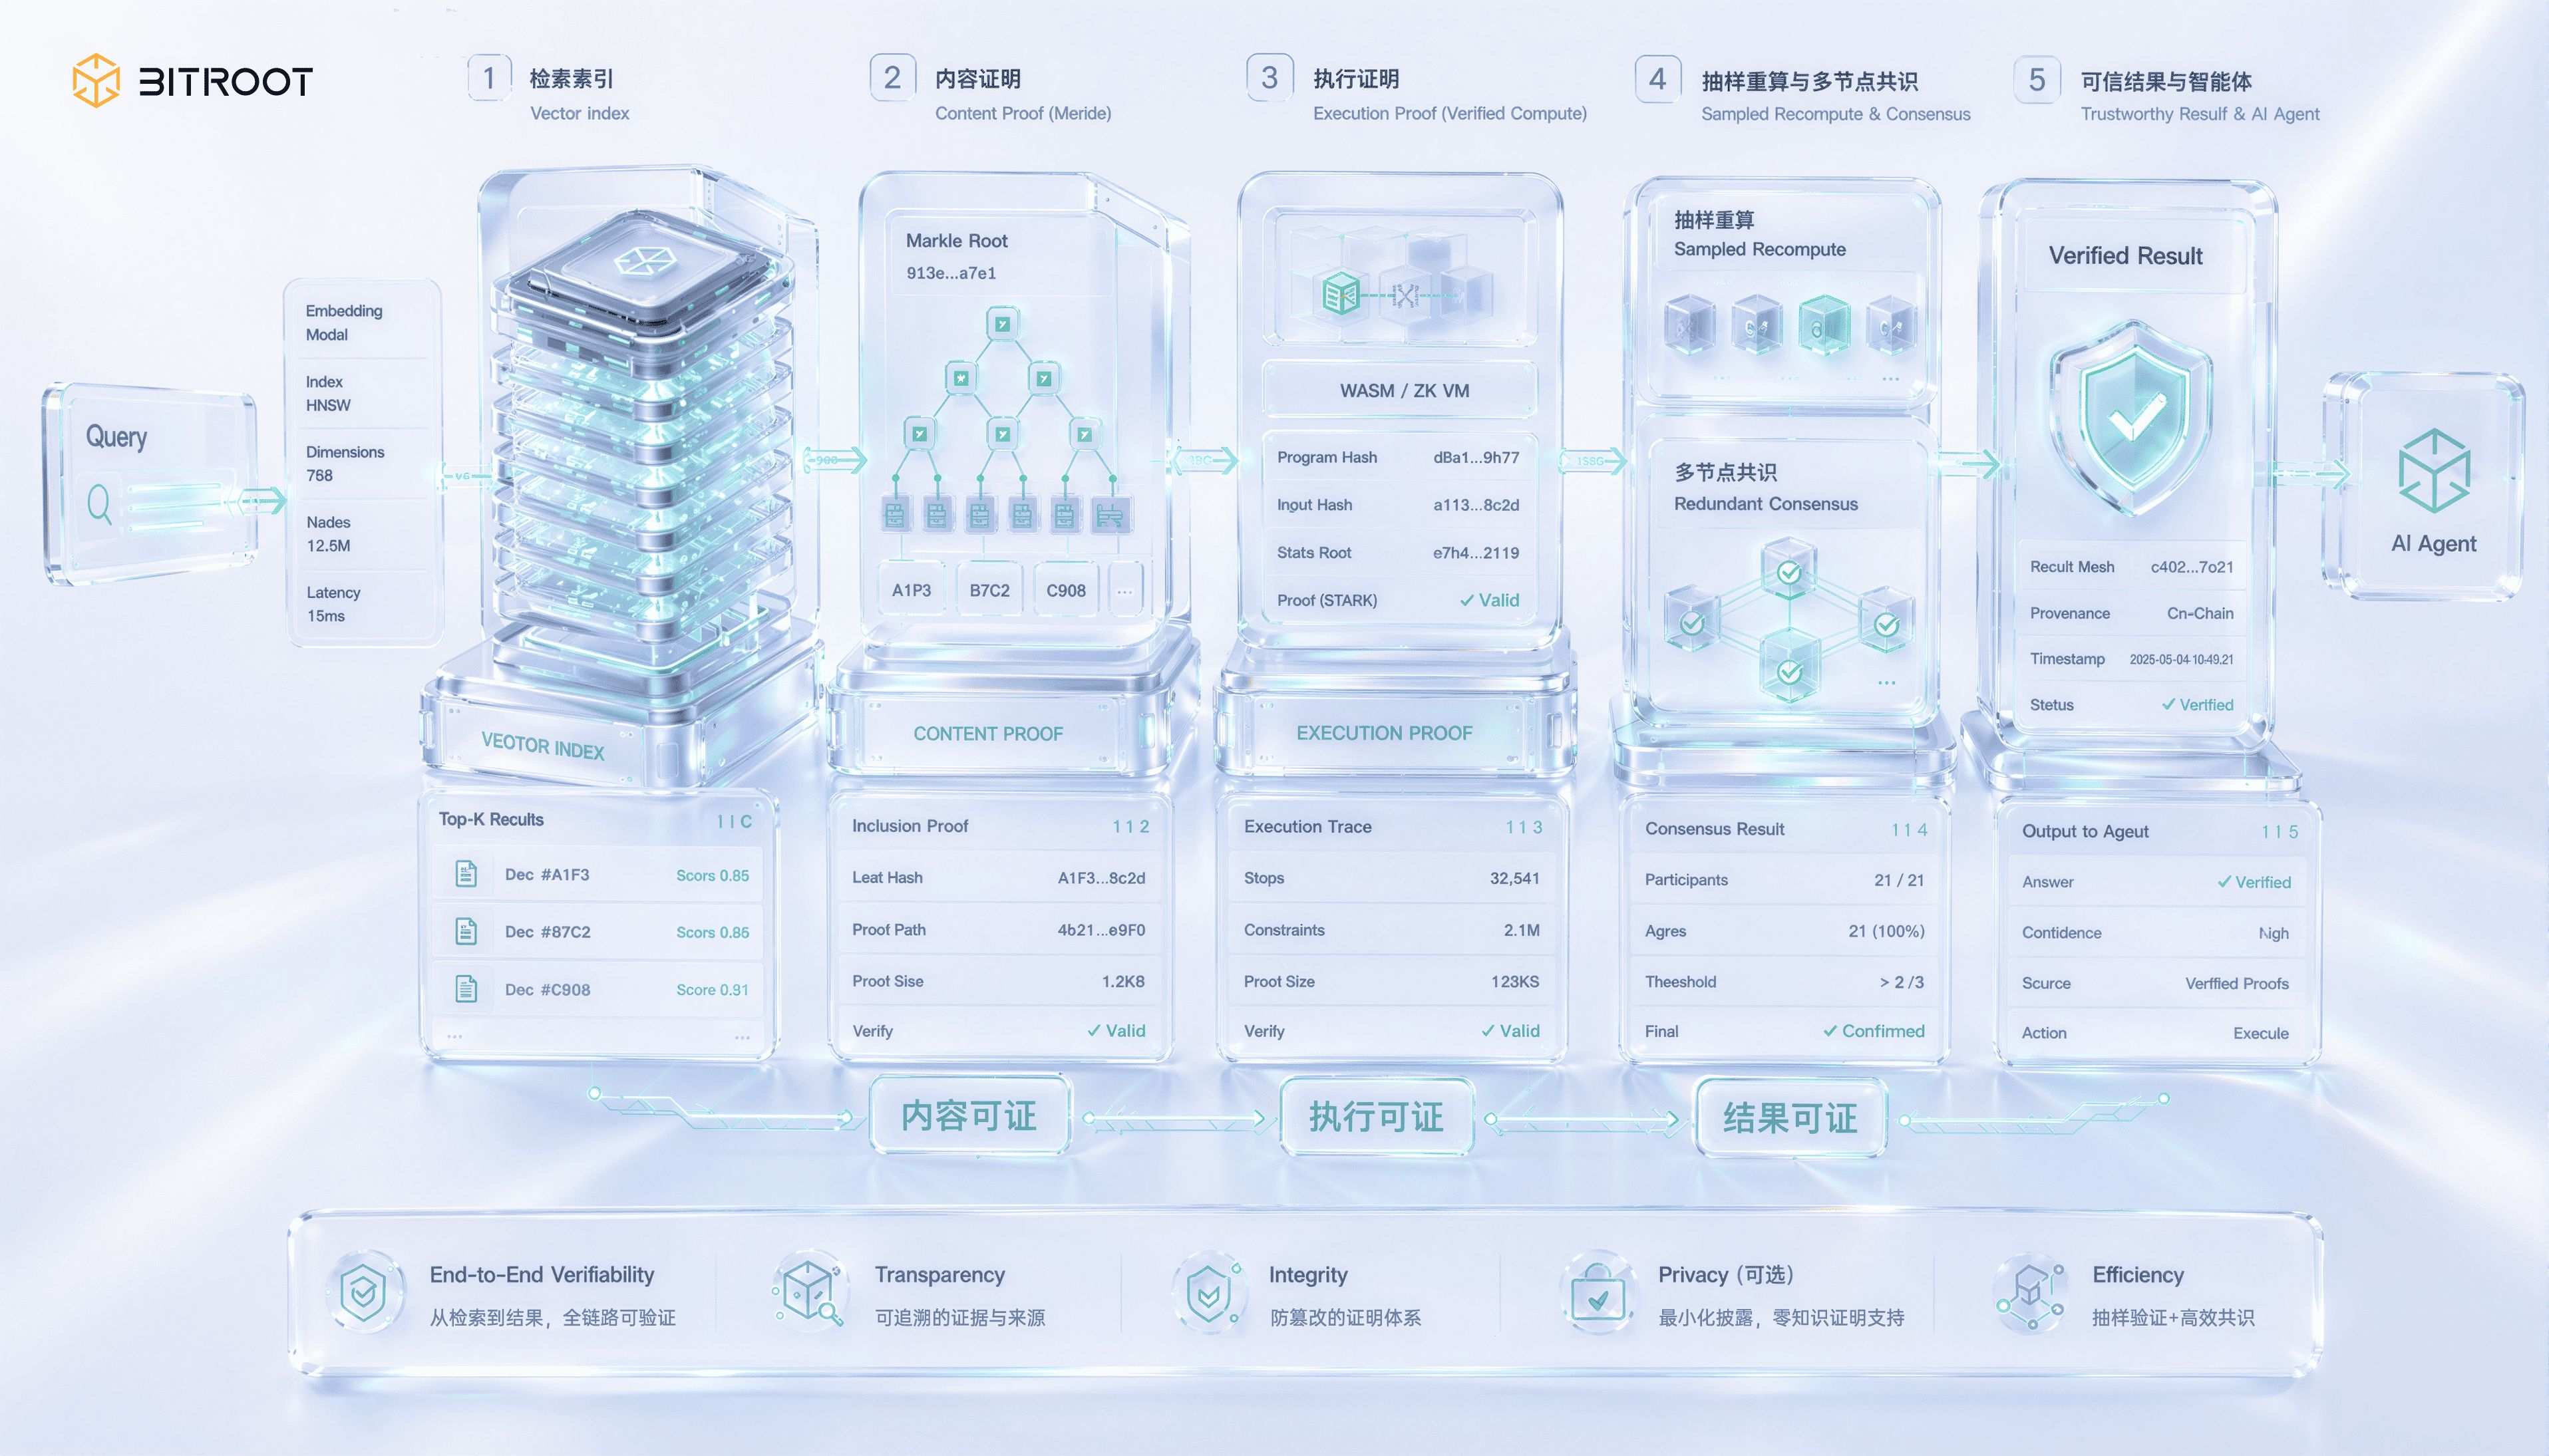
Wenn man „verifizierbare Suche“ in Teile zerlegt, besteht sie aus drei Stufen, die jeweils zunehmend schwerer garantieren. Die erste Stufe ist „Content-verifizierbar“: sie beweist, dass der zurückgegebene Vektor wirklich zu einer zugesagten Indexversion gehört. Dafür baut man authentifizierte Datenstrukturen für den Index auf: Man verankert die Merkle-Commitment-Root des Indexes On-Chain. Beim Zurückgeben der Ergebnisse hängt man ein Inklusionsbeweisstück an, damit ein Knoten keine Daten aus dem Nichts erfinden oder austauschen kann. Die zweite Stufe ist „Execution-verifizierbar“: man beweist, dass diese Abfrage tatsächlich auf der zugesagten Version gelaufen ist und nicht auf einem privat manipulierten Index. Dafür muss der Abfrageprozess in den Bereich „verifizierbare Berechnung“ fallen. Die dritte Stufe, die am schwierigsten ist, ist „Ergebnis-verifizierbar“: man beweist, dass das zurückgegebene Top-k innerhalb einer gegebenen Metrik wirklich die nächsten Nachbarn sind – und nicht, dass nähere Nachbarn ausgelassen wurden. Grundsätzlich muss man damit die Korrektheit von Approximate-Nearest-Neighbour-Suche beweisen.
Für den Produktionsmaßstab kann man für hochdimensionale Approximate-Nearest-Neighbour-Suche derzeit noch keinen streng beweisbaren Ergebnisnachweis in dem Umfang garantieren, wie es praktisch wünschenswert wäre; es ist weiterhin ein Vorreiter-Thema. Kryptografische Ansätze wie Zero-Knowledge-Proofs werden vorangetrieben, aber die Beweiskosten für Vektoroperationen in hohen Dimensionen sind noch lange nicht für eine großskalige Online-Nutzung geeignet. Die pragmatische Engineering-Lösung lautet: Schichtweise Absicherung statt „one shot“. Erst werden Indexversionen und Build-Parameter On-Chain verankert, damit Rückverfolgbarkeit gewährleistet ist. Dann macht man bei Abfragen Sampling-Neuberechnungen: Man zieht einen Anteil der Online-Abfragen auf vertrauenswürdige Replikate zurück, führt dort erneut aus und vergleicht die Ergebnisse. Man ersetzt dabei eine Beweisführung pro Eintrag durch statistische Konfidenz. Gleichzeitig lässt man mehrere unabhängige Knoten redundant suchen, und man bildet Konsens über die Rückgaberesultate, wodurch die Kosten für Single-Node-Cheating erhöht werden. Erst wenn Abgleich oder Konsens auseinanderlaufen, wird auf vollständiges Rechnen und On-Chain-Schiedsentscheid für streitige Abfragen „hochgestuft“. Diese Route entspricht inhaltlich dem Ansatz in der Proof-of-Availability: In großen Systemen ist statistische Bestätigung plus „Upgrade bei Streit“ oft besser umsetzbar als jede einzelne strenge Beweisführung.
Für Bitroot ist die verifizierbare Suche kein isolierter Speicher-Use-Case, sondern ein Bestandteil der vertrauenswürdigen Ausführung eines KI-Agents. Wenn ein On-Chain-Agent für Entscheidungen auf externe Wissensdatenbanken, Modellgewichte oder Vektorindizes angewiesen ist, muss das System mindestens drei Dinge beantworten können: Welches Datenversions-Update er gelesen hat, welche Modellversionsangabe er aufruft und ob das Ergebnis aus einer registrierten Indexversion stammt. Bitroot kann diese Evidenz zu verifizierbaren Ereignissen auf der Kette komprimieren – damit wird das Verhalten des Agents von „sieht intelligent aus“ zu „nachverfolgbar, angreifbar und abrechenbar“.
Das echte Auswahlproblem: Nicht ein Protokoll auswählen, sondern kombinieren. Viele Reviews scheitern, weil man die Frage falsch formuliert. Die richtige Frage lautet nicht: „Welches Protokoll nehmen wir?“, sondern: „Welche Datenkombination haben wir, welche Zielkennzahlen verfolgen wir und welche Constraints gelten?“ Empfohlen wird ein Vorgehen in vier Schritten.
Zuerst macht man ein Daten-Asset-Inventar. Mindestens muss man Statusdaten, Objekt-Daten, Suchdaten und Audit-Daten unterscheiden. Das Inventar-Template sollte feste Felder haben, mindestens acht: Datentyp, täglicher Zuwachs, Peak-Konkurrenz, Read/Write-Ratio, Aufbewahrungsdauer, Compliance-Level, Ziel-Latenz und Kostenobergrenze. Wenn die Felder einheitlich sind, werden Gespräche über die Auswahl zwischen Teams viel schneller.
Definiere nun die Service-Level-Ziele: Lege P95/P99-Latenz, Wiederherstellungszeit RTO, Wiederherstellungspunkt RPO, Verfügbarkeitsziele und die obere Grenze der Kosten pro TB jeweils eindeutig fest – sonst gibt es später keine Vergleichsmaßstäbe für Diskussionen.
Als Nächstes wird ein Capability-Mapping aufgebaut: Dauerhafte Speicherung, periodische Proof-of-Availability, Low-Latency-Suche und Zugriff-Governance werden jeweils auf verschiedene technische Schichten gemappt – nicht mit der Erwartung, dass eine einzelne Schicht alles abdeckt.
Zum Schluss: Migrationsschwellen festlegen. Welche Daten dürfen in der Übergangsphase zentral gehostet werden, welche Kennzahlen lösen Migration aus und wann muss der dezentrale Ersatz zwingend abgeschlossen sein. Ein praktikabler Ansatz sind zwei vordefinierte Schwellen: Wenn die Kosten pro TB in zwei aufeinanderfolgenden statistischen Zyklen das Budget übersteigen, oder wenn die P95-Latenz in zwei Wochen die Zielwerte überschreitet, wird automatisch eine Architektur-Migrationsprüfung getriggert. Ohne Schwellen gibt es keine Governance – die Übergangsphase wird sonst zu einem dauerhaften Zustand.
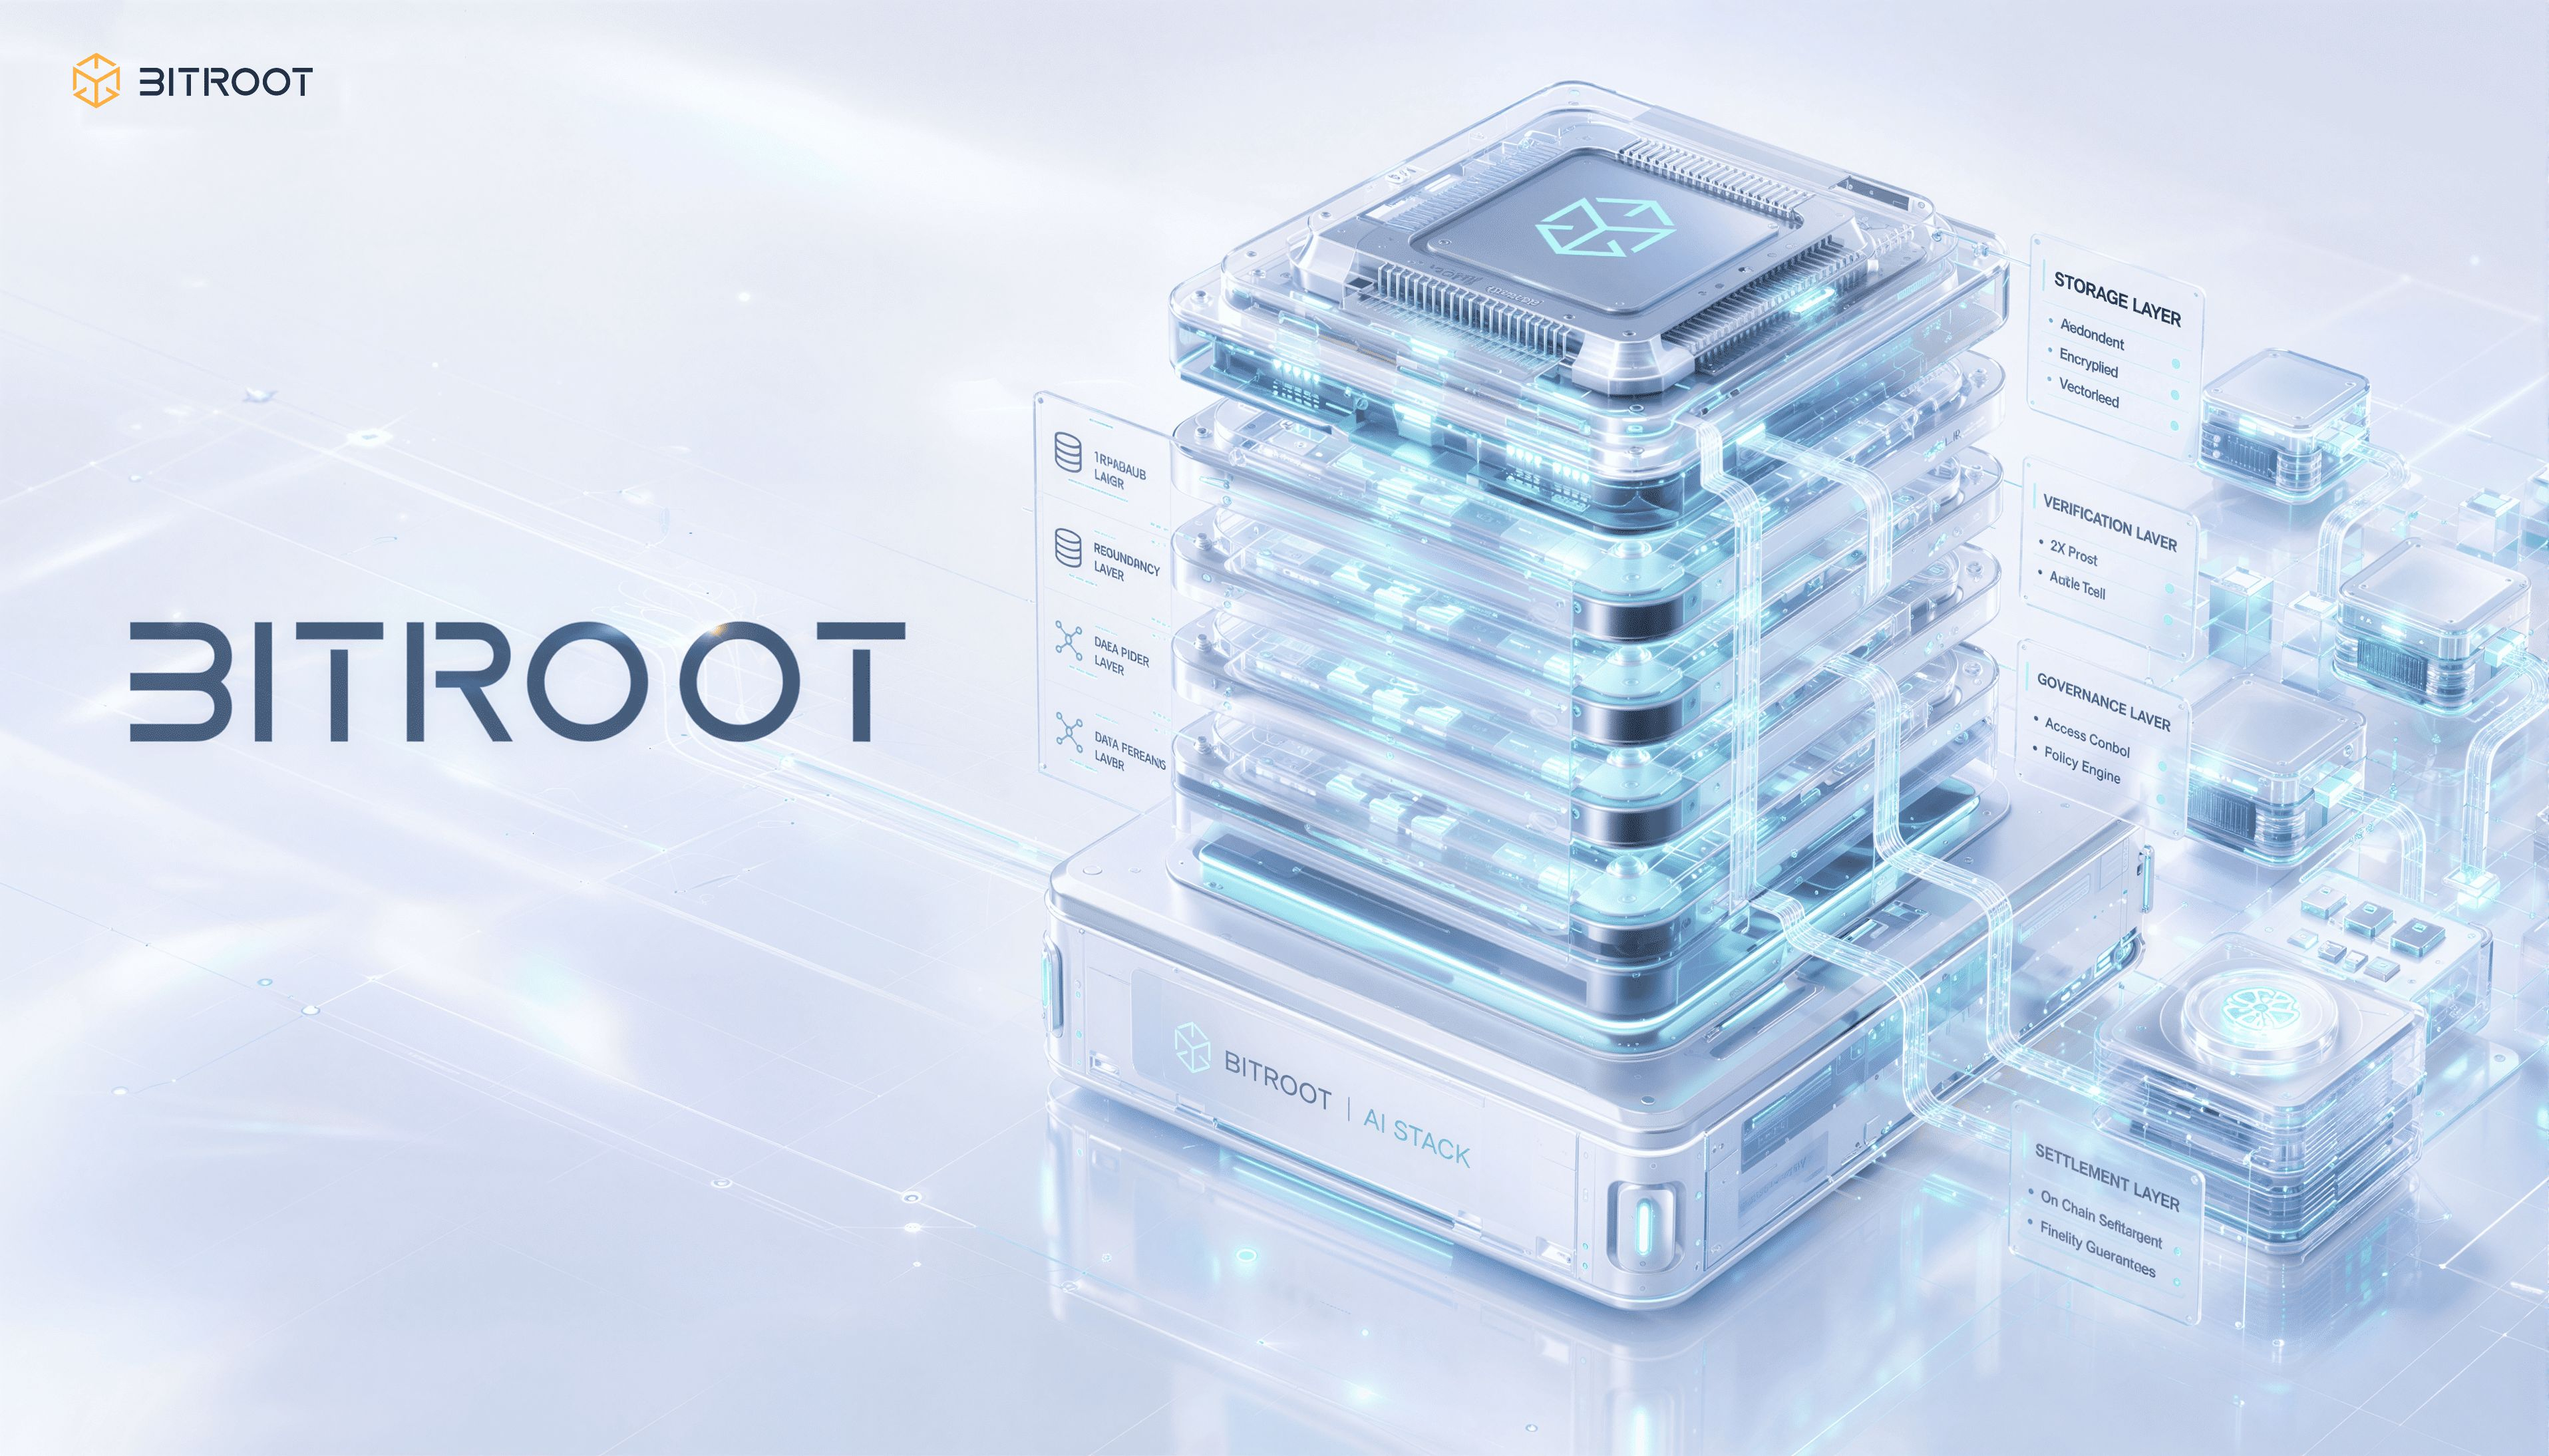
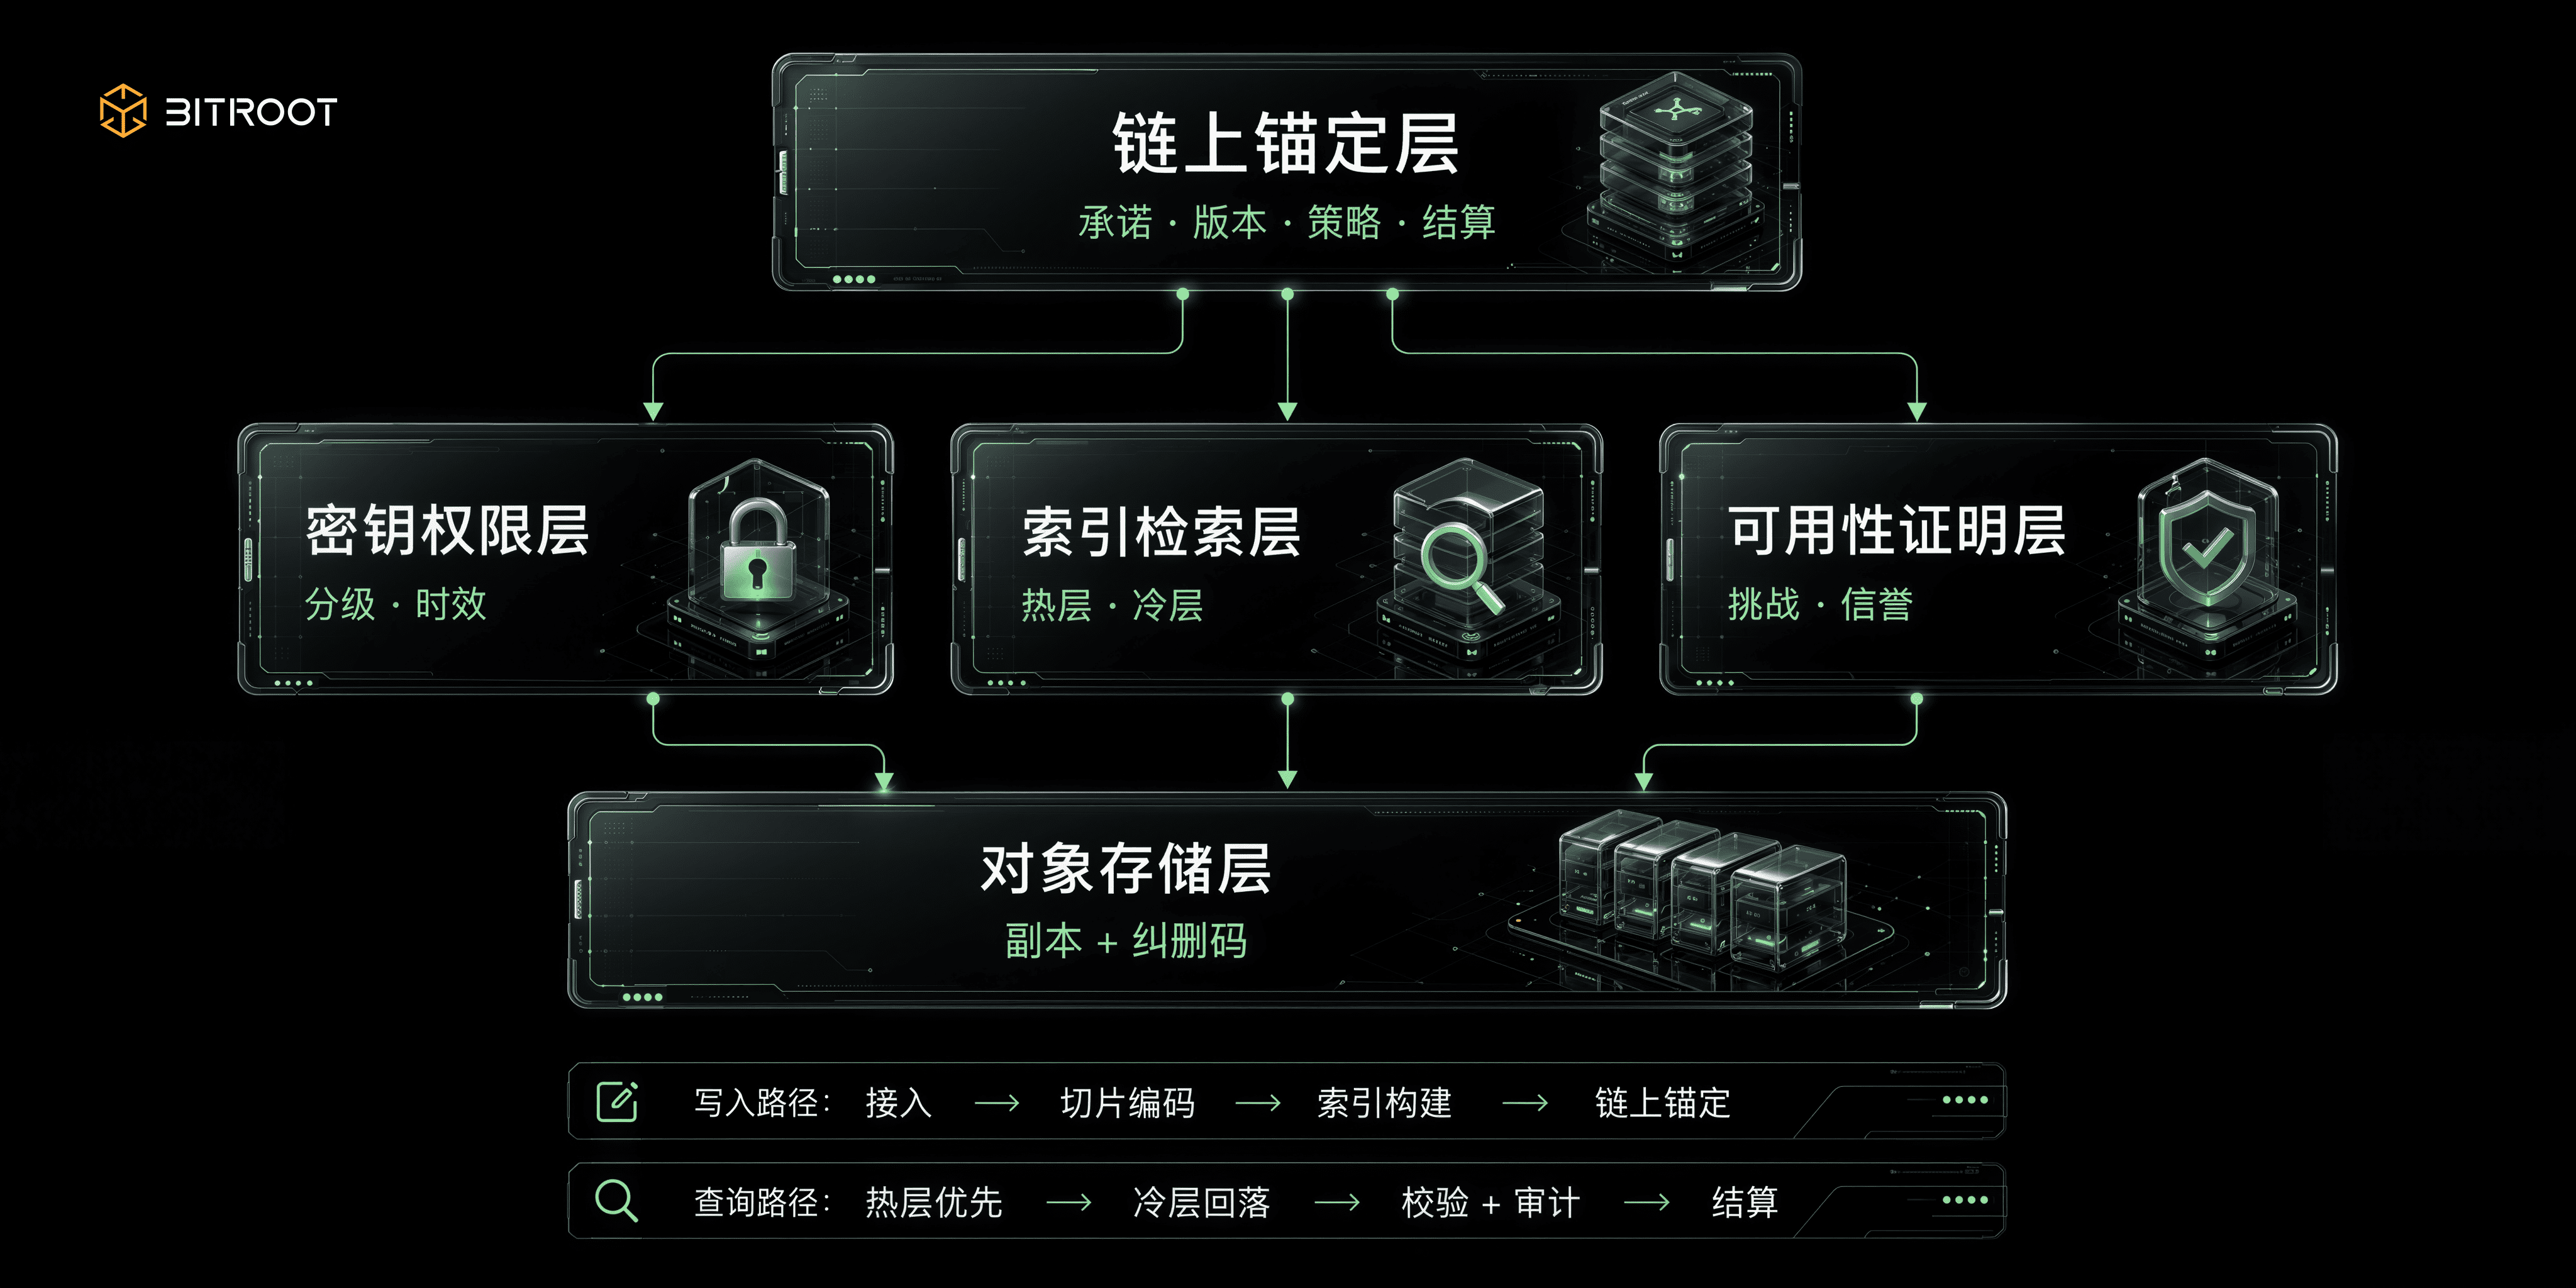
Umsetzungsvorschlag: Eine Fünf-Schichten-Architektur, die „speicherbar, abrufbar, verwaltbar“ zu einem geschlossenen Regelkreis macht. Der Wert einer Architektur liegt nicht in der Anzahl der Schichten, sondern darin, ob sie einen verifizierbaren geschlossenen Regelkreis bilden kann. Basierend auf dem vorherigen Rahmen konvergiert die Lösung auf fünf Schichten: On-Chain-Ankerungsschicht, Object-Storage-Schicht, Index-Search-Schicht, Proof-of-Availability-Schicht und Schlüsselberechtigungsschicht. Ziel ist es, „verifizierbar“ zur Standardfähigkeit zu machen, „hochperformant“ als konfigurierbare Fähigkeit zu behandeln und Governance als ausführbaren Prozess.
In Bitroot können diese fünf Schichten weiter als ein Storage-Governance-Modul für einen AI-Stack verstanden werden: Parallel EVM liefert die Möglichkeit für Hochfrequenz-Ankerung und Abrechnung, Pipeline BFT bietet schnellere Latenz und deterministische Gewissheit, das verteilte Speichernetzwerk übernimmt große Objekte und Verlaufsdaten, die Index-Search-Schicht bedient KI-Agents und Anwendungsaufrufe, die Proof-of-Availability-Schicht überführt die Dienstqualität der Knoten in Reputation und Belohnungen, und die Schlüsselberechtigungsschicht verbindet Benutzer-Souveränität, Datenschutz und kommerzielle Modellberechtigungen.
Die On-Chain-Ankerungsschicht speichert nur den minimal nötigen Zustand: Datenzusagen, Versions-Fingerprints, Zusammenfassung von Berechtigungsstrategien und Abrechnungsereignisse. Große Objekte kommen nicht auf die Kette; On-Chain werden nur die Nachweise gespeichert, dass dieses Objekt existiert und die Version korrekt ist. Das bewahrt die On-Chain-Verifizierbarkeit und verhindert zugleich, dass der Durchsatz durch große Dateien ausgebremst wird.
Im architektonischen Kontext von Bitroot ist die On-Chain-Ankerungsschicht nicht nur der Ort, um „einen Hash zu registrieren“, sondern der gemeinsame Einstieg für KI-Asset-Registrierung, Berechtigungs-Governance, Ertragsverteilung und Streitbeilegung. Datensätze, Modellgewichte, Vektorindizes und Inferenz-Logs können Off-Chain in der bestgeeigneten Weise gespeichert werden, aber die Versionszusagen, der Autorisierungsstatus, die Aufrufprotokolle und die Zuordnung der Erträge müssen als On-Chain-Zustand in Bitroot eingehen. So trägt Off-Chain den Datenumfang, Bitroot trägt das Vertrauen.
Die Object-Storage-Schicht trägt echte Daten und nutzt eine hybride Strategie aus Erasure Coding plus Replikaten: Objekte mit hohem Wert und niedriger Zugriffshäufigkeit werden stärker auf Fehlertoleranz ausgerichtet, Objekte mit mittlerem Wert und hoher Zugriffshäufigkeit stärker auf Such- und Retrieval-Effizienz. Diese Strategie ist keine statische Konfiguration, sondern passt sich dynamisch an die Zugriffshitze und die Business-Klasse an.
Die Index-Search-Schicht bringt Metadaten-Indizes und Vektorindizes in ein einheitliches Verzeichnis. Die Hot-Schicht übernimmt Online-Suchen, die Cold-Schicht übernimmt Archivierung und Rekonstruktion. Alle Indexversionen müssen die Quellendatenversion und die Build-Parameter registrieren, sonst kann ein Indexdrift nicht zur Verantwortung gezogen werden.
Die Proof-of-Availability-Schicht quantifiziert das Verhalten der Knoten. Erfolgsrate beim Bestehen von Challenges, Antwortlatenz und Reparatur-Erfolgsrate fließen in eine Reputation ein; die Reputation wird wiederum mit der Belohnungsverteilung gekoppelt, um zu vermeiden, dass nur Kapazität belohnt wird, nicht aber Verfügbarkeit.
Schlüsselberechtigungsschichten steuern Zugriff und Compliance. Für hochsensible Daten werden hierarchische Schlüssel und zeitlich begrenzte Freigaben verwendet, für Inferenz-Logs erfolgt eine Entsensibilisierungsspeicherung mit Audit- und Replay-Fähigkeit, und Modellaufrufe benötigen widerrufbare Lizenzen. Auch die Berechtigungsoperationen selbst müssen geloggt werden, um Drift bei der Konfiguration zu verhindern.
Diese fünf Schichten bilden auf der Execution-Ebene einen Closed Loop, keine einseitige Pipeline: Nach dem Daten-Import werden Daten zunächst geschnitten und in die Object-Schicht kodiert; nach dem Schreiben werden Indizes erstellt und On-Chain verankert. Online-Abfragen laufen über die Hot-Schicht; wenn ein Treffer nicht ausreicht, geht es in die Cold-Schicht. Gleichzeitig mit der Ergebnisrückgabe werden Integritäts- und Berechtigungsprüfungen ausgelöst, und zentrale Aktionen fließen in Abrechnung und Audit. Der echte Wert dieses Pfads ist, dass zu jeder Zeit und von jedem Knoten vier Fragen beantwortet werden können: Woher die Daten kommen, welche aktuelle Version gilt, wer Zugriff hat und ob das System seine Verfügbarkeit beweisen kann.
Das ist auch der entscheidende Grund, warum Bitroot sich besonders für die KI-Storage-Governance eignet. KI-Agenten-Aufrufe, Modellversionswechsel, Änderungen an Datenfreigaben und Streit über Suchergebnisse sind nicht nur seltene Backend-Aktionen, sondern On-Chain-Ereignisse, die mit dem Wachstum der Anwendung kontinuierlich auftreten. Wenn die zugrunde liegende Chain nicht genug geringe Bestätigungs-Latenz und genug hohen Durchsatz liefert, wird Storage-Governance am Ende gezwungen sein, zurück in On-Prem-Tabellen und manuellen Abgleich zu kippen. Die Kombination aus Parallel EVM und Pipeline BFT in Bitroot liefert nicht nur höhere TPS – sie ermöglicht, dass diese hochfrequenten Governance-Ereignisse in Echtzeit verankert, abgerechnet und zur Verantwortung gezogen werden.
Wer zahlt die Rechnung: Verfügbarkeit statt Kapazität bestimmt die Auszahlung Storage muss langfristig zuverlässig laufen können, und Anreize müssen auf Verfügbarkeit ausgerichtet sein, nicht darauf, Kapazität zu stapeln. Nur Kapazität belohnen heißt im Effekt: Knoten werden motiviert, Festplatten zu „horten“, und nicht, Service zu leisten. Filecoin hat dieses Problem bereits mit Mechanismen korrigiert: Es führt den Begriff „quality-adjusted power“ ein, also gewichtete Rechenleistung nach Qualität. Damit erhalten Sektoren mit realer Speicherauftragsübernahme – insbesondere solche, die durch Verifikation als „effektiv“ gelten – höheres Gewicht in der Leistungsabrechnung, als kleinste Messgröße für Speicherleistung. So wird die Belohnung in Richtung echter Servicekapazität verschoben, nicht in Richtung reiner verpackter Leer-Kapazität. Diese Denkweise lohnt sich, um jede selbst aufgebaute Incentive-Layer zu übernehmen.
Mach daraus eine ausführbare Belohnungsfunktion. Mindestens vier Dimensionen müssen gleichzeitig berücksichtigt werden, und die Gewichtungslogik muss klar sein. Die Kapazität bestimmt den Basisanteil – sie beantwortet, wie viel Raum du zugesagt hast. Online-Rate und Antwortlatenz bestimmen den Koeffizienten für Servicequalität: Sie beantworten, ob die zugesagte Kapazität dann auch wirklich abrufbar ist, wenn man sie braucht. Diese Dimension sollte ein relativ hohes Gewicht haben, sonst wird Verfügbarkeit zur Parole. Die erfolgreiche Datenwiederherstellungsrate bestimmt die Glaubwürdigkeit der Ausfallsicherheit: Sie beantwortet, ob Replikate nach einem Knoten-Offline wiederhergestellt werden können, und hängt direkt mit dem Überleben von Long-Tail-Daten zusammen. Die Datenwertdichte bestimmt den Zuschlag auf der Nachfrageseite: Für wertvolle Datensets und stark nachgefragte Modelle setzt man differenzierte Multiplikatoren, damit knappe und häufig aufgerufene Daten höhere Belohnungen erhalten. Belohnungen sollten an nachweisbaren Service gehen, nicht an behauptete Kapazität.
Nur positive Anreize reichen nicht: Auf der Constraint-Seite müssen auch Collateral (Kaution), Strafen und Schiedsmechanismen zugleich funktionieren – und zudem eine grundlegende Ungleichung erfüllen: Der erwartete Nutzen für Cheating muss unter den erwarteten Kosten liegen, die durch Strafen entstehen. Sonst wird jedes Beweis- bzw. Mechanismus-Design ökonomisch rational umgangen. Kaution zwingt Knoten, Kosten für Verfügbarkeitszusagen zu tragen, und die Höhe der Sicherstellungen sollte proportional zur zugesagten Rechenleistung und dem Datenwert sein. In Filecoins Design muss der Storage-Anbieter eine vorausliegende Sicherstellung entsprechend der zugesagten Power hinterlegen; wenn der Anbieter innerhalb des Proof-Fensters ausfällt, wird eine Ausfallgebühr ausgelöst. Wenn ein Sektor endgültig aufgegeben wird, wird eine deutlich schwerere Terminierungsstrafe fällig. Die Bedeutung dieser stufenweisen Strafen liegt darin, kurzfristige Ausfälle und böswilligen Exit unterschiedlich zu behandeln. Schiedsentscheidungen erfolgen über On-Chain-Evidenz: Wenn Nutzer behaupten, die Daten seien nicht verfügbar, während Knoten behaupten, normal zu dienen, bilden Challenge-Logs, Sampling-Beweise und Ereignisprotokolle eine maschinenlesbare Grundlage für die Entscheidung. So wird aus einer zuvor manuellen Streitbeilegung eine einzige verifizierbare On-Chain-Feststellung.
Im KI-Szenario kommt noch eine schwerere Governance-Schicht oben drauf: Wie man den Drittparteien-Ertrag aufteilt. Ein Modell, das immer wieder aufgerufen wird, basiert in der Regel auf Beiträgen mehrerer Parteien: Datenbeiträger liefern das Trainingsmaterial, Modellbeiträger investieren in Training bzw. Modellproduktion, und Storage-Knoten übernehmen das Hosting. Alle Parteien tragen zum Endwert eines Aufrufs bei, aber Beiträge sind nicht direkt beobachtbar. Ein gangbarer Ansatz ist, Wertzuweisung auf zählbare On-Chain-Ereignisse aufzubauen: Abrechnung nach Aufrufanzahl und automatische Settlement, Bindung von Daten und Modellen an jede einzelne Aufrufinstanz über Versions-Fingerprints und Abstammungs-/Blutlinien-Beziehungen (blood lineage), sowie automatische Aufteilung nach zuvor festgelegten programmierbaren Buchungsquoten – so vermeidet man Streit nachträglich. Dazu gehören eine Blacklist und ein Penalty-Mechanismus: Bei böswilligem Upload von Daten, Urheberrechtsverletzungen oder Modell-Diebstahl wird – sobald ein Schiedsentscheid anerkennt – Sicherstellung beschlagnahmt und zukünftige Erträge eingefroren. Andernfalls entsteht ein paradoxes Ergebnis: Je erfolgreicher die Assetisierung ist, desto mehr Streit über Verteilung und eindeutige Zuordnung entsteht – und am Ende ist es genau das, was das Ökosystem aus dem Vertrauen reißt.
Compliance ist kein Patch nach dem Go-Live, sondern eine Constraint-Definition in der Architekturphase: Eine Sicherheitsbasis sind Ende-zu-Ende-Verschlüsselung, hierarchisches Schlüsselmanagement und periodischer Key-Rotation. Ergänzt durch Hash-Checks und Merkle-Verpflichtungen wird das Herunterladen verifizierbar; zudem sichern mehrere Replikate und Erasure Coding die Ausfallsicherheit zusammen mit Mechanismen für Wiederherstellung bei Störungen. Datenschutz-seitig gibt es minimalen Zugriff nach Datenklassifikation; es werden widerrufbare Freigaben, Einmalfreigaben und zeitlich begrenzte Freigaben unterstützt. Wichtige Zugriffe und Operationen werden über den gesamten Pfad hinweg protokolliert, damit Audit-Replays möglich sind. Compliance ist auch der Teil, der am leichtesten nachträglich gemacht wird und am teuersten wird: Strategien zur Lokalisierung von Daten und zur Übertragung über Domänen müssen konfigurierbar sein, und es braucht standardisierte Prozess-Schnittstellen für Löschen, Zugriff und Audit-Anfragen. Das schwierigste ist der natürliche Konflikt zwischen Unveränderbarkeit und Löschbarkeit. Eine praktikable Lösung ist „kryptografisches Löschen“: Verschlüssele den Inhalt so, dass beim Zerstören der Schlüssel die Chiffre nicht mehr rückgewinnbar ist; mache zusätzlich den Index ungültig, sodass die Daten nicht mehr auffindbar sind. Unter der Voraussetzung, dass die On-Chain-Aufzeichnungen erhalten bleiben, kann man damit Löschansprüche erfüllen. Von Pilot zu Produktion gibt es drei Stufen-Gates: Erst wird ein minimal vertrauenswürdiger geschlossener Regelkreis aufgebaut – Objekt-Storage, On-Chain-Ankerung, Integritätsprüfung und Basis-Monitoring werden stabil betrieben. Die Abnahme schaut auf Verfügbarkeit, Erfolgsraten von Reads/Writes und die Übereinstimmung von Ankerung und Objektversionen sowie darauf, ob Wiederherstellungsszenarien real simuliert werden können. Danach erfolgt die KI-Assetisierung und Index-Governance: Einführung von Daten- und Modell-Asset-Management, Versionslinien, Hot/Cold-Schichtung des Vektorindex, Modellberechtigungen und Aufruf- und Trainingsdaten-Quellregistrierung. Die Abnahme schaut dann auf Nachvollziehbarkeit beim Training, Rollback- und Auditierbarkeit von Modellen, ob die Hot-Schicht-Latenzziele eingehalten werden und ob der Einfluss von Index-Neuaufbauten kontrollierbar bleibt. Schließlich kommen verifizierbare Suche und automatisierte Governance: Einführung von Challenge-Beweisen, Policy-Migration und Automatisierung von Belohnungen und Strafen. Die Abnahme schaut auf die Abdeckung der Proofs-of-Availability, Latenz bei Risikobehandlung, Rückgang der Einheitkosten und nachvollziehbare sowie rollback-fähige Policy-Änderungen. Das Metriksystem ist ein Strategiesystem, nicht eine reine Ausstellungs-/Reporting-Tabelle. Wenn man nur technische Punkte schreibt, ohne die Business-Ergebnisse zu nennen, bricht die Storage-Lösung zu einem reinen Kosten-Center zusammen. Empfehlung: drei Ebenen trennen – Basis-Technikmetriken (Verfügbarkeit, P95/P99-Latenzen, Durchsatz, RTO/RPO, Fehlerquote) beantworten, ob das System gesund ist; KI-Spezialmetriken (Trainingsdaten-Nachvollziehbarkeitsrate, Modell-Reproduzierbarkeitsrate, Abdeckungsgrad der Inferenzvalidierung, Indexkonsistenz) beantworten, ob die Modellqualität gouverniert werden kann; und Business-Ergebnismetriken (Datenbereitstellungswachstum, sinkende Aufrufkosten, aktive Knoten, Asset-Transaktionsvolumen) beantworten, ob das System Wert schafft. Zwischen den drei Ebenen braucht es Abbildungen, denn die eigentliche Nutzung der Metriken ist Input zur Strategieoptimierung – nicht eine Reporting-Ausgabe. Die häufigsten fünf Fehlerquellen kann man im Wesentlichen vorab vermeiden: Nur Storage machen, keine Versions-Governance; Daten als verfügbar erachten, ohne dass sie wirklich verfügbar sind, und verfügbar ist nicht automatisch reproduzierbar; nur Kapazität anschauen statt Proof-of-Availability; Belohnung nach Kapazität verführt zu „viel Speicher anhäufen, wenig Service leisten“; Hot/Cold-Schichtung machen, aber keine Synchronisationsstrategie – Indexversionen synchronisieren und Invalidierung nicht als Closed-Loop behandeln; Compliance-Strategie zu spät nachziehen – je später man bei Permissions, Logs, Entsensibilisierung und Löschantworten ergänzt, desto höher wird der Preis; Übergangsarchitektur ohne Exit-Mechanismus: Zuerst zentralisiert und dann dezentralisiert ist ein sinnvoller Weg, aber fehlende Migrationsschwellen führen dazu, dass der Übergang dauerhaft wird und vom ursprünglichen Ziel abweicht.
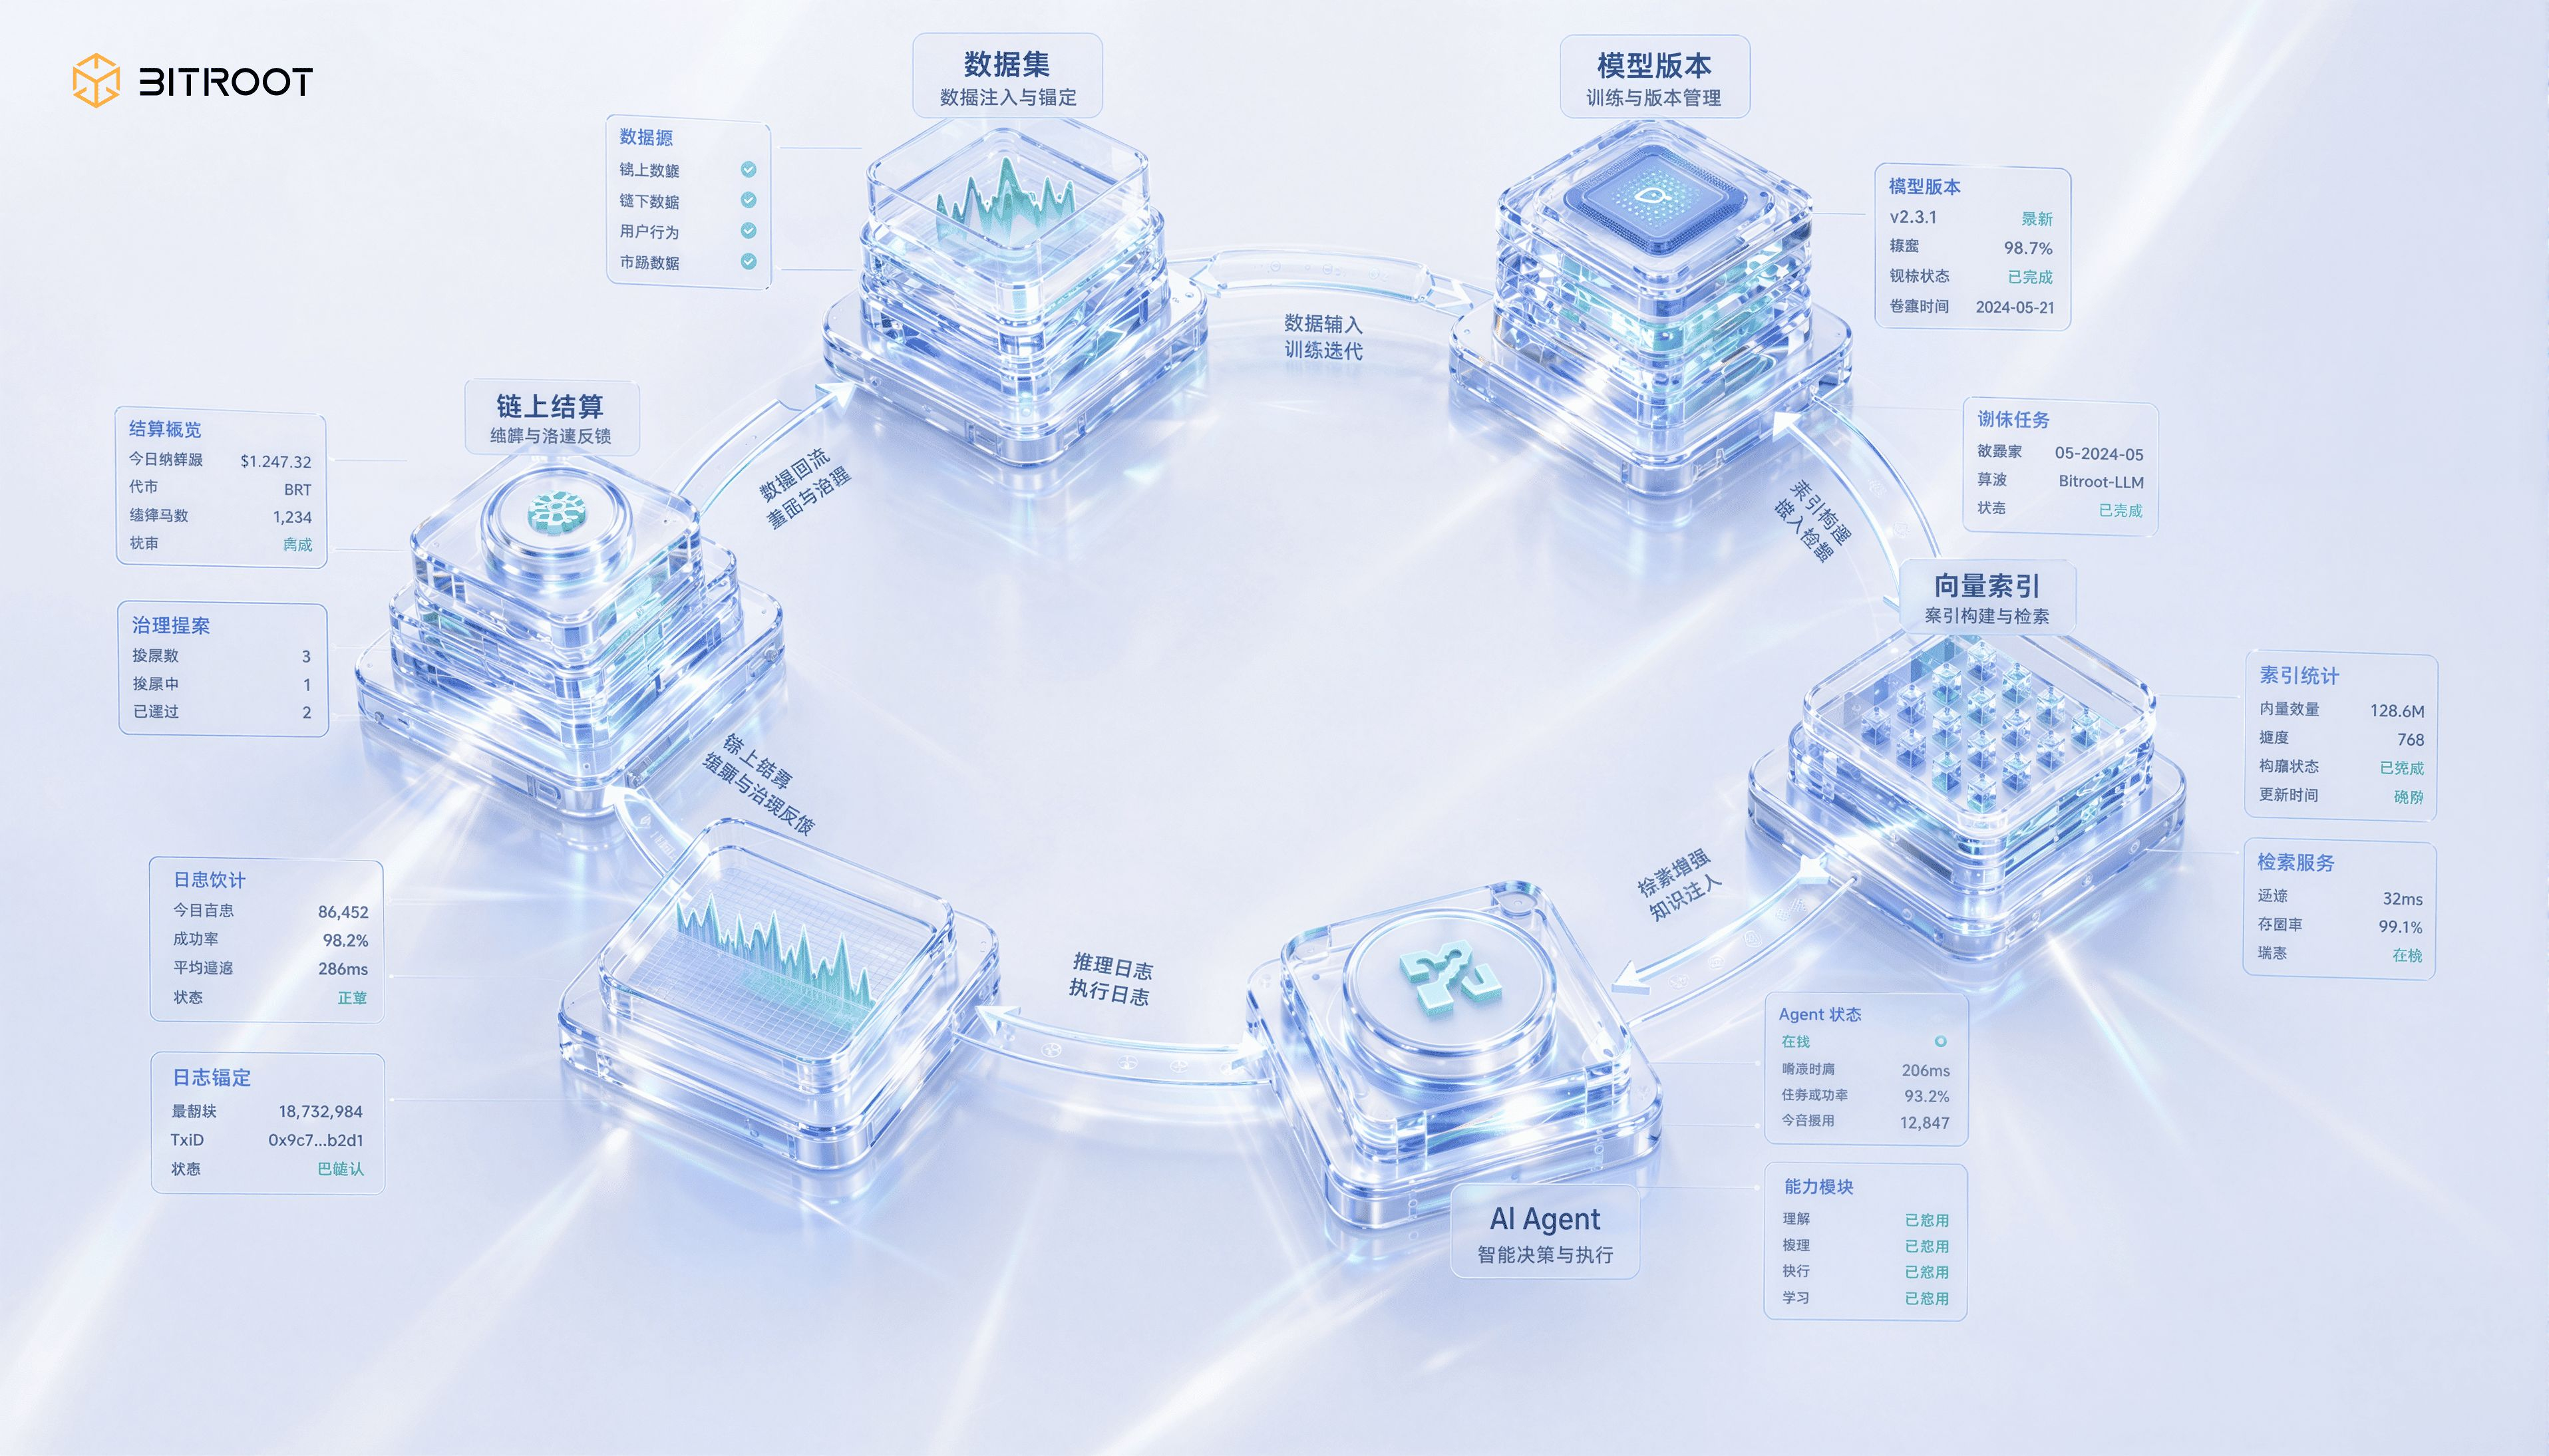
Bitroots vollständiger geschlossener Regelkreis: Von Daten und Modellen bis zum KI-Agent – in diesem Regelkreis kann Bitroot jede zentrale Aktion von KI-Assets in abrechenbare Ereignisse umwandeln: Datensatzregistrierung, Modellversion-Release, Vektorindex-Neuaufbau, KI-Agent-Aufruf, Inferenzlog-Ankerung, Berechtigungsfreigabe und -widerruf, Streitbeiträge und Schiedsspruch-Ergebnisse. On-Chain müssen nicht alle Daten getragen werden, aber diese minimal nötige Evidenz für die Handlungen muss zwingend. Nur so bleibt das Wertverhältnis zwischen Daten, Modellen, Rechenleistung und Anwendungen nicht bei mündlichen Zusagen stehen, sondern wird zu programmierbarer Buchführung und auditierbarer Governance.
Wenn man dieses Mechanismus-Set in Bitroots Betrieb und Ökosystem-Erweiterung einbettet, sollte Storage-Incentivierung nicht als separater Hardware-Subventionsmechanismus entworfen werden, sondern als Teil des Wertstroms des AI-Stacks: Datenbeiträger erhalten Erträge, weil ihre Daten für Training oder Aufrufe genutzt werden. Modellbeiträger erhalten Erträge für Modellservices. Storage- und Search-Knoten erhalten Erträge für fortlaufend verfügbare, low-latency Dienste. Validierungs- und Challenge-Knoten erhalten Belohnungen dafür, dass sie Unverfügbarkeit, Indexdrift oder Berechtigungsanomalien entdecken. So belohnt das ökonomische System von Bitroot nicht „du hast mal hochgeladen“, sondern „du bist dauerhaft nachweisbar nützlich“.
Storage ist kein Kostenblock, sondern ein System für Vertrauen und Wertverteilung. Was im AI-Zeitalter verteiltes Storage lösen muss, ist nicht, ein bestimmtes Object-Storage-Produkt zu ersetzen, und auch nicht, eine dezentrale Erzählung zu verfolgen. Es sind vier härtere Dinge: vertrauenswürdige Beweise für langfristige Verfügbarkeit, Governance-Ordnung für Zusammenarbeit über mehrere Akteure, Daten- und Modell-Verantwortungsketten und nachhaltige ökonomische Anreize.
Ein Single-Protocol, Single-Layer-Architektur kann diese Ziele nicht abdecken. Ein realistischer Weg ist eine kombinierte Architektur: Content Addressing garantiert Integrität, Storage Proof garantiert die Verfügbarkeit über die Zeitdimension, die permanente Schicht garantiert kritische Historie, die Hot-Schicht garantiert das Online-Erlebnis und die On-Chain-Ankerung garantiert governbare Prozesse inklusive verifizierbarer Abrechnung. Das ist keine Kompromisslösung, sondern Ingenieursrationalität. Der Fokus bei der Umsetzung liegt auch nicht darauf, dass die Funktionalität am vollständigsten ist, sondern darauf, dass der geschlossene Regelkreis zuerst funktioniert: erst den minimal vertrauenswürdigen Closed-Loop stabil zum Laufen bringen, dann AI-Assetisierung, verifizierbare Suche und automatisierte Governance schrittweise darüberstapeln.
Wenn man diese Methode auf eine Woche komprimiert, gibt es im Grunde nur drei Schritte: Am ersten Tag wird eine Acht-Felder-Dateninventarliste fertiggestellt, am dritten Tag wird in einem echten Business-Domain ein einmaliger Minimalpfad durchlaufen – von der Anbindung über Storage, Suche bis hin zur Verifizierung. Am siebten Tag wird mit P95-Latenz und Einheitkosten ein Migrationsschwellen-Review gemacht. Wenn man diese drei Schritte erreicht, wechselt das Team von Konzept-Übereinstimmung in Engineering-Übereinstimmung.
Man muss auch eine reale Grenze anerkennen: Egal welche Protokollkombination man wählt – es gibt immer Trade-offs zwischen Kosten, Latenz und Persistenz; keine einzelne „Einheitslösung“ ist für alle Business-Szenarien gleichzeitig optimal. Wirklich nachhaltige Lösungen entstehen aus klaren Abgrenzungen und fortlaufender Iteration, nicht aus einer einmaligen Entscheidung und dann jahrelang statischer Konfiguration.
Einen Projekt auszumustern liegt in der Regel nicht daran, dass TPS zu niedrig ist, sondern daran, dass die Daten-Verantwortungskette nicht klar ist. Im Zeitalter der KI-öffentlichen Chains heißt Storage nicht, Daten einfach „hineinzulegen“, sondern Daten jederzeit beweisbar zu machen.
Schlusswort
Der echte Wettbewerb öffentlicher KI-Chains wird sich am Ende nicht nur auf Vergleiche von TPS, Gas oder Bestätigungszeiten beschränken. Performance ist der Einstieg, aber nicht das Finale. Im Zeitalter KI-nativer Anwendungen muss das On-Chain-System nicht nur Transaktionen tragen, sondern auch Datenversionsstände, Modellaufrufe, Scheduling von Rechenleistung, Inferenzprotokolle, Agent-Verhalten und die Aufteilung der Erträge über mehrere Parteien.
Das ist auch Bitroots Einschätzung für die Storage-Schicht: Storage ist kein nebensächliches Modul, sondern die Schicht im AI-Stack, die dem Ursprung des Werts am nächsten ist. Ob Daten beweisbar sind, ob Modelle reproduzierbar sind, ob Aufrufe auditierbar sind, ob Erträge automatisch verteilt werden können – das bestimmt, ob ein dezentralisiertes KI-Netzwerk wirklich langfristige Lebenskraft hat.
Nicht das bauen, was nur auf schnelleres Ausführen optimiert ist, sondern eine Infrastruktur, mit der KI-Assets bestätigt, aufgerufen, abgerechnet und governed werden können. Parallel EVM und Pipeline BFT lösen die Tragfähigkeit für hochfrequente On-Chain-Ereignisse. Verteiltes Storage und verifizierbare Mechanismen bilden die Vertrauensgrundlage für KI-Daten und Modelle, und programmierbare Buchführung sowie On-Chain-Governance machen Beiträge zu fortlaufenden ökonomischen Anreizen.
Wenn KI-Agents beginnen, stellvertretend für Nutzer zu handeln; wenn Modelle und Daten zu handelbaren Assets werden; und wenn Rechenleistung, Storage und Inferenzdienste in ein gemeinsames Wertnetz eintreten, ist Storage nicht mehr das Problem „wo man Dateien ablegt“.
Es wird zur Vertrauensbasis öffentlicher KI-Chains werden und auch zum Value-Distribution-System für das nächste Generation intelligente Netzwerk.
Aus Sicht von Bitroot ist in der Zukunft nicht entscheidend, wer die meisten Daten besitzt, sondern wer Daten zu jedem Zeitpunkt beweisbar, aufrufbar und zur Verantwortung ziehbar macht und sie letztlich an der Wertabrechnung teilhaben lässt.
Über Bitroot Bitroot ist ein Layer-1-Blockchain-Projekt mit Fokus auf parallele Ausführung und einer KI-nativen Architektur. Bitroot setzt auf eine EVM-kompatible technische Roadmap und erforscht mit Hilfe von parallelen Ausführungsmechanismen, Konsens-Optimierungen und KI-relevanten Schnittstellendesigns eine leistungsstarke und kostengünstige On-Chain-Ausführungsumgebung für KI-Agents, DeFi und Web3-Anwendungen.
Mach mit bei uns:
Website: https://bitroot.co/
Twitter:https://twitter.com/Bitroot_
Telegram: https://t.me/bitroot_official