
Im Juni ist in Nordostchina Regenzeit, die feuchte und klebrige Luft und der unaufhörliche Regen draußen machen einen unruhig. Passend dazu ist heute der letzte Moment der \u003cc-74/\u003e-\u003ct-76/\u003e-Aufgabe, und die Luft um mich herum ist erfüllt mit dem Drang, ins Auto zu steigen und den großen Slogan 'AI-Zeitalter der Daten-Gleichheit' zu rufen. Ich habe mir eine Tasse bitteren Kaffee gemacht, starre auf den Bildschirm, auf die aufregenden alten Nachrichten über die Zusammenarbeit von OpenLedger und Story Protocol zur Einführung der 'AI automatischen Urheberrechtsverifizierung' und falle in eine lange und schmerzhafte emotionale Achterbahnfahrt.
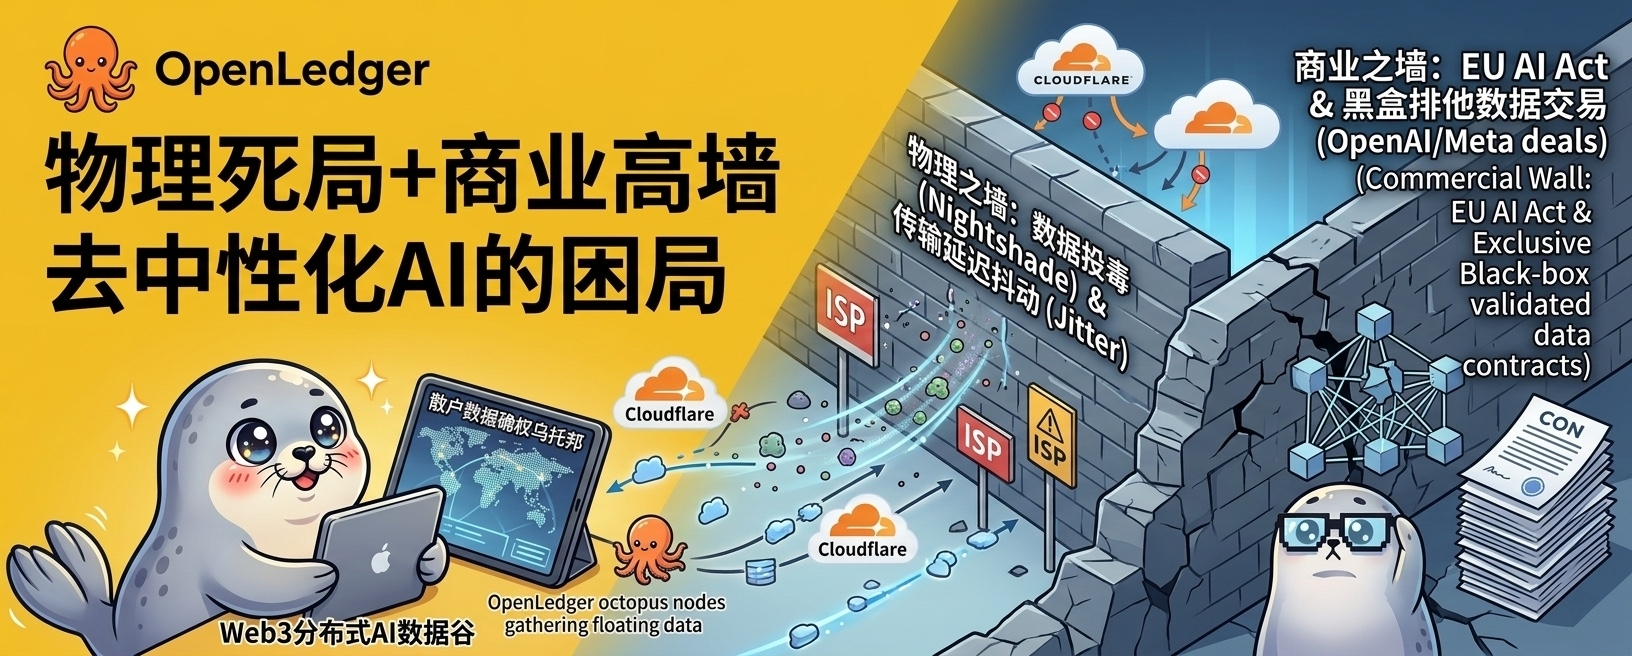
Heute, als ich mich zwang, aus einer einseitigen rechtlichen Perspektive auszubrechen und das gesamte technische Blueprint und den geschäftlichen Kreislauf mit einem Netzwerktechniker- und maschinellen Lernansatz zu betrachten, fühlte sich das ursprüngliche Staunen an wie eine platzende Blase, die nur kalte Luft hinterlässt - ich stellte fest, dass diese großartige Erzählung vor den hohen Mauern der physikalischen Gesetze, Datensicherheit und realen Geschäftsrecht schwach war wie ein mit Wasser vollgesogenes Blatt Papier.
Ein atemberaubender Anfang: Früher habe ich auch aufgestanden und applaudiert.
Man muss zugeben, dass \u003cm-33/\u003e und Story Protocol gemeinsam eine Vision entworfen haben, die auf rein logischer Ebene sehr überzeugend ist. In der traditionellen AI-Wertschöpfungskette stehen Schöpfer, Datenreiniger und Edge-Nodes stets am unteren Ende der Nahrungskette. Giganten wie OpenAI und Google, ausgestattet mit enormer Rechenleistung und Rechtsteams, saugen skrupellos kostenlose Daten aus der ganzen Welt, um ihre Modelle zu trainieren. Das von \u003ct-35/\u003e vorgeschlagene Datanets (gemeinschaftliche Besitz-Datensätze) und ModelFactory zielt genau auf dieses Schmerzproblem ab. Es kombiniert sich mit dem Story Protocol und schafft einen nahezu perfekten geschlossenen Kreislauf: Retail-Investoren tragen Daten über Nodes bei, OpenLedger nutzt Proof of Attribution (Beweis der Beitragserbringung), um jeden Beitrag zu AI-Modellen auf der Blockchain zu dokumentieren; sobald dieses Modell in der kommerziellen Anwendung aufgerufen wird (Inference), wird das zugrunde liegende Protokoll des Story Protocols automatisch ausgelöst, um die Honorare in Form von Mikrotransaktionen (Micro-transactions) über den OPEN-Token in Echtzeit an die ursprünglichen Datenbeitrager auszuzahlen.
Ist das nicht unsere Vorstellung von einer absolut fairen Web3 verteilten KI-Utopie? Um ehrlich zu sein, als ich das erste Mal dieses Design sah, wollte ich fast aufstehen und applaudieren. Aber gerade diese logische Kohärenz ließ mich in den folgenden Tagen bei jeder Entdeckung einer Gefahr mehr ein Gefühl des Schmerzes empfinden.
Die tödliche Schwachstelle unter dem Schatten von 'Nightshade': Dezentrale Konsensmechanismen können 'Datenvergiftung' nicht verhindern.
OpenLedger betont seit jeher, dass seine Datanets qualitativ hochwertiges Trainingsmaterial produzieren können. Aber hier gibt es ein riesiges, nahezu unlösbares logisches Paradoxon: Der Konsensmechanismus eines dezentralen Netzwerks kann nur bestätigen, ob die Daten 'übereinstimmen', kann jedoch die 'absolute Richtigkeit' der Daten in der physischen Welt nicht überprüfen.
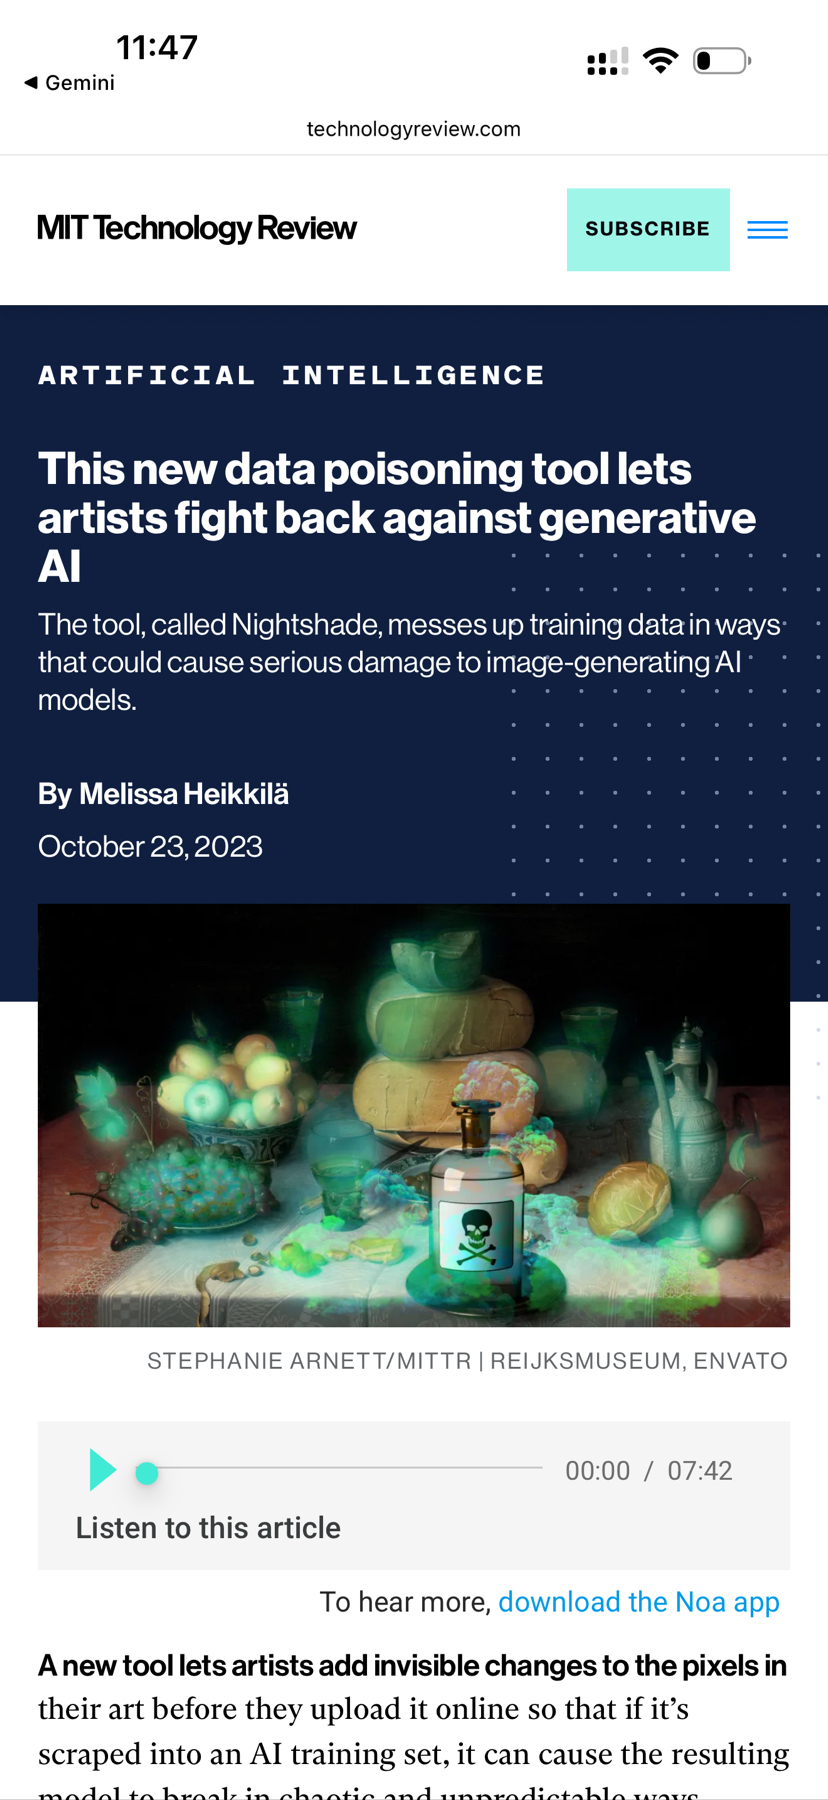
Schon 2023 hat das Team der University of Chicago ein adversariales AI-Vergiftungswerkzeug namens Nightshade herausgebracht, das in Geek-Kreisen für Aufsehen sorgte. Siehe Abbildung. Die erschreckende Fähigkeit dieses Werkzeugs besteht darin, Bilder oder Texte auf Pixel-Ebene so zu verändern, dass es mit bloßem Auge nicht wahrnehmbar ist. Du siehst eine Katze, aber das zugrunde liegende Vektor des AI-Modells identifiziert sie als Hund.
Jetzt, was passiert, wenn dieses schreckliche Werkzeug in das verteilte Netzwerk von OpenLedger eingeführt wird?
In einem dezentralen, erlaubnisfreien Netzwerk kann jeder Node Daten einreichen. Wenn eine böswillige Hackergruppe oder ein Konkurrent ein Tool wie Nightshade verwendet, um eine riesige Menge an Daten 'unsichtbar zu vergiften', und diese dann über zehntausende anonyme Nodes ins OpenLedger-Netzwerk hochlädt, wird der Konsensalgorithmus des Netzwerks nur die Hashwerte oder das Format dieser Daten auf Compliance prüfen; Nodes könnten sogar aus gemeinsamen Interessen diesen 'Vergiftungsdaten' zustimmen. Was passiert? Sobald das B2B-AI-Modell diese kontaminierten dezentralen Daten erwirbt, wird die neuronale Netzwerk-Gewichtung des gesamten Modells katastrophal beschädigt, was in der maschinellen Lernwelt als 'Model Collapse' bezeichnet wird.
In traditionellen zentralisierten Unternehmen gibt es strenge interne Trennungen und Verantwortungsmechanismen für die Datenbereinigung; in einem vollständig verteilten Netzwerk, wer ist verantwortlich für 'Vergiftung'? Wenn die 'Reinheit' der Daten nicht zu 100 % garantiert werden kann, wer von den Milliarden-Dollar-AI-Einhörnern würde sein Kernmodell in die Hände eines anonymen Netzwerks legen, das jederzeit von böswilliger Vergiftung betroffen sein könnte? Bei diesem Gedanken zieht es mir wirklich die Luft aus der Lunge. Die sogenannte 'Datenverifizierung' setzt voraus, dass es sich um 'gute Daten' handelt. Wenn man sich gegen adversiale Vergiftung nicht schützen kann, sind die Produkte dieses Netzwerks nur ein Haufen teuren digitalen Mülls.
Physikalischer Fluch der Latenzschwankung (Jitter): Der Albtraum der Unternehmens-AI-Pipeline.
Der zweite Punkt, der meine psychologischen Abwehrlinien bricht, sind die extrem realistischen physischen Hardware-Wände. Wenn du in letzter Zeit die Entwicklungen im Silicon Valley verfolgt hast, weißt du, dass Dinge wie Groq's LPU (Language Processing Unit), die speziell für AI-Inferenz entwickelt wurden, oder Nvidias neueste Blackwell-Architektur, sich wild um eine Kennzahl bemühen: extrem niedrige Latenz und hohe Kohärenz im Datendurchsatz. Die Datenverarbeitungspipeline (Pipeline) moderner kommerzieller AI erfordert, dass die Datenübertragungsverzögerung zwischen Vektordatenbanken und Verarbeitungseinheiten auf Mikrosekunden (Microsecond) Niveau liegt. Und was für ein Netzwerk will OpenLedger aufbauen? Es möchte sich auf Endgeräte verlassen, die weltweit verteilt sind und unterschiedlichste Netzwerkbedingungen haben, um Daten verteilt zu reinigen und vektorisierte Verarbeitung zu ermöglichen.
Ich habe mich mit einem Kollegen, der praktische Erfahrung mit cloud-nativen Deployments hat, tief in dieses Feld eingearbeitet und fand diese Architektur schlicht absurd. Deine Knoten in Japan haben gerade mit Netzwerküberlastungen zu kämpfen, oder die Knoten im Nahen Osten haben heute eine langsame Breitbandverbindung, und schon schießt die 'Latenzschwankung (Jitter)' der gesamten Datenverarbeitungskette in die Höhe. Für B2B-AI-Anwendungen, die absolute Stabilität und Echtzeit-Feedback verlangen, sind mehrere hundert Millisekunden oder sogar Sekunden an Übertragungsverzögerung und Paketverlust unakzeptable Katastrophen. Sie versuchen, mit der politischen Korrektheit von 'Dezentralisierung' die physikalischen Gesetze der Lichtgeschwindigkeit und Netzwerktopologie herauszufordern. Das ist, als würde man mit zehntausend zusammengebauten Traktoren versuchen, einen Boeing 747-Motor zu ziehen, der eine extrem hohe Synchronisationsrate benötigt. Das Konzept ist sexy, die Umsetzung ist ernüchternd.
Als ich diese zwei physikalischen Dilemmata übereinanderlegte, wurde das anfängliche Staunen durch eine fast kalte Rationalität vollständig ersetzt.
Die unsichtbaren Kosten der Retail-IP.
Im Verlauf der allmählichen Beruhigung der Emotionen gibt es einen weiteren Aspekt, der mir einen kalten Schauer über den Rücken jagt, den ich an dieser Stelle noch einmal ansprechen muss: die physikalische Belagerung, die bereits in der realen Welt gegen die dezentrale Datensammlung stattfindet.
\u003ca-63\u003eIch habe bereits in einem früheren kurzen Artikel ausführlich über die von Cloudflare 2024 eingeführte Funktion 'One-Click-AI-Web-Crawler-Blockierung' berichtet.\u003c/a-63\u003e
Kurz gesagt, wenn ein privater Breitbandknoten unwissentlich die Firewall einer Zielwebsite berührt, wird die Wohn-IP sofort von internationalen CDNs als 'böswillige Angriffsquelle' markiert. Dieser Schlag trifft direkt die Kapillaren, auf denen das Überleben des OpenLedger-Netzwerks beruht, und wirft einen dichten Schatten auf die Erzählung von 'Jeder trägt bei, jeder profitiert'.
Fehlender kommerzieller Kreislauf: Wer zahlt für das 'On-Chain-Hype' unter dem Schatten des EU-AI-Gesetzes?
Noch frustrierender ist die völlige Entkoppelung dieses automatischen Honorarmechanismus von den realen rechtlichen und kommerziellen Beschaffungslogiken. Wir müssen eine extrem harte Realität anerkennen: Die 'Urheberrechte' und 'Honorare', die von dezentralen Netzwerken definiert werden, haben in den rechtlichen Bereichen der traditionellen Web2 AI-Giganten keine Fähigkeit zur Durchsetzung von Rückerstattungen oder zur Einhaltung von Vorschriften. Im Jahr 2026 haben Unternehmen wie OpenAI und Meta ihre Kernrechtstrategien bereits in die Höhe von 'Fair Use' verwandelt oder direkt exklusive Black-Box-Datenlizenzvereinbarungen mit großen Mediengruppen geschlossen. Diese B2B-Giganten, die das absolute Rederecht in der Branche haben, finden keinerlei geschäftliche Anreize, um sich mit einem dezentralen Honorarabrechnungssystem zu vernetzen, das von anonymen Retail-Investoren in einer rechtlichen Grauzone besteht. Ohne diese größten Käufer wird OpenLedgers automatischer Honarzahlung-Mechanismus letztlich nur zu einem 'On-Chain-Hype' werden, den Entwickler für sich selbst und sich selbst spielen.
\u003ca-21\u003eEin konkretes Beispiel, wie die Wall Street Journal berichtete, hat OpenAI über 250 Millionen Dollar ausgegeben, um die Exklusivrechte der News Corp zu erwerben, habe ich bereits in einem früheren kurzen Artikel analysiert.\u003c/a-21\u003e
Zum Beispiel berichtet Reuters, dass Google und Reddit bereits 2024 einen jährlichen AI-Datenvertrag über 60 Millionen Dollar abgeschlossen haben.
Der eiserne Vorhang der EU-Regulierung hat diesen ohnehin schon schmalen Weg fast vollständig versperrt. Mit der schrittweisen Umsetzung des EU AI Acts ist die 'Reinheit' der Trainingsdaten für große Modelle auf ein beispielloses politisches und rechtliches Niveau angehoben worden. Ab August 2025 müssen Anbieter von allgemeinen AI-Modellen eine 'ausreichend detaillierte' Zusammenfassung der Trainingsdateninhalte offenlegen und strenge Datenverwaltungs- und Urheberrechtskonformitätsstrategien umsetzen; bei hochriskanten AI-Systemen müssen die Dateninputs sogar nachverfolgbar, unvoreingenommen und frei von Urheberrechtsverletzungen sein. Kürzlich hat die EU-Kommission klar gefordert, dass alle inländischen Anbieter von Basis-Modellen Prüfberichte über die Datenquellen und Reinigungsprozesse vorlegen müssen; jede Datenquelle, die unbekannt oder potenziell verletzungsgefährdet ist, kann zur sofortigen Stilllegung des gesamten Modells führen.
Unter diesen nahezu strengen Anforderungen an die Datenvererbung (Data Lineage) hat OpenLedger's Datanets fast jede Mine betreten. Seine verteilte Pipeline ist auf Tausende von nicht verifiziertem KYC-Node angewiesen, um Daten hochzuladen und vorläufig zu reinigen; selbst wenn nur einer dieser Nodes absichtlich eine kleine Menge geschützter 'Vergiftungsdaten' hinzufügt, kann die Compliance des gesamten Datensatzes in der Kette sofort zusammenbrechen. Kein kommerzielles AI-Unternehmen würde sein Milliarden-Investment in das Training eines Modells, das das Kerngeschäft trägt, riskieren, um auf die Datenreinheit eines anonymen Netzwerks zu setzen. Egal wie hoch die Ideale der Dezentralisierung sind, vor den kalten Compliance-Prüfberichten kann kein 'Community-Konsens' die rechtliche Gültigkeit der Whitelist-Verifizierung ersetzen.
Fazit | Halte das Feuer am Leben, aber zahle nicht mehr für physikalische Dilemmata und geschäftliche Illusionen.
Draußen regnet es weiter, der Kaffee in meiner Tasse ist längst kalt. Ich bin kein Fan von OpenLedger, im Gegenteil, ich bin ein begeisterter Unterstützer von DeAI. Ich erkenne die ingenieurtechnischen Durchbrüche der OpenLoRA-Architektur in Bezug auf die Effizienz bei der Bereitstellung auf einer einzelnen GPU an, sowie die Weitsicht des Gründers Pryce Adade-Yebesi. Doch wenn ich alle glänzenden Hüllen abstreife, sehe ich eine schwache Konsensstruktur, die hilflos gegen adversiale Datenvergiftung ist; eine zugrunde liegende Architektur, die den Anforderungen an extrem niedrige Latenzzeiten für Unternehmens-AI nicht standhält; ein Geschäftsmodell, das in der Klemme zwischen realen Urheberrechtsgesetzen und den Beschaffungsstrategien der Giganten keinen Halt findet. Dies ist keineswegs das Ergebnis meiner Verzweiflung über den DeAI+DePIN-Sektor, ganz im Gegenteil, ich wünsche mir so sehr, dass dieser Sektor überlebt, dass ich keine weiteren Projekte mehr tolerieren kann, die ohne kommerzielle Käufer, ohne rechtliche Ausnahmen und ohne echten IP-Schutz die privaten Nodes und IP-Assets der Retail-Investoren an die Front schicken, um den Zorn der Giganten abzuwehren.
Bevor die Offiziellen einen echten, von einer Drittpartei geprüften 'Anti-Datenvergiftung (Anti-Data Poisoning) Drucktestbericht' vorlegen, der beweist, dass ihre Netzwerk-Latenz den industriellen Anforderungen an die Vektorrecherche genügt, und bevor sie einen echten Finanzbericht vorlegen, der eine konforme Einkaufsbestellung mit einem weltklasse Web2 AI-Giganten enthält, werde ich meine Erwartungen auf den Nullpunkt senken. Jede Vision von 'trillionen automatischen Gebühren' muss in meinen Augen mit dem erforderlichen Risikozuschlag abgezogen werden. Halte die Beteiligung auf einem Minimum, bewahre das Feuer, aber erweitere nicht blind das Risiko der Vermögensaussetzung - in diesem ganzen von Erzählfallen durchzogenen Juni ist es vielleicht das Einzige, was wir uns an Anstand bewahren können, die Kühle und Rationalität eines Ingenieurs zu bewahren.
Ich habe den Bildschirm ausgemacht, die Kälte verweilt noch lange.
\u003cc-59/\u003e