Gestern habe ich API-Berechtigungen für ein Projekt beantragt, das Formular ausgefüllt und drei Tage gewartet. Dann kam eine E-Mail zurück: „Nicht genehmigt“ – ohne Angabe von Gründen. So hat man am Ende einfach umsonst gewartet.
Diese Art Black-Box-Genehmigung ist in Web2 viel zu häufig. Du weißt überhaupt nicht, wo es blockiert, und selbst wenn du etwas ändern willst, hast du keine Ansatzpunkte.
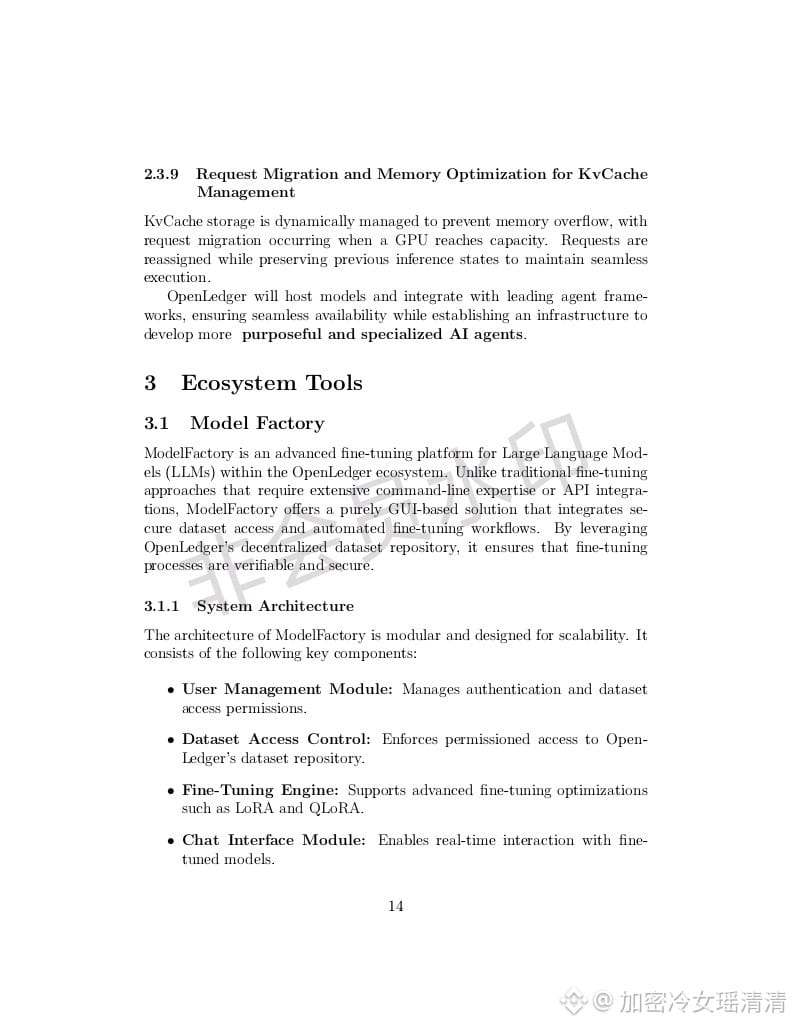
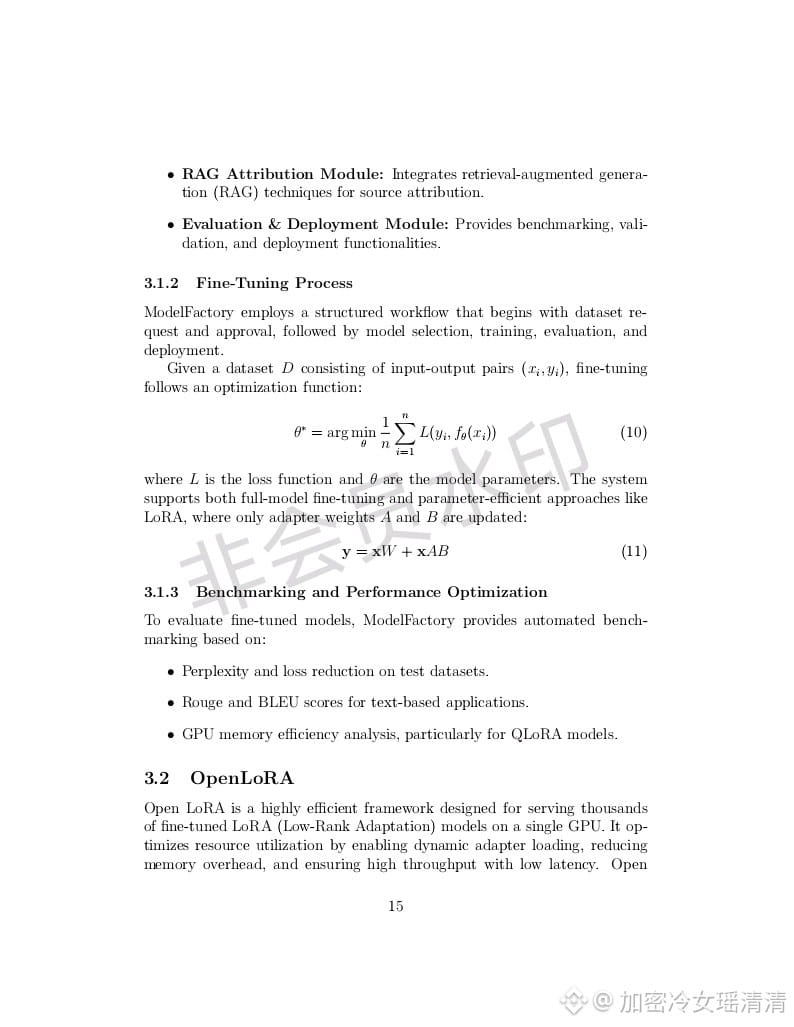
OpenLedgers ModelFactory macht den Zugriff auf Datensätze zu einem On-Chain-Freigabeprozess. Du musst zuerst ein bestimmtes Datanet-Fein-tuning-Modell nutzen, dafür eine erste Einzahlung von $OPEN hinterlegen und dann die Anfrage starten. Nachdem der Datenanbieter die Anfrage erhält, entscheidet er per Abstimmung, ob er dir die Berechtigung gibt. Das Abstimmungsergebnis und die Gründe werden vollständig auf der Kette gespeichert. Wenn sie ablehnen, kannst du außerdem sehen, wer gegen gestimmt hat und aus welchen Gründen.
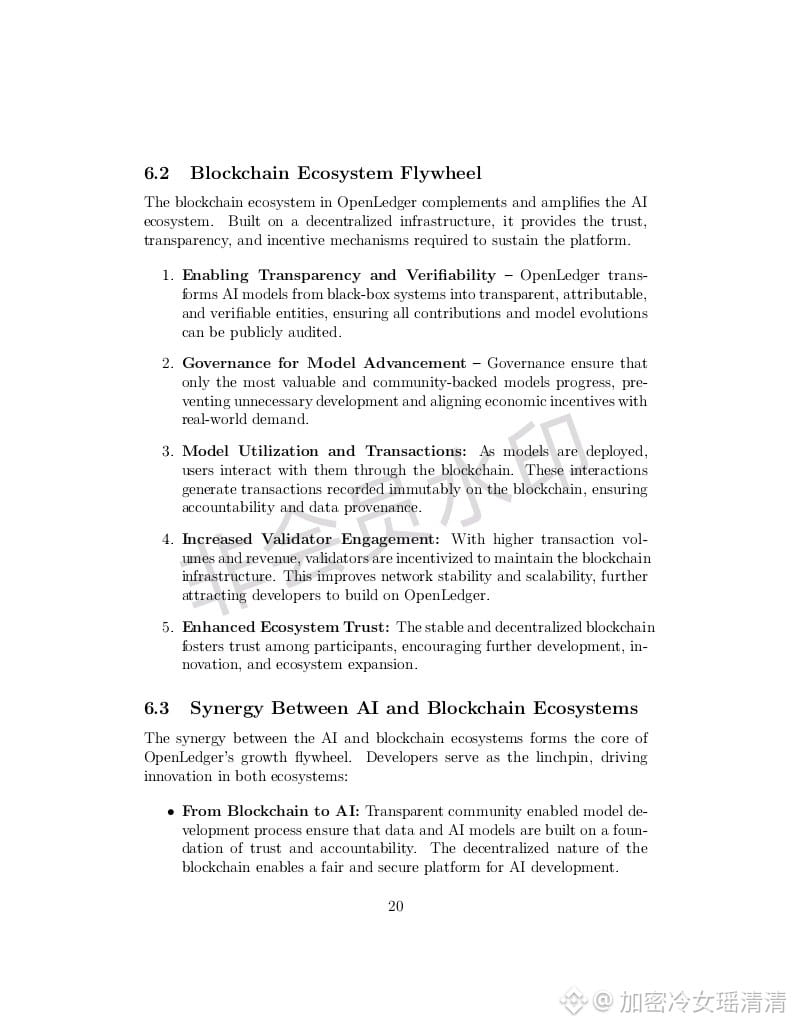
Ich habe in das Whitepaper geschaut: Es nutzt ein Multisig-Mechanismus, nicht eine einzige Datenquelle, die allein entscheidet. Ein Datensatz kann mehrere Beitragende haben. Jeder erhält Stimmrechte entsprechend seiner Gewichtung nach Beitrag. Wenn du die Daten erhalten willst, brauchst du Zustimmung über einem bestimmten Schwellenwert. Dieses Design verhindert, dass Datenanbieter ihre Macht missbrauchen – zum Beispiel, indem sie dich aus persönlicher Abneigung einfach willkürlich ablehnen.
Außerdem wird nach einer Ablehnung die hinterlegte $OPEN auf demselben Weg zurückerstattet, es wird nichts abgezogen. Eine Strafe (Einbehalt der Kaution) gibt es nur dann, wenn du die Daten nach Erhalt in Verstoßfällen missbrauchst und es von den Verifizierern entdeckt wird. Das ist ziemlich sinnvoll: Es unterscheidet klar zwischen „Antrag gescheitert“ und „regelwidrige Nutzung“. Im Gegensatz zu manchen Projekten, die bei jedem Fehlversuch sofort Geld abziehen – das ist reines Abzocke.
Ich habe die Daten-Genehmigungsprozesse anderer KI-Plattformen verglichen: Die meisten werden weiterhin von zentralen Administratoren kontrolliert. Du hast nicht einmal einen Beschwerde- oder Einspruchskanal. Der frühe Mining-Pool einiger Projekte war auch zentralisiert – später wurde er nach und nach durch P2P-Mining-Pools ersetzt, weil viele gemerkt haben, dass Machtkonzentration Korruption begünstigt. Auch bei Ether-Intelligent-Contracts gab es die gleiche Entwicklung: von zentraler Prüfung hin zu dezentraler Verifizierung. OpenLedgers On-Chain-Abstimmungsfreigabe repliziert im Kern denselben Weg – nur eben mit dem Szenario „Zugriffskontrolle auf Datensätze“.
Ich habe aber auch ein Problem erkannt: Wenn datenreiche Parteien mit hohem Stimmgewicht sich kollektiv gegen einen bestimmten Antragsteller stellen, könnten sie ihn theoretisch dauerhaft sperren. Im Whitepaper stehen keine konkreten Maßnahmen gegen eine mögliche Kollusion. Diese Schwachstelle muss geschlossen werden.
Ich werde abwarten, bis es ein paar reale Genehmigungsfälle gibt, und dann bewerten, ob dieses Mechanismus fair ist.@OpenLedger #OpenLedger
Diese Art Black-Box-Genehmigung ist in Web2 viel zu häufig. Du weißt überhaupt nicht, wo es blockiert, und selbst wenn du etwas ändern willst, hast du keine Ansatzpunkte.
OpenLedgers ModelFactory macht den Zugriff auf Datensätze zu einem On-Chain-Freigabeprozess. Du musst zuerst ein bestimmtes Datanet-Fein-tuning-Modell nutzen, dafür eine erste Einzahlung von $OPEN hinterlegen und dann die Anfrage starten. Nachdem der Datenanbieter die Anfrage erhält, entscheidet er per Abstimmung, ob er dir die Berechtigung gibt. Das Abstimmungsergebnis und die Gründe werden vollständig auf der Kette gespeichert. Wenn sie ablehnen, kannst du außerdem sehen, wer gegen gestimmt hat und aus welchen Gründen.
Ich habe in das Whitepaper geschaut: Es nutzt ein Multisig-Mechanismus, nicht eine einzige Datenquelle, die allein entscheidet. Ein Datensatz kann mehrere Beitragende haben. Jeder erhält Stimmrechte entsprechend seiner Gewichtung nach Beitrag. Wenn du die Daten erhalten willst, brauchst du Zustimmung über einem bestimmten Schwellenwert. Dieses Design verhindert, dass Datenanbieter ihre Macht missbrauchen – zum Beispiel, indem sie dich aus persönlicher Abneigung einfach willkürlich ablehnen.
Außerdem wird nach einer Ablehnung die hinterlegte $OPEN auf demselben Weg zurückerstattet, es wird nichts abgezogen. Eine Strafe (Einbehalt der Kaution) gibt es nur dann, wenn du die Daten nach Erhalt in Verstoßfällen missbrauchst und es von den Verifizierern entdeckt wird. Das ist ziemlich sinnvoll: Es unterscheidet klar zwischen „Antrag gescheitert“ und „regelwidrige Nutzung“. Im Gegensatz zu manchen Projekten, die bei jedem Fehlversuch sofort Geld abziehen – das ist reines Abzocke.
Ich habe die Daten-Genehmigungsprozesse anderer KI-Plattformen verglichen: Die meisten werden weiterhin von zentralen Administratoren kontrolliert. Du hast nicht einmal einen Beschwerde- oder Einspruchskanal. Der frühe Mining-Pool einiger Projekte war auch zentralisiert – später wurde er nach und nach durch P2P-Mining-Pools ersetzt, weil viele gemerkt haben, dass Machtkonzentration Korruption begünstigt. Auch bei Ether-Intelligent-Contracts gab es die gleiche Entwicklung: von zentraler Prüfung hin zu dezentraler Verifizierung. OpenLedgers On-Chain-Abstimmungsfreigabe repliziert im Kern denselben Weg – nur eben mit dem Szenario „Zugriffskontrolle auf Datensätze“.
Ich habe aber auch ein Problem erkannt: Wenn datenreiche Parteien mit hohem Stimmgewicht sich kollektiv gegen einen bestimmten Antragsteller stellen, könnten sie ihn theoretisch dauerhaft sperren. Im Whitepaper stehen keine konkreten Maßnahmen gegen eine mögliche Kollusion. Diese Schwachstelle muss geschlossen werden.
Ich werde abwarten, bis es ein paar reale Genehmigungsfälle gibt, und dann bewerten, ob dieses Mechanismus fair ist.@OpenLedger #OpenLedger