Eine Sache, die ich zu schätzen gelernt habe, während ich sowohl KI als auch Krypto verfolge, ist, dass die wichtigste Infrastruktur oft Jahre vor dem Zeitpunkt aufgebaut wird, an dem der Markt ihren Zweck vollständig versteht.
Gerade jetzt konzentrieren sich die meisten Diskussionen darauf, welches KI-Modell das intelligenteste, schnellste oder fähigste ist. Aber die tiefere Herausforderung könnte nicht die Intelligenz selbst sein. Die eigentliche Frage ist, woher diese Intelligenz ihr Wissen bezieht.
Während sich KI weiterentwickelt, wird Daten zu einem zunehmend kritischen Engpass. Nicht, weil es nicht genug davon gibt, sondern weil es immer schwieriger wird, vertrauenswürdige, hochwertige Daten zu identifizieren. Da KI-generierte Inhalte das Internet überfluten, wird es jeden Tag schwieriger, echte Informationen von synthetischem Lärm zu trennen.
Das ist ein Grund, warum OpenLedger meine Aufmerksamkeit auf sich gezogen hat.
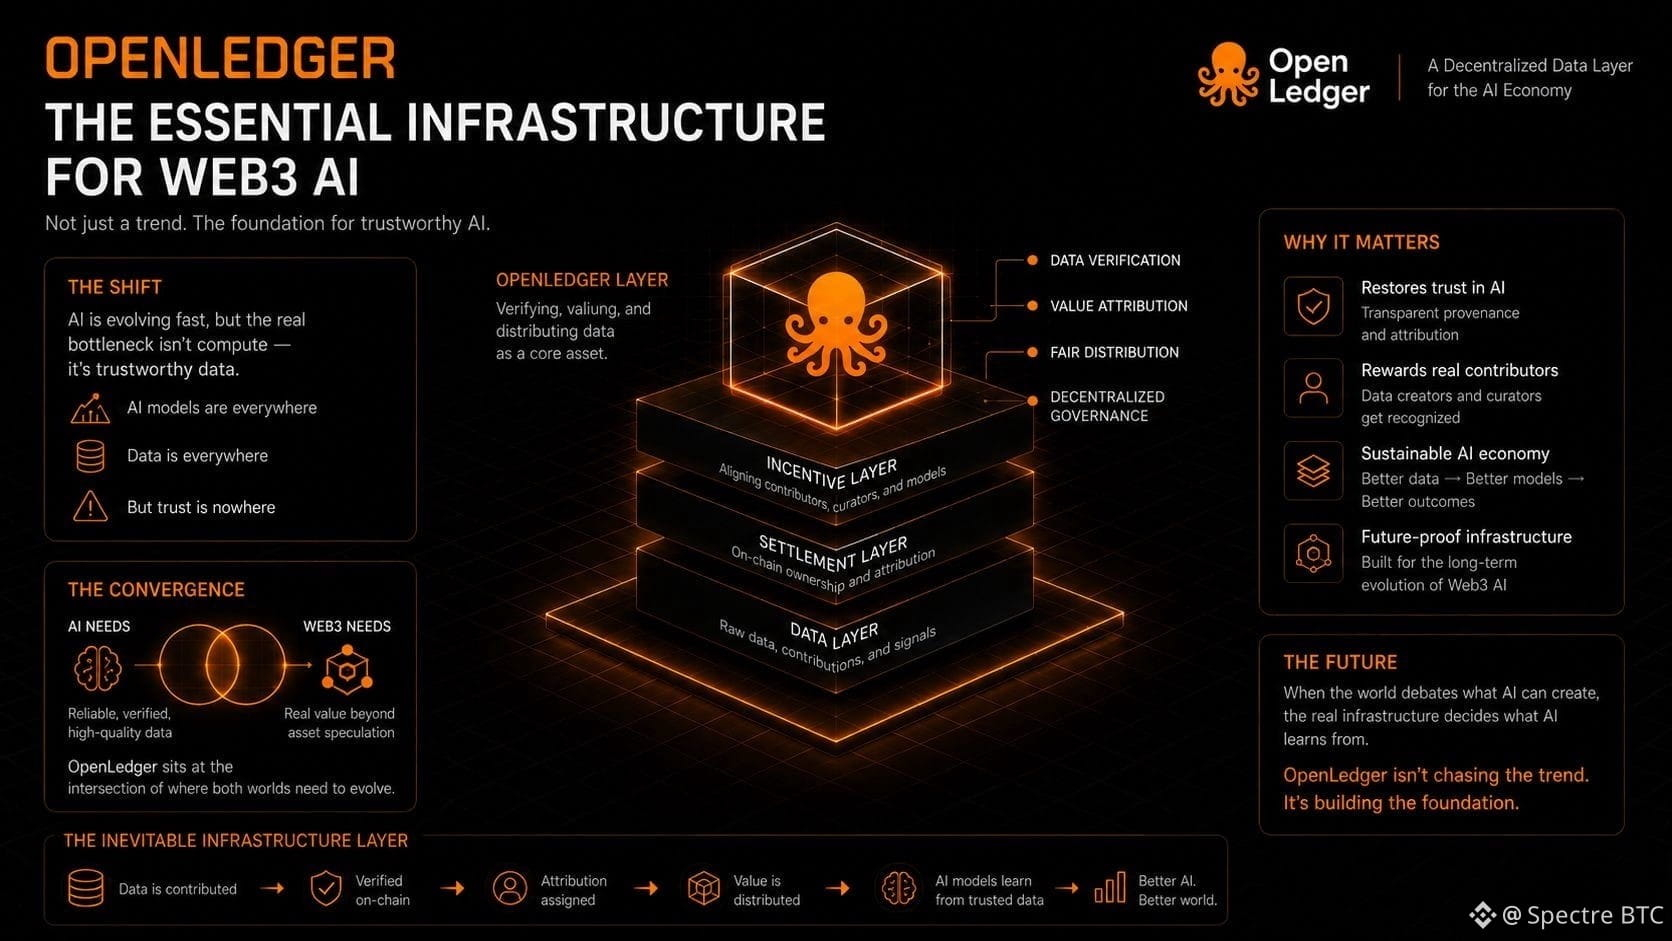
Anstatt zu konkurrieren, um ein weiteres KI-Modell zu starten, scheint OpenLedger darauf fokussiert zu sein, die Infrastruktur zu schaffen, die benötigt wird, um wertvolle Daten zu verifizieren, zu incentivieren und zu verteilen. In einer Zukunft, in der Daten eines der wichtigsten digitalen Assets werden, könnte diese Schicht zunehmend wichtig werden.
Besonders interessant ist, wie es an der Schnittstelle von KI und Web3 sitzt. KI hängt von zuverlässigen Daten ab, um sich zu verbessern, während Web3 weiterhin nach Mechanismen sucht, die über einfache Asset-Transfers hinaus Werte schaffen. OpenLedger scheint dort positioniert zu sein, wo diese beiden Bedürfnisse aufeinandertreffen.
Ob dies ein grundlegendes Stück der zukünftigen KI-Infrastruktur wird, bleibt ungewiss. Aber während sich ein großer Teil des Marktes darauf konzentriert, was KI produzieren kann, könnte die wichtigere Frage sein, was KI lernt - und wer von der Bereitstellung dieses Wissens profitiert.
#OpenLedger $OPEN @OpenLedger
Gerade jetzt konzentrieren sich die meisten Diskussionen darauf, welches KI-Modell das intelligenteste, schnellste oder fähigste ist. Aber die tiefere Herausforderung könnte nicht die Intelligenz selbst sein. Die eigentliche Frage ist, woher diese Intelligenz ihr Wissen bezieht.
Während sich KI weiterentwickelt, wird Daten zu einem zunehmend kritischen Engpass. Nicht, weil es nicht genug davon gibt, sondern weil es immer schwieriger wird, vertrauenswürdige, hochwertige Daten zu identifizieren. Da KI-generierte Inhalte das Internet überfluten, wird es jeden Tag schwieriger, echte Informationen von synthetischem Lärm zu trennen.
Das ist ein Grund, warum OpenLedger meine Aufmerksamkeit auf sich gezogen hat.
Anstatt zu konkurrieren, um ein weiteres KI-Modell zu starten, scheint OpenLedger darauf fokussiert zu sein, die Infrastruktur zu schaffen, die benötigt wird, um wertvolle Daten zu verifizieren, zu incentivieren und zu verteilen. In einer Zukunft, in der Daten eines der wichtigsten digitalen Assets werden, könnte diese Schicht zunehmend wichtig werden.
Besonders interessant ist, wie es an der Schnittstelle von KI und Web3 sitzt. KI hängt von zuverlässigen Daten ab, um sich zu verbessern, während Web3 weiterhin nach Mechanismen sucht, die über einfache Asset-Transfers hinaus Werte schaffen. OpenLedger scheint dort positioniert zu sein, wo diese beiden Bedürfnisse aufeinandertreffen.
Ob dies ein grundlegendes Stück der zukünftigen KI-Infrastruktur wird, bleibt ungewiss. Aber während sich ein großer Teil des Marktes darauf konzentriert, was KI produzieren kann, könnte die wichtigere Frage sein, was KI lernt - und wer von der Bereitstellung dieses Wissens profitiert.
#OpenLedger $OPEN @OpenLedger