

@OpenLedger | $OPEN | #OpenLedger
Ich möchte ehrlich sein, wo das beginnt.
Nicht mit Aufregung. Auch nicht mit Skepsis. Mit einer Frage, die mich wirklich beschäftigt – und die meiner Meinung nach wichtiger ist als die meisten Gespräche, die gerade rund um dieses Projekt stattfinden.
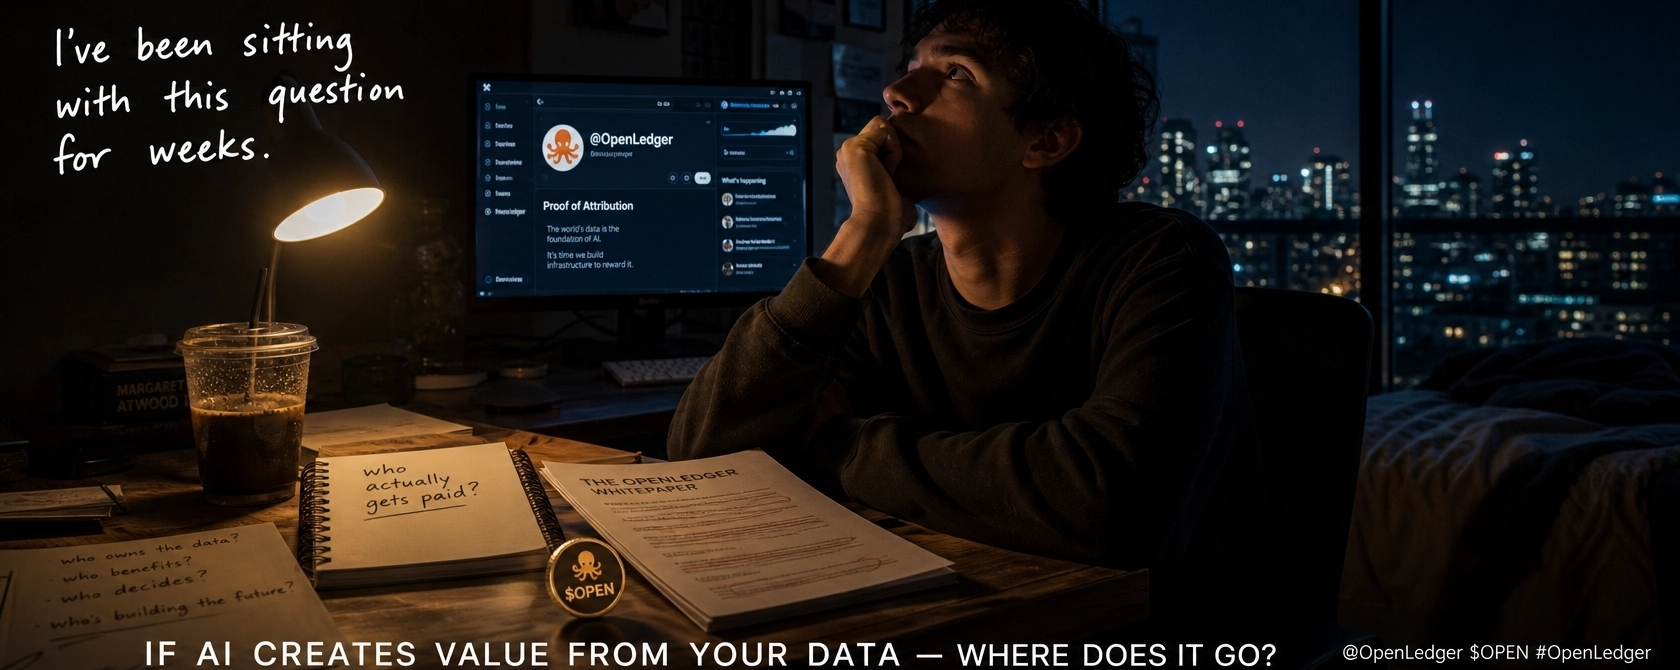
Wenn KI aus menschlichen Daten Wert schöpft – und das tut sie eindeutig – wohin fließt dieser Wert eigentlich?
Nicht philosophisch. Mechanisch. Wohin fließt es? Wer fängt es ein? Welche Infrastruktur entscheidet?
Im Moment ist die Antwort: zentrale Unternehmen. Ihre Pipelines. Ihre Modelle. Ihre Bilanz.
@OpenLedger versucht, das zu ändern. Das Projekt adressiert das, was es als grundlegende Ungerechtigkeit in der heutigen AI-Wirtschaft bezeichnet — zentralisierte Unternehmen profitieren von Modellen, die auf öffentlichen Daten trainiert sind, während die ursprünglichen Beitragsleistenden keine Anerkennung oder Vergütung erhalten. (BitDegree)
Diese Darstellung klingt sauber. Das tut sie immer in diesem Stadium. Was ich tun möchte, ist, jede Schicht auseinanderzuziehen und ehrlich zu sein, was ich tatsächlich verifizieren kann — und worüber ich noch unsicher bin. 👇
Die Architektur zuerst. Denn die Details sind wichtig.
OpenLedger ist als EVM-kompatibler OP Stack Rollup mit AltLayer als RaaS-Partner aufgebaut — das bedeutet, es funktioniert mit vertrauten Ethereum-Tools, Wallets und Brücken. Der OPEN-Token dient als Gas auf der L2 und treibt die auf Zuordnung basierenden Belohnungen an. (Fear & Greed Meter)
Drei Werkzeuge stehen im Mittelpunkt von allem:
Datanets sind geteilte, gemeinschaftlich besessene Daten-Netzwerke mit überprüfbarer Herkunft. ModelFactory ist ein No-Code-Dashboard zum Feintuning und Testen von AI-Modellen. OpenLoRA ist ein kosteneffizientes Servierungssystem, das Tausende von Modellen pro GPU hosten kann. (Fear & Greed Meter)
Und dann gibt es das Stück, das die gesamte These macht oder bricht.
Proof of Attribution ist auf Protokollebene eingebettet, wodurch Datenquellen kryptografisch mit Modellausgaben verknüpft sind. Dies ermöglicht es den Beitragsleistenden, proportional zu dem Einfluss ihrer Daten auf Inferenz belohnt zu werden, unter Verwendung effizienter mathematischer Annäherungen zur Berechnung des Datenimpacts in Echtzeit. (Binance)
Auf dem Papier ist das elegant. Daten gehen rein, Modell trainiert, Inferenz passiert, Zuordnung berechnet, Belohnung fließt automatisch zurück.
Die Frage, zu der ich immer wieder zurückkehre, ist nicht, ob der Mechanismus existiert. Es ist, ob die Genauigkeit der Zuordnung hält, wenn Datenflüsse geschichtet, rekursiv und durch anreizgetriebenen Beitrag kontaminiert werden.
Weil das passiert, wenn man Geld an die Teilnahme bindet. Die Leute optimieren für die Metrik, nicht für das Ergebnis. Qualität ist schwerer zu messen als Quantität. Und Systeme, die Beiträge belohnen, belohnen oft das Aussehen von Beiträgen schneller, als es jemand geplant hat. 🔍
OctoClaw ist der Teil, auf den die meisten Leute schlafen.
OctoClaw verbindet On-Chain-Ausführung und Datenabruf und reduziert die Reibung für Benutzer, die zuvor auf mehrere Tools angewiesen waren. Es vereint Ausführung, Orchestrierung und Automatisierung — als Antwort auf die Nachfrage nach effizienten, skalierbaren Lösungen in Web3. (Spoted Crypto)
OctoClaw ist live — bauen, automatisieren und in Echtzeit mit AI-Agenten ausführen. Wähle deinen Anbieter und dein Modell. Setze die Intelligenzschicht, die die Entscheidungen und die Ausführung deines Agenten steuert. (MEXC Blog)
Hier beginnt die Grenze zwischen AI als Werkzeug und AI als Akteur zu verschwimmen. Ein Modell zu trainieren, ist passive Infrastruktur. Ein Agent, der in Echtzeit handelt, ist etwas anderes. Die Kontrollfrage — wer entscheidet, was der Agent tut, und was passiert, wenn er etwas Unerwartetes tut — wird wichtiger, nicht weniger, je reifer die Ausführungsschicht wird.
Ich sage nicht, dass OctoClaw gefährlich ist. Ich sage, dass die Grenze zwischen hilfreicher Automatisierung und autonomem Handeln schneller verschiebt, als es die meisten Benutzer realisieren, und ich möchte die Governance um diese Grenze verstehen, bevor ich kritische Workflows darauf aufbaue.
Die Zahlen, die mir etwas Vertrauen geben.
25 Millionen+ Transaktionen On-Chain. 20.000 Modelle werden verfolgt. Mainnet seit November 2025 live. (Fear & Greed Meter)
Unterstützt von Polychain Capital und Borderless Capital, mit Beratern wie Balaji Srinivasan, Sreeram Kannan und Sebastien Borget. (Milk Road)
Die Partnerschaft mit dem Story Protocol hat einen neuen Standard geschaffen, der legales AI-Training mit automatischen Zahlungen an Rechteinhaber ermöglicht — ein Problem an der Schnittstelle von IP-Recht und AI, das sonst niemand glaubwürdig On-Chain angegangen ist. (Milk Road)
Das sind keine Schönheitsmetriken. Polychain schreibt keine Schecks für Narrative. Das Story Protocol arbeitet nicht mit Projekten zusammen, die keine echte Infrastruktur aufbauen. Das institutionelle Signal hier ist echt.
Aber institutionelle Legitimität und tatsächliche Benutzeradoption sind unterschiedliche Dinge. Ich habe gesehen, wie gut finanzierte Infrastrukturprojekte leise gestorben sind, weil die Nachfrage, für die sie gebaut haben, später ankam, als es der Token-Freigabeplan erlaubte.
Die Angebotsstruktur — und warum September 2026 wichtig ist.
Bei TGE wurden 215,5 Millionen OPEN-Token liquid — 50 Millionen für Liquidität, 145,5 Millionen für Community-Belohnungen, 20 Millionen für das Bootstrapping des Ökosystems. Community- und Ökosystem-Token begannen ab dem ersten Monat auf einer 48-monatigen linearen Kurve freizugeben. (MacroMicro)
Team- und Investorenallokationen haben eine Cliff-Periode von 12 Monaten, gefolgt von 36 Monaten linearer monatlicher Vesting. (MacroMicro)
Diese Cliff endet im September 2026. $OPEN handelt derzeit bei etwa $0.26 mit einer Marktkapitalisierung von $54M — deutlich gesunken von seinem Allzeithoch von $1.83. (Binance)
Hier ist die Spannung, die ich nicht sauber lösen kann.
Wenn die organische Nachfrage aus echtem Ökosystemgebrauch — AI-Marktplatztransaktionen, Datanet-Beiträgen, OctoClaw-Einsätzen, Inferenzzahlungen — vor September signifikant wächst, wird die Freigabe handhabbar. Die Nachfrage absorbiert das Angebot.
Wenn die Adoption bis dahin nicht beschleunigt hat, beginnt die 36-monatige lineare Vesting von Team und Investoren, auf einen Markt zu treffen, der bereits unter Druck steht. Das ist kein katastrophales Szenario. Es ist ein langsames strukturelles. Die Art, die nicht wie eine Krise aussieht, bis sie bereits eine ist.
Der AI-Marktplatz ist ein wichtiger mittelfristiger Meilenstein — eine dezentrale Plattform, auf der Entwickler Modelle und AI-Agenten bereitstellen, mit Nutzungsgebühren, die automatisch über Smart Contracts an Beitragsleistende weitergeleitet werden. (Milk Road) Ob das vor September bedeutend ausgeliefert wird, ist die Frage, die ich derzeit sorgfältiger verfolge als den Preis.
Was ich wirklich glaube — mit Unsicherheit verbunden.
@OpenLedger versucht, etwas Spezifisches und Schwieriges.
Nicht "AI auf Blockchain." Diese Kategorie ist voll. Nicht "dezentralisiertes Rechnen." Diese Kategorie ist auch voll.
Etwas spezifischer: die unsichtbare Arbeit unter AI sichtbar zu machen — die Daten, die Kuratierung, das Modelltraining, den Beitrag zur Inferenz — in sichtbare, zuordenbare, vergütbare wirtschaftliche Aktivität.
Alle Aktionen — Datensatz-Uploads, Modelltraining, Belohnungsgutschriften, Governance-Teilnahme — werden On-Chain ausgeführt. Benutzer können Datanets erstellen, zu öffentlichen beitragen, Modelle bauen und sie mit transparenten tokenisierten Mechaniken veröffentlichen. (Fear & Greed Meter)
Diese Spezifität ist es, die es wert macht, darauf zu achten. Vage Infrastrukturversprechen sind überall. Ein Projekt, das das genaue Problem benannt hat, den genauen Mechanismus entwickelt hat und die genauen Werkzeuge ausgeliefert hat — selbst wenn diese Werkzeuge noch reifen — ist weiter fortgeschritten als die meisten.
Ob der Markt bereit für eine AI-Zuordnungsökonomie ist — ob die Nachfrageseite ankommt, bevor der Angebotsdruck einsetzt — ich weiß es wirklich nicht.
Aber ich komme immer wieder zur ursprünglichen Frage zurück.
Wenn AI Wert aus menschlichen Daten schafft — wohin fließt dieser Wert?
Im Moment: zentralisierte Unternehmen.
@OpenLedger baut die Infrastruktur, um diese Antwort zu ändern.
Ob es erfolgreich ist, ob das Timing stimmt, ob die Genauigkeit der Zuordnung im großen Maßstab hält — all das ist wirklich unsicher.
Aber die Frage, die es zu beantworten versucht, ist real.
Und echte Fragen — letztendlich — finden echte Infrastruktur. 🎯
Keine Finanzberatung. Persönliche Analyse. DYOR.
Ich möchte wissen, was du tatsächlich denkst.
Nicht die optimistische Sicht. Nicht das FUD. Die ehrliche.
Glaubst du, dass der Wertfluss der AI-Wirtschaft tatsächlich durch On-Chain-Zuordnung umgeleitet werden kann — oder korruptiert die Anreizstruktur letztendlich die Datenqualität, die die Zuordnung überhaupt sinnvoll macht?
Diese spezifische Spannung ist das, was ich nicht lösen kann. Ich würde lieber dein Denken hören, als so zu tun, als hätte ich es herausgefunden. 👇
🪙 Jeder Kommentar verdient Binance Square-Münzen — aber dieses Gespräch ist es wert, unabhängig davon geführt zu werden.
🪙 LIKE, wenn das Fragen aufgeworfen hat, die du noch nicht vollständig artikuliert hast.
🪙 TEILE es mit einer Person, die ernsthaft darüber nachdenkt, wohin AI-Wertflüsse gehen — sie werden etwas Reales beizutragen haben.
🪙 FOLLOW für Analysen, die Unsicherheiten anerkennen, anstatt Selbstvertrauen zu zeigen. Kostenlos. Täglich.
$OPEN $ETH $BNB
#OpenLedger #OPEN #AIBlockchain #PayableAI #ProofOfAttribution #DecentralizedAI #BinanceSquare #Web3AI #OctoClaw #Crypto2026 🪙