Ich komme immer wieder auf die gleiche Frage zurück, und ehrlich gesagt kann ich mich noch nicht auf eine klare Antwort festlegen...
Alle reden gerade über AI-Krypto. Der Lärm ist verrückt. Du siehst GPU-Netzwerke, Modell-Marktplätze, Agenten-Plattformen – Dutzende Projekte, die darum wetteifern, wie Daten, Modelle und autonome Agenten interagieren. Aber wenn ich versuche, das zu wählen, was echte Infrastruktur aufbaut und nicht nur Hype ist, werde ich verwirrt.
Ist es Bittensor mit seinem riesigen Subnetzwerk? Fetch.ai, das all diese "autonomen Agenten" vorantreibt? Render mit seinem GPU-Vermietungsnetzwerk? Oder ist es etwas Ruhigeres wie OpenLedger?
Hier wird es interessant…
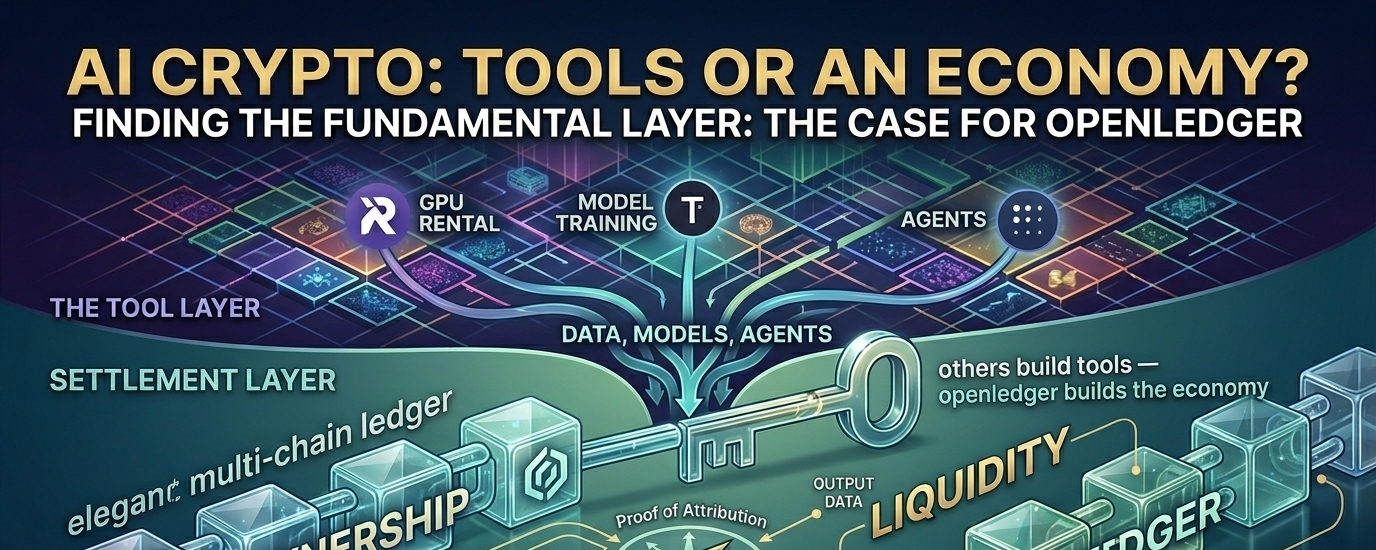
Ich halte hier an und denke nach… denn fast jedes KI-Projekt im Krypto-Bereich löst nur einen Teil des KI-Stacks. Es ist, als würden alle Werkzeuge bauen, aber niemand baut die Wirtschaft um diese Werkzeuge.
Render gibt dir GPU-Power. Bittensor koordiniert das Modelltraining über Knoten. Fetch.ai baut Agenten, die Aufgaben erledigen können. SingularityNET ist ein Marktplatz für KI-Dienste. Alles nützlich, aber irgendetwas fehlt darunter…
Wer besitzt die Daten?
Wer wird bezahlt, wenn ein Modell deine Daten verwendet?
Wie beweist man, woher das Wissen eines Modells tatsächlich stammt?
Wie wird all das liquide, handelbar, monetarisierbar?
Die meisten Menschen ignorieren das. Sie konzentrieren sich auf Rechnen, oder Modelle, oder Agenten… aber nicht auf die wirtschaftliche Schicht, die es ermöglicht, dass Daten, Modelle und Agenten tatsächlich als Wert fließen. Ohne diese Schicht hast du nur teure Werkzeuge herumliegen, keine Wirtschaft.
Ich habe darüber nachgedacht, wie KI heute in der realen Welt funktioniert, und es ist chaotisch. Große Unternehmen sammeln Daten von überall. Sie trainieren Modelle. Sie verkaufen Zugänge. Die ursprünglichen Datenanbieter? Sie sehen nichts. Kein sauberer Weg, um Daten ihrer Quelle zuzuordnen, keine Möglichkeit, zu verfolgen, wie diese Daten ein Modell beeinflusst haben, keine Möglichkeit, die richtigen Leute automatisch zu bezahlen, keine Möglichkeit, den Institutionen zu beweisen, dass die Daten legitim und konform sind.
Menschen können dies nicht manuell in großem Maßstab tun. Anwälte, Verträge, Audits… das ist zu langsam, zu teuer, zu undurchsichtig.
Die eigentliche Frage ist also nicht "Wer hat die besten Modelle?"
Es ist: "Wer baut die Infrastruktur, in der Daten, Modelle und Agenten liquide Vermögenswerte werden können?"
Hier ist der Punkt, an dem OpenLedger meine Aufmerksamkeit immer wieder fesselt…
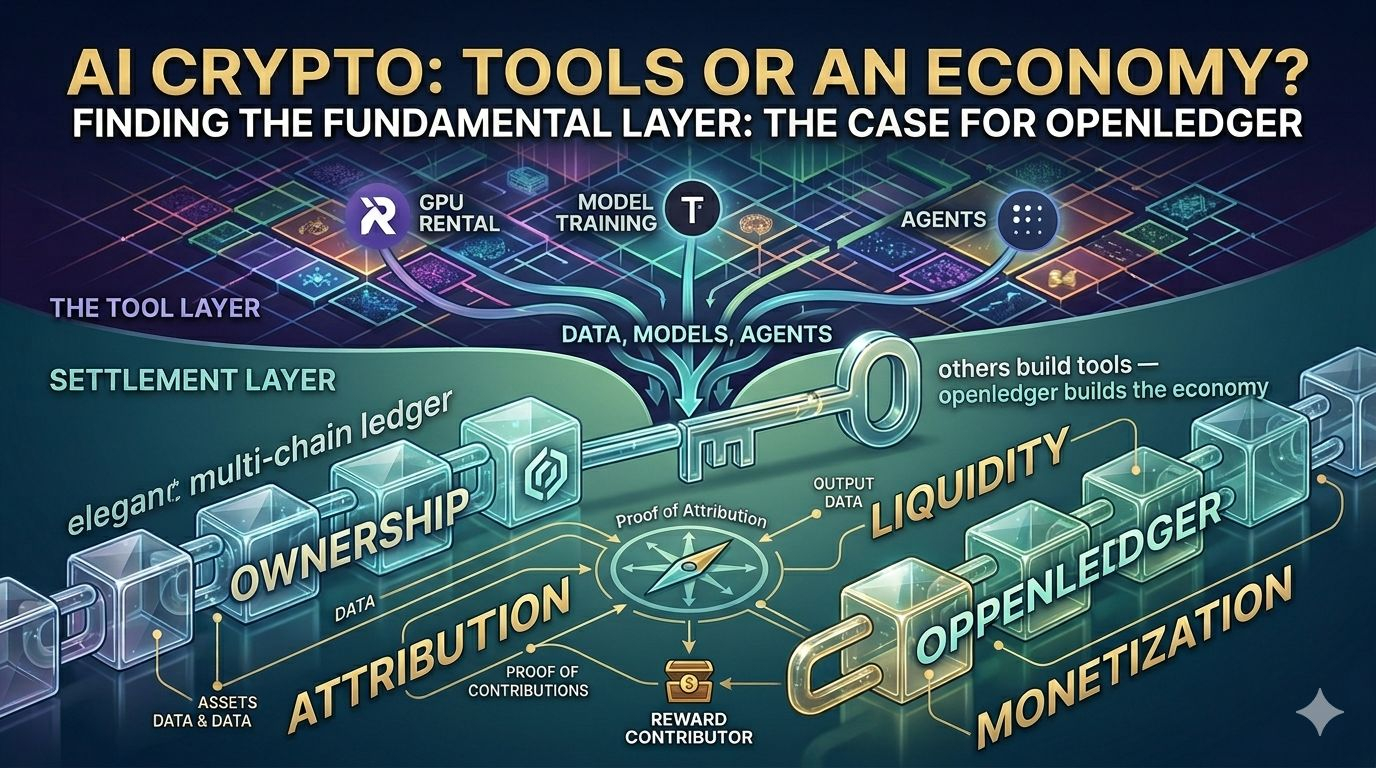
OpenLedger versucht nicht, ein weiteres GPU-Netzwerk zu sein. Es ist nicht nur ein weiterer Modellmarktplatz. Es geht nicht nur um Agenten. Es positioniert sich als die Abwicklungsschicht für den Wert von KI.
Die Kernidee ist einfach, aber auf eine gute Weise gefährlich: Jeder Datensatz, jedes Modell, jeder Adapter und jeder Agent wird zu einem überprüfbaren, zuordenbaren, entschädigbaren Vermögenswert on-chain. Durch etwas, das Proof of Attribution genannt wird, wird nachverfolgt, wie Daten Outputs beeinflussen und Beiträge automatisch belohnt. Die EVM-kompatible Kette ermöglicht es, dass trainierte Modelle und Agenten einfach gehandelt, kombiniert und aufgerufen werden können.
Mit anderen Worten: OpenLedger möchte KI in eine liquide Wirtschaft der Intelligenz verwandeln, in der der Wert zu den Beitragsleistenden zurückfließt, nicht nur zu denjenigen, die die Modelle besitzen. Bis 2026 ist es bereits auf Binance gelistet mit einem zirkulierenden Angebot von etwa 215,5 Millionen OPEN von insgesamt 1 Milliarde, gehandelt bei etwa $0,18.
Wenn ich das mit anderen großen Akteuren vergleiche, beginnen die Unterschiede schärfer zu werden…
Bittensor dreht sich alles um dezentrales Modelltraining und Intelligenz-Wettbewerb über Subnetze. Es geht mehr um kollektives Training und allgemeines Rechnen/Intelligenz. OpenLedger hingegen ist mehr wie die Abwicklungsschicht für die Realisierung des Wertes von KI. Bittensor fragt "Wie trainieren wir Modelle kollektiv?" während OpenLedger fragt "Wie werden Daten, Modelle und Agenten handelbare, monetarisierbare, zuordenbare Vermögenswerte?". OpenLedger versucht nicht, Bittensor im Bereich der rohen Intelligenz zu übertreffen. Es schneidet sich eine andere Nische heraus: Datenmonetarisierung und Unternehmenskonformität. Ich bin noch nicht voll überzeugt, dass dies den Netzwerkeffekt von Bittensor übertreffen wird… aber der Ansatz ist unterschiedlich genug, dass beide koexistieren könnten.
Fetch.ai ist stark in autonomen KI-Agenten und Multi-Agenten-Systemen für Aufgaben wie Lieferkettenoptimierung oder Energiehandel. Es ist mehr wie Middleware, wo Agenten in Märkten interagieren. OpenLedger geht weiter: Es möchte den gesamten Lebenszyklus on-chain einbetten, nicht nur die Interaktion von Agenten. Fetch.ai ist die "Agentenschicht", während OpenLedger sich selbst als die Liquiditätsschicht bezeichnet. Wenn Fetch.ai um Agenten geht, die in Märkten interagieren, geht es bei OpenLedger um Modelle, Daten und Agenten als eine liquide Wirtschaft, in der alles zuordenbar und monetarisierbar ist. Das ist eine gewagte Behauptung. Ich bin neugierig, aber nicht überzeugt.
Render ist ein GPU-Vermietungsnetzwerk. Es löst die Verteilung von rohem Rechnen. OpenLedger ist nicht ein weiteres GPU-Netzwerk. Es adressiert die Verantwortlichkeitsschicht. Render sagt "Hier ist GPU-Power." OpenLedger sagt "Hier ist die Schicht, in der Beiträge anerkannt werden, Outputs überprüfbar sind und Wert zugeordnet wird." Sie sind keine direkten Konkurrenten. Tatsächlich arbeitet OpenLedger mit io.net für GPU-Rechnen zusammen, was Render's Bereich berührt, aber Liquidität und Zuordnung oben drauf addiert. Also wird die Frage: Welche Schicht ist langfristig grundlegender? Rechnen oder die wirtschaftliche/zuordenbare Schicht?
Ich muss hier ehrlich sein… es gibt viele bewegliche Teile für OpenLedger. Du benötigst Proof of Attribution, der tatsächlich in großem Maßstab funktioniert, einen funktionierenden Modellmarkt, in dem Menschen Modelle und Adapter handeln, echte Monetarisierung für Datenanbieter und die Unternehmensakzeptanz für erklärbare KI und konforme Datenquellen. Das ist viel.
Aber hier ist der entscheidende Punkt… bis 2026 werden mehr Unternehmen erklärbare KI und konforme Datenquellen benötigen. Sie können nicht einfach wahllos Daten aus dem Internet abrufen und Modelle trainieren. Sie brauchen Transparenz, Nachvollziehbarkeit und klare Eigentumsverhältnisse. Die transparente + liquide Kombination von OpenLedger könnte reale Anwendungen anziehen, nicht nur spekulative Fonds. Indem es auf dem OP Stack als Ethereum Layer 2 aufbaut, ist es auch EVM-kompatibel, was bedeutet, dass Entwickler tatsächlich darauf aufbauen können, ohne eine völlig neue Sprache lernen zu müssen.
Dennoch ist die Ausführung alles. Wenn das Team nicht in der Lage ist, einen reibungslosen Modellmarkt, echte Zuordnung und tatsächliche Liquidität zu liefern, wird dies ein weiterer Traum aus einem Whitepaper. Ich beobachte genau, aber ich bin noch nicht voll überzeugt.
Aber wenn OpenLedger das tatsächlich umsetzt… wäre es die finanzielle Infrastruktur der KI-Wirtschaft, nicht nur ein weiterer Marktplatz. Denk darüber nach: Daten werden zu einem handelbaren Vermögenswert mit klarem Eigentum. Entwickler können Modelle direkt on-chain monetarisieren. Institutionen erhalten eine konforme, skalierbare KI-Bereitstellungsschicht. Cross-Chain-Liquiditätsbrücken verbinden fragmentierte Ökosysteme. Das ist mehr als ein Token. Es ist ein Tor zur Multi-Chain-KI-Wirtschaft. Wenn das passiert, $OPEN could könnte ein Top-Projekt im KI + Web3-Sektor werden, ähnlich wie Ocean Protocol und Bittensor ihre Nischen definiert haben. Die zugrunde liegende Erzählung ist stark: Andere bauen die Werkzeuge – OpenLedger baut die Wirtschaft. Und es wird von Polychain Capital unterstützt, was mir zumindest sagt, dass ernsthafte Investoren aufmerksam sind.
Ich habe keine saubere Antwort. Bittensor hat Netzwerkeffekte und eine starke Trainingsebene. Fetch.ai drängt stark auf Agenten. Render besitzt die Nische für GPU-Rechnen. OpenLedger setzt auf Zuordnung + Liquidität als die fehlende Schicht.
Die Frage dreht sich immer wieder… welche Schicht ist langfristig grundlegender? Rohes Rechnen? Kollektives Training? Autonome Agenten? Oder die wirtschaftliche Schicht, die Daten, Modelle und Agenten liquide und zuordenbar macht?
Ich neige zur Idee, dass, wenn die KI-Wirtschaft wirklich skaliert, die wirtschaftliche/zuordnungsbasierte Schicht genauso wichtig wird wie das Rechnen selbst. Vielleicht sogar wichtiger. Denn Werkzeuge werden commodifiziert. Aber die Wirtschaft um sie herum? Das ist der Ort, wo sich der Wert festsetzt.
Aber ich weiß noch nicht, ob OpenLedger derjenige sein wird, der diese Schicht besitzen wird… oder ob jemand anderes sie übertreffen wird. Alles, was ich weiß, ist: die Projekte, die sich nur auf Werkzeuge konzentrieren, nicht auf die Wirtschaft um sie herum, könnten als commodifizierte Infrastruktur enden. Diejenigen, die Eigentum, Zuordnung und Liquidität lösen… das könnten die wahren Gewinner sein.
Ich denke immer noch darüber nach. Ich beobachte weiterhin. Und ehrlich gesagt, da fühle ich mich am wohlsten – neugierig, skeptisch, aber offen.
#bitcoin #crypto #Binance #CryptoExchangeNews $BTC