Brüder, dieses Mal habe ich nicht die Aufzeichnungen der Contributor durchgesehen, sondern mich ganz gezielt auf die OpenLoRA-Inferenzlogs der @OpenLedger gestürzt. Das ist genau diese Nummer, die behauptet, mit einer einzigen GPU könnten man tausende Modelle laufen lassen. Ich habe eine Woche lang die Anforderungsdaten gezogen und dabei ein ziemlich interessantes Phänomen entdeckt. Auf derselben GPU hängen zwar über dreihundert LoRA-Modelle, aber mehr als siebzig Prozent der Inferenzanfragen konzentrieren sich nur auf fünf dieser Modelle. Die übrigen dreihundert+ Modelle werden praktisch nicht angerührt. Warum? Weil OpenLoRA zwar technisch gesehen sehr viele Modelle gleichzeitig „hängen“ kann, aber die Regeln zur Traffic-Verteilung immer noch nach den Node-Gewichten funktionieren. Der Traffic wird zuerst an Modelle unter den Nodes gefüttert, die $OPEN am meisten staken. Wie gut dein Modell auch ist: Wenn es an einer kleinen Node hängt, kommt deine Nummer bei den Benutzeranfragen schlicht nicht zum Zug.
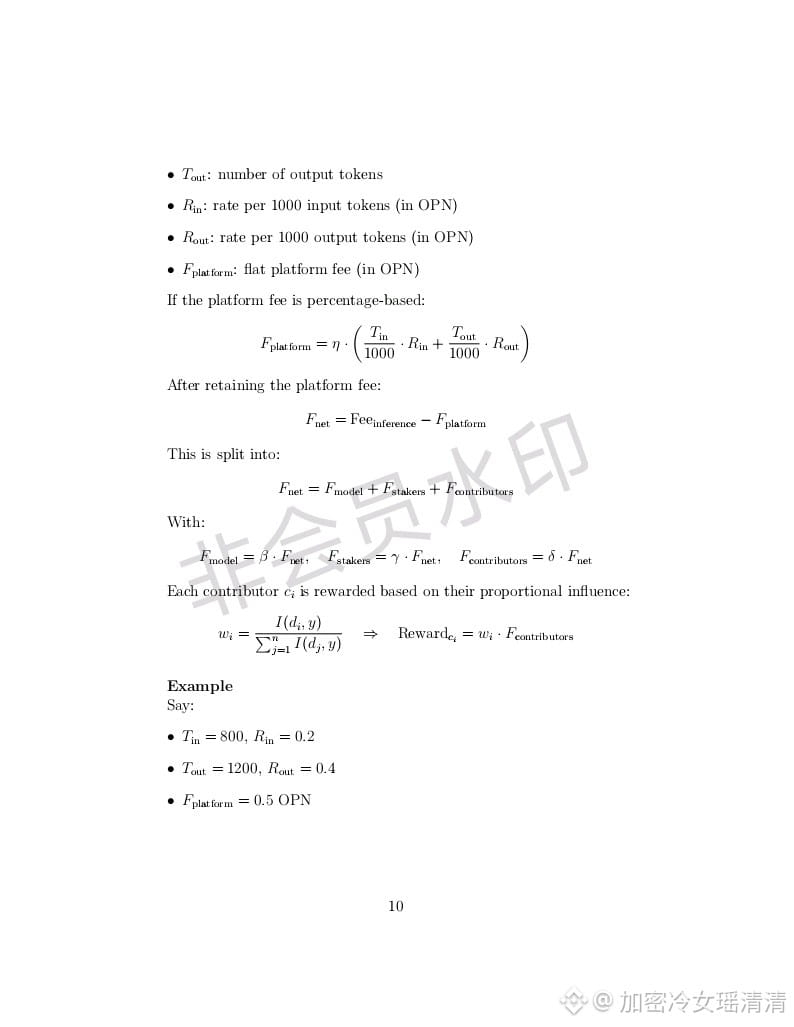
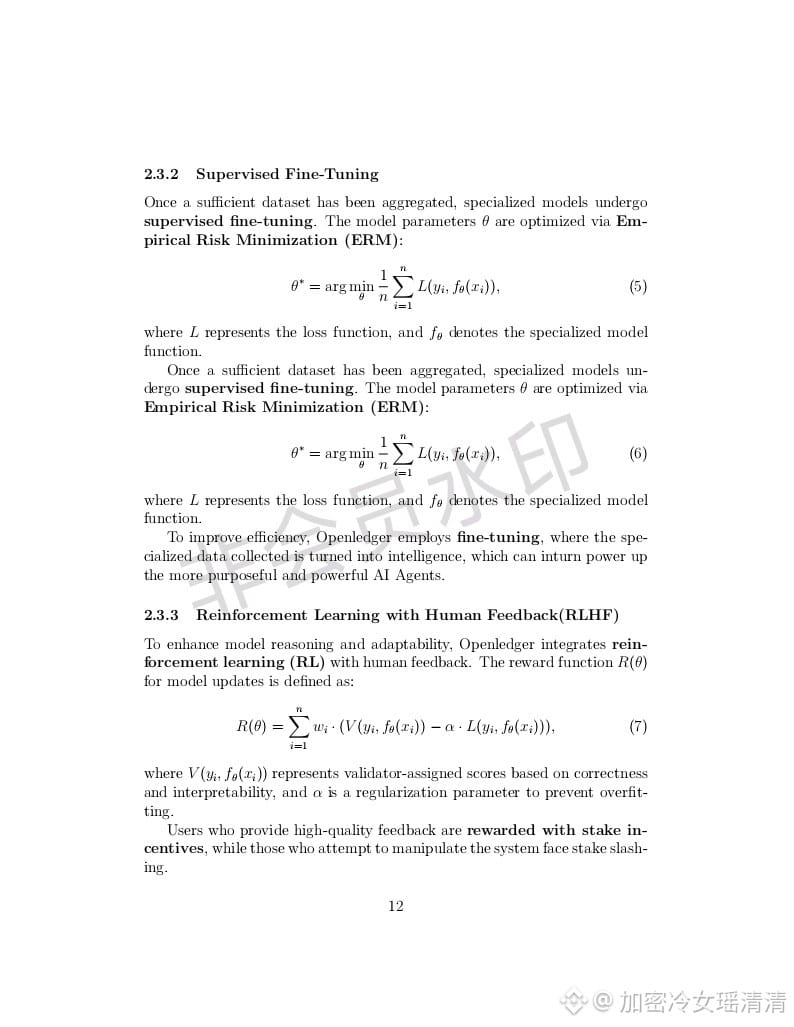
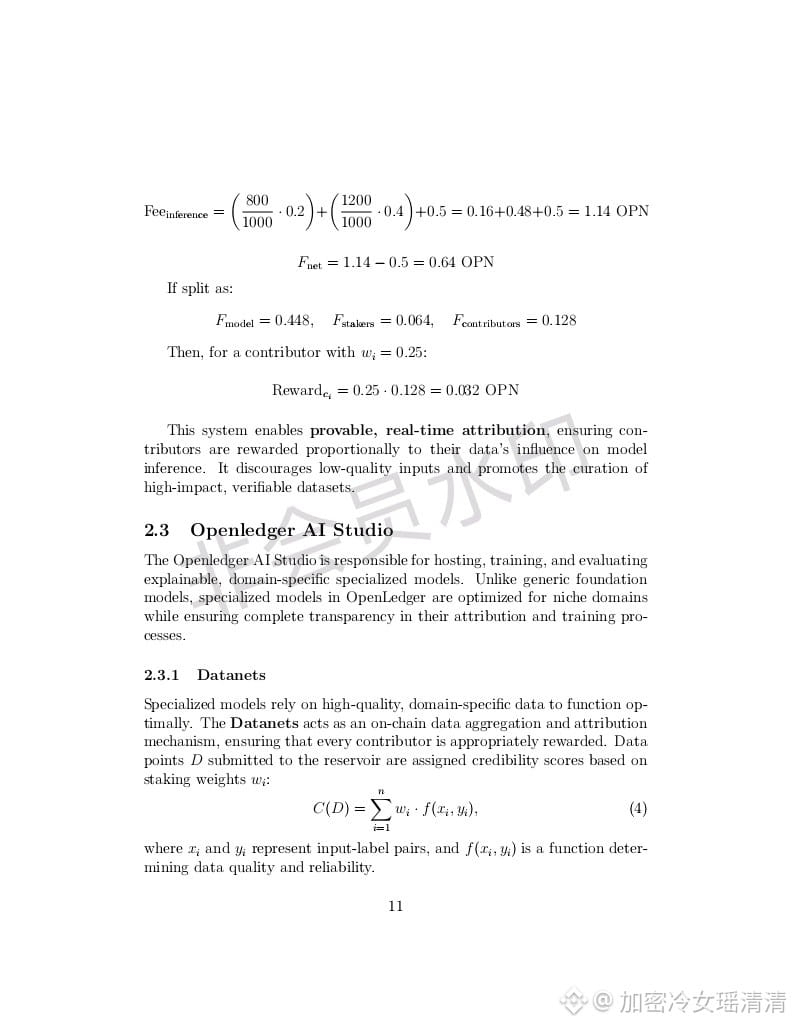
#OpenLedger hat technisch gesehen tatsächlich ein paar Ass im Ärmel: Mit einer einzigen Karte kann man ein paar hundert Modelle laufen lassen, ohne dass es gleich kracht, und auch die Latenz lässt sich ganz ordentlich kontrollieren. Aber wirtschaftlich verschenkt dieses Modell den ganzen technischen Vorteil an die Großfische. Die Modelle, die an kleinen Nodes hängen, sind wie kleine Läden in einer Seitengasse – man sieht die Schilder nicht. Und das Bitterste ist: Wenn Nutzer ein Modell aufrufen und dafür Inferenzgebühren zahlen, ist der Anteil, der an die Modellseite geht, fest. Egal, wie gut oder schlecht dein Modell ist: Wenn es aufgerufen wird, bekommst du denselben prozentualen Anteil. Das führt dazu, dass niemand Lust hat, Energie in die Optimierung von Nischenmodellen zu stecken, weil die Aufrufbasis zu klein ist – selbst mit hohem Anteil bekommst du am Ende nicht viel Geld.
Und die Top-Modelle: Selbst wenn die Qualität nur mittel ist, verdienen sie sich eine goldene Nase, weil der Traffic so groß ist. Ich habe speziell Daten von einem eher unbekannten Modell nachverfolgt. Dieses Modell war in einem bestimmten Nischenbereich sogar um fünfzehn Prozent genauer als das führende Modell. Aber innerhalb einer Woche wurde es nur weniger als zehn Mal aufgerufen. Der Kreator hat Zeit und Rechenleistung in ein Fine-Tuning gesteckt, am Ende kam für ihn $OPEN heraus – nicht genug, um die Gas-Kosten zu decken, die er dafür verbrannt hat.
Und was hat der Kreator des Top-Modells getan? Nichts. Es hängt einfach unter einer Node der Großfische – und wöchentlich plätschert das Geld nur so rein.
Im Kern belohnt dieses Regelwerk nicht technische Innovation, sondern belohnt Kapital, das sich zusammenschließt. Das Team weiß vermutlich, dass es ein Problem gibt. Aber sobald man die Traffic-Verteilung von Node-Gewichten weg und nach Modellqualität umstellt, würden die stakenden Großfische sofort nicht mehr mitmachen. Denn dann würden sie die Kohle nicht mehr in „Laden“ stecken, um sich gegenseitig hochzuschieben.
Wenn man wirklich Geld in die Hand nehmen will, um Modellentwicklung zu betreiben, Bruder, dann würde ich lieber in Bananenbrot und Ethereum hier rumhocken und auf den Bullenmarkt warten.
#OpenLedger hat technisch gesehen tatsächlich ein paar Ass im Ärmel: Mit einer einzigen Karte kann man ein paar hundert Modelle laufen lassen, ohne dass es gleich kracht, und auch die Latenz lässt sich ganz ordentlich kontrollieren. Aber wirtschaftlich verschenkt dieses Modell den ganzen technischen Vorteil an die Großfische. Die Modelle, die an kleinen Nodes hängen, sind wie kleine Läden in einer Seitengasse – man sieht die Schilder nicht. Und das Bitterste ist: Wenn Nutzer ein Modell aufrufen und dafür Inferenzgebühren zahlen, ist der Anteil, der an die Modellseite geht, fest. Egal, wie gut oder schlecht dein Modell ist: Wenn es aufgerufen wird, bekommst du denselben prozentualen Anteil. Das führt dazu, dass niemand Lust hat, Energie in die Optimierung von Nischenmodellen zu stecken, weil die Aufrufbasis zu klein ist – selbst mit hohem Anteil bekommst du am Ende nicht viel Geld.
Und die Top-Modelle: Selbst wenn die Qualität nur mittel ist, verdienen sie sich eine goldene Nase, weil der Traffic so groß ist. Ich habe speziell Daten von einem eher unbekannten Modell nachverfolgt. Dieses Modell war in einem bestimmten Nischenbereich sogar um fünfzehn Prozent genauer als das führende Modell. Aber innerhalb einer Woche wurde es nur weniger als zehn Mal aufgerufen. Der Kreator hat Zeit und Rechenleistung in ein Fine-Tuning gesteckt, am Ende kam für ihn $OPEN heraus – nicht genug, um die Gas-Kosten zu decken, die er dafür verbrannt hat.
Und was hat der Kreator des Top-Modells getan? Nichts. Es hängt einfach unter einer Node der Großfische – und wöchentlich plätschert das Geld nur so rein.
Im Kern belohnt dieses Regelwerk nicht technische Innovation, sondern belohnt Kapital, das sich zusammenschließt. Das Team weiß vermutlich, dass es ein Problem gibt. Aber sobald man die Traffic-Verteilung von Node-Gewichten weg und nach Modellqualität umstellt, würden die stakenden Großfische sofort nicht mehr mitmachen. Denn dann würden sie die Kohle nicht mehr in „Laden“ stecken, um sich gegenseitig hochzuschieben.
Wenn man wirklich Geld in die Hand nehmen will, um Modellentwicklung zu betreiben, Bruder, dann würde ich lieber in Bananenbrot und Ethereum hier rumhocken und auf den Bullenmarkt warten.