wie

Veröffentlichen
--
Âkšhu-艾
·
--
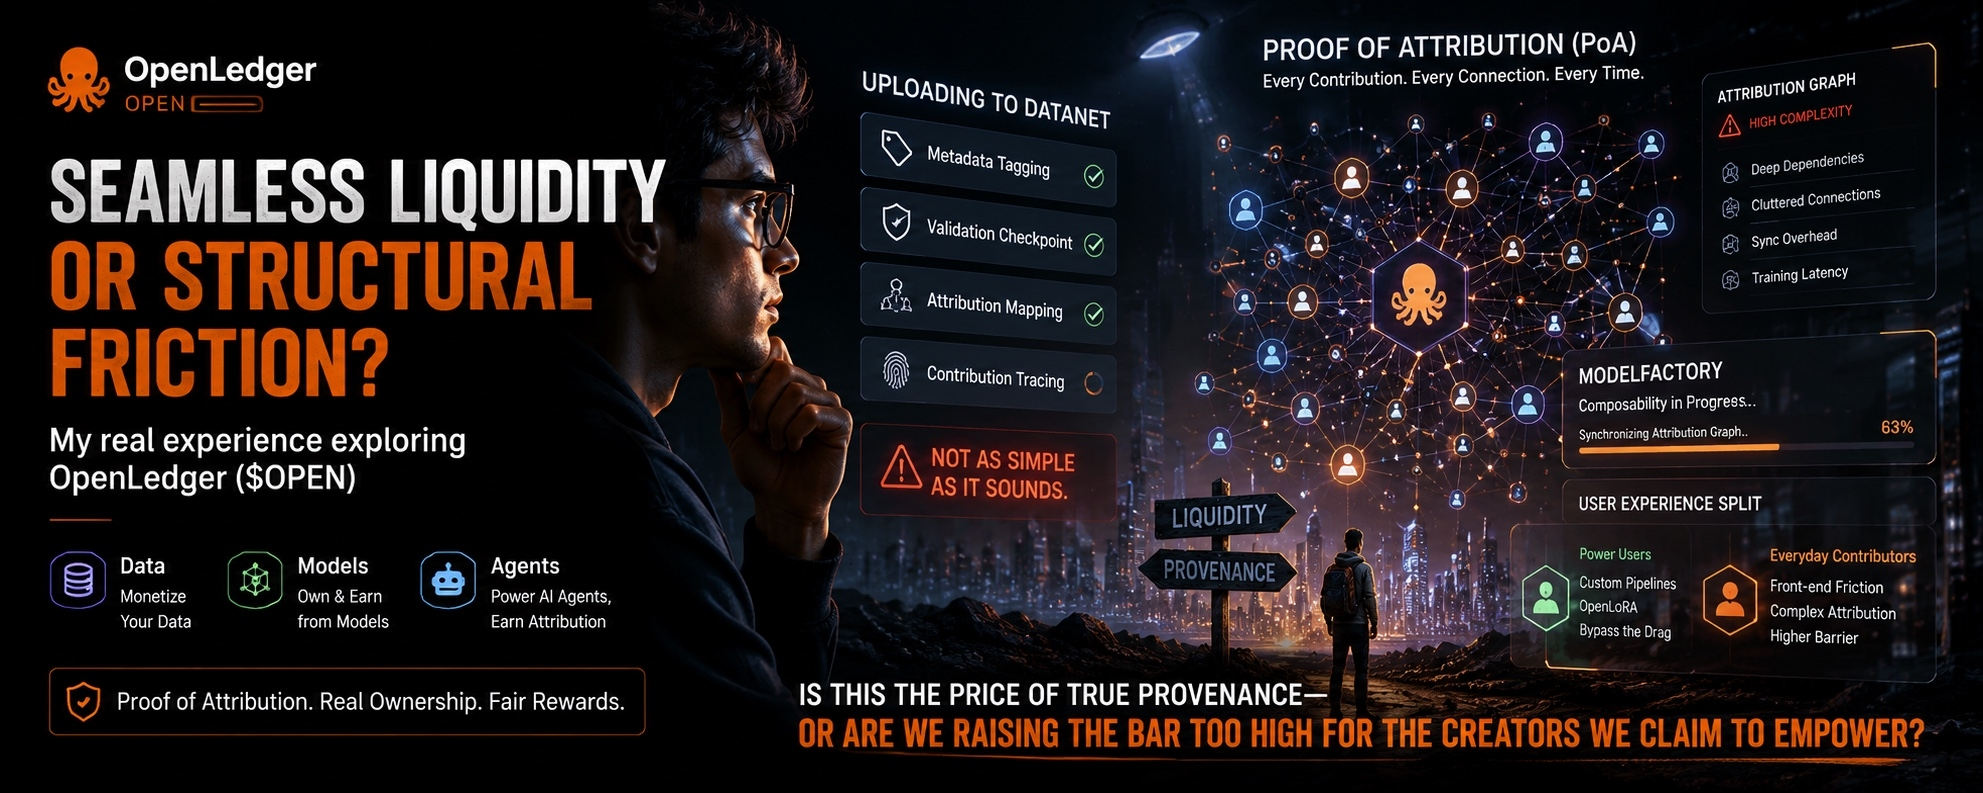
OpenLedger fühlt sich weniger nach KI-Liquidität und mehr nach KI-Verantwortung an.
Ich bin in OpenLedger $OPEN gegangen und habe etwas Reibungsloses und Müheloses erwartet. Die Art und Weise, wie die Leute über die Liquidität von KI-Assets sprechen, lässt es so aussehen, als könnten Daten und Modelle frei fließen, sobald man etwas Wertvolles beiträgt.
Das war nicht das Gefühl, das ich beim tatsächlichen Gebrauch hatte.
Ich habe versucht, ein kleines lokales Dataset in ein Datanet hochzuladen, und der Prozess wurde sofort schwerer als erwartet. Bevor die Daten überhaupt im Netzwerk existieren konnten, musste ich durch Metadaten-Tagging, Validierungsschritte, Attributionsschichten und Beitragstracking navigieren. Es fühlte sich nicht lässig oder offen an. Es fühlte sich an, als würde ich in ein System eintreten, das jeden Fingerabdruck, der an den Daten hängt, für immer speichern wollte.
Das war nicht das Gefühl, das ich beim tatsächlichen Gebrauch hatte.
Ich habe versucht, ein kleines lokales Dataset in ein Datanet hochzuladen, und der Prozess wurde sofort schwerer als erwartet. Bevor die Daten überhaupt im Netzwerk existieren konnten, musste ich durch Metadaten-Tagging, Validierungsschritte, Attributionsschichten und Beitragstracking navigieren. Es fühlte sich nicht lässig oder offen an. Es fühlte sich an, als würde ich in ein System eintreten, das jeden Fingerabdruck, der an den Daten hängt, für immer speichern wollte.
Haftungsausschluss: Enthält Meinungen von Drittanbietern. Keine Beratung. Binance AI wird ohne Gewähr bereitgestellt. Siehe AGB.