Bruder, ich bastle jetzt schon fast ein Jahr an KI-Modellen herum. Am meisten Kopfzerbrechen macht mir nicht das Programmieren, sondern es ist verdammt schwer, saubere Daten zu bekommen.
Letzten Monat wollte ich ein Modell zum Fein-Tuning für die Prüfung von Rechtsverträgen machen – speziell, um die gemeinen Klauseln in Mietverträgen zu erkennen. Ich hab online drei Tage lang Material zusammengetragen und mir eine ganze Menge dubioser Vertragsbeispiele runtergeladen. Einige Formate waren komplett durcheinander, manche Klausel-Bezeichnungen passten überhaupt nicht zusammen – am Ende konnte man das Zeug schlicht nicht verwenden.
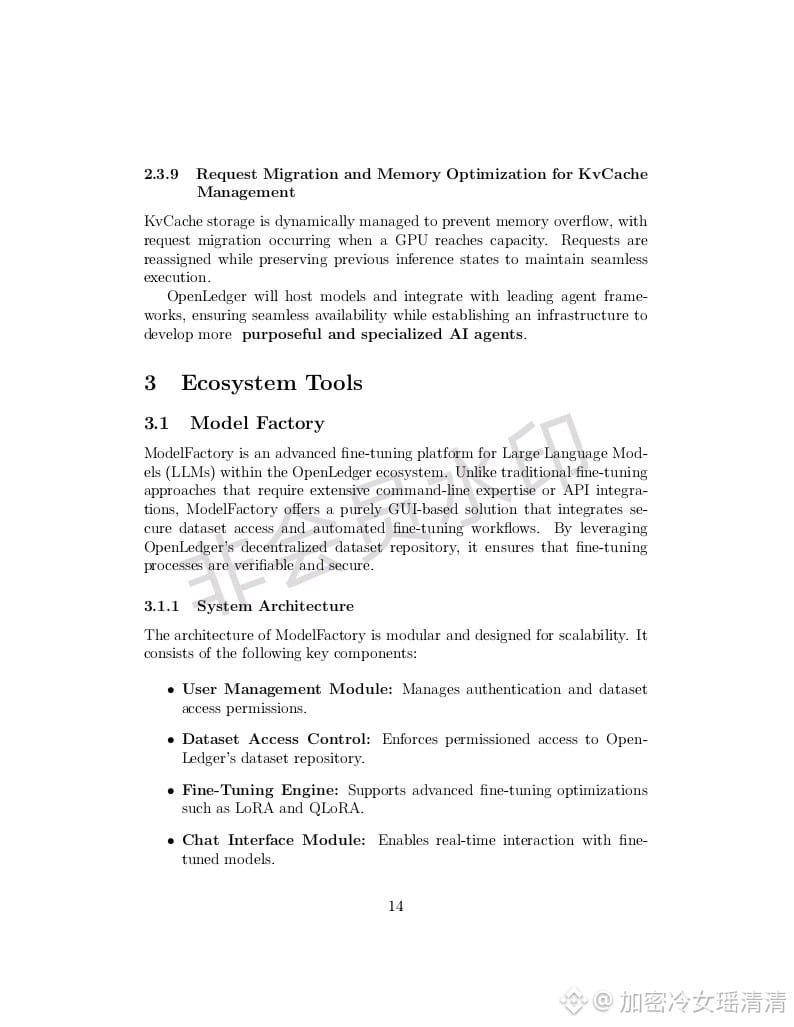
Dann bin ich später in der ModelFactory von <0>@OpenLedger </0> gegangen und habe einfach direkt einen fertigen Datensatz für Vertragsdaten ausgewählt. Das ist ein professionelles Team, die die Daten vorher bereinigt haben. Jede Klausel hat einen Typ-Tag – sauber und eindeutig. Ich hab ein paar Klicks gemacht, den Datensatz in das Training gezogen, fertig.
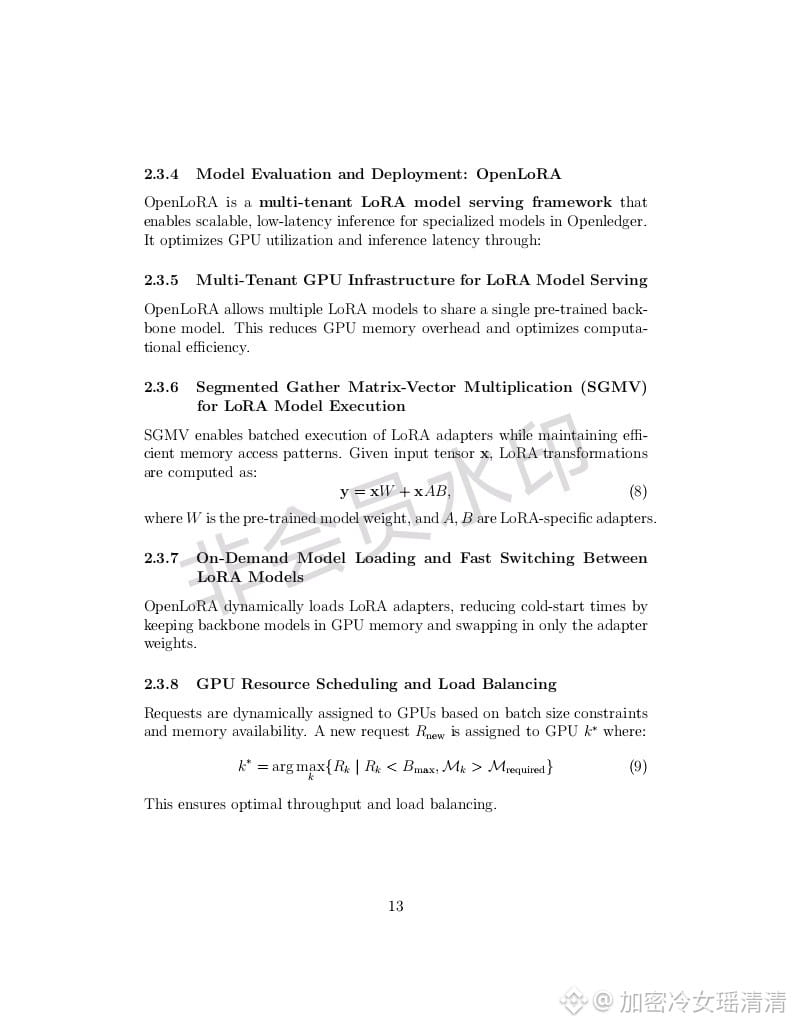
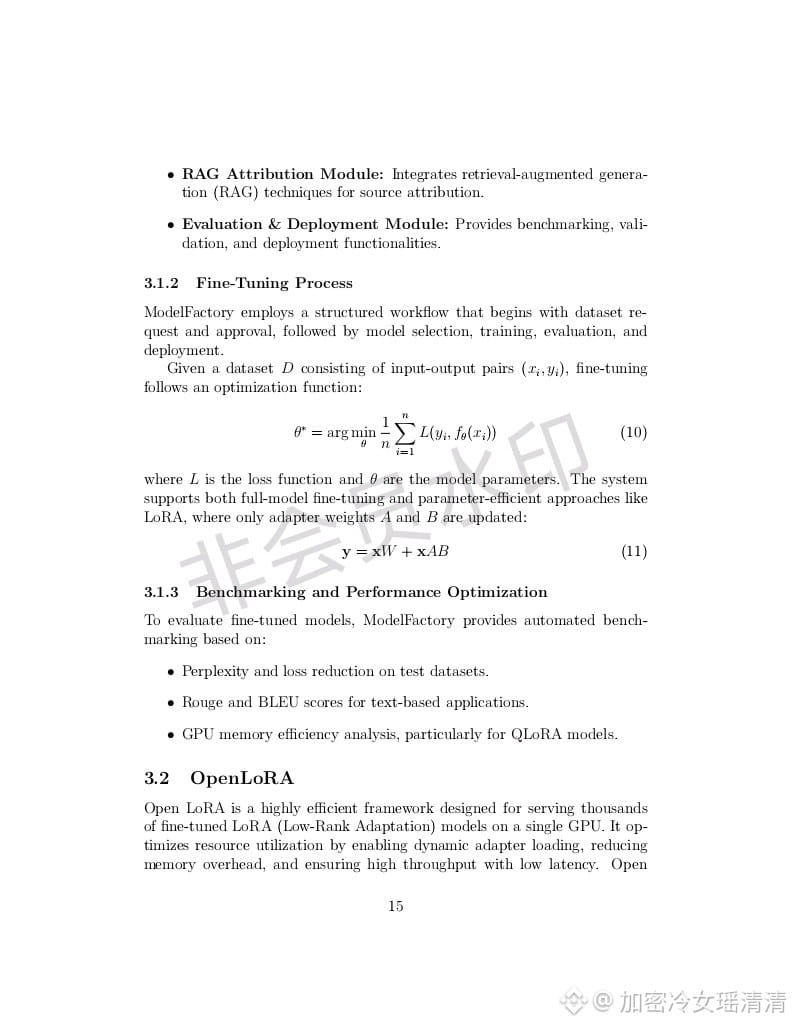
Im Whitepaper steht, dass diese ModelFactory Fein-Tuning mit LoRA und QLoRA unterstützt. Selbst wenn man nur so halbwegs Ahnung vom Code hat, kommt man damit klar. Kein Kommandozeilen-Gefummel: Auf der Webseite Modell auswählen, Datensatz anhängen, auf Start klicken – und dann geh schlafen. Am nächsten Tag war das Training durch. Ich hab ein paar Verträge getestet – die Erkennungsgenauigkeit war viel besser als das, was ich vorher alles manuell zusammengeschraubt habe.
Das Wichtigste: Dieses Modell wird nicht einfach stumm von mir „für mich“ genutzt. Ich kann es auf der Plattform bereitstellen. Wenn jemand es aufruft, muss er jedes Mal $OPEN zahlen, und das System teilt automatisch. Ich bekomme den Anteil, der Modellbeitragende Teil geht an mich, die Bereitsteller der Trainingsdaten bekommen ihren Anteil, und die Staker bekommen den Wartungsanteil.
Das ist komplett anders als dieses Prinzip von $BTC , wo Leute selbst Minen, selbst verkaufen. Auch nicht vergleichbar mit $ETH , wo man einfach nur einen Vertrag deployt und dann keine laufenden Einnahmen hat. Das hier ist eine automatisch laufende „Revenue-Split“-Maschine.
Ich hab mir ausgerechnet, was es bringt: Wenn am Tag ein paar Dutzend Leute mein Vertragsmodell verwenden, dann reicht das pro Monat locker, um meine Miete zu zahlen. Und je öfter es aufgerufen wird, desto besser kann das Modell sich anhand von Rückmeldungen weiter optimieren – es wird mit jeder Nutzung genauer.
Ich bereite gerade das zweite Modell vor. Diesmal will ich Richtung Lebenslauf-Screening gehen – die Daten hab ich schon, am Wochenende geht’s los. #OpenLedger
Letzten Monat wollte ich ein Modell zum Fein-Tuning für die Prüfung von Rechtsverträgen machen – speziell, um die gemeinen Klauseln in Mietverträgen zu erkennen. Ich hab online drei Tage lang Material zusammengetragen und mir eine ganze Menge dubioser Vertragsbeispiele runtergeladen. Einige Formate waren komplett durcheinander, manche Klausel-Bezeichnungen passten überhaupt nicht zusammen – am Ende konnte man das Zeug schlicht nicht verwenden.
Dann bin ich später in der ModelFactory von <0>@OpenLedger </0> gegangen und habe einfach direkt einen fertigen Datensatz für Vertragsdaten ausgewählt. Das ist ein professionelles Team, die die Daten vorher bereinigt haben. Jede Klausel hat einen Typ-Tag – sauber und eindeutig. Ich hab ein paar Klicks gemacht, den Datensatz in das Training gezogen, fertig.
Im Whitepaper steht, dass diese ModelFactory Fein-Tuning mit LoRA und QLoRA unterstützt. Selbst wenn man nur so halbwegs Ahnung vom Code hat, kommt man damit klar. Kein Kommandozeilen-Gefummel: Auf der Webseite Modell auswählen, Datensatz anhängen, auf Start klicken – und dann geh schlafen. Am nächsten Tag war das Training durch. Ich hab ein paar Verträge getestet – die Erkennungsgenauigkeit war viel besser als das, was ich vorher alles manuell zusammengeschraubt habe.
Das Wichtigste: Dieses Modell wird nicht einfach stumm von mir „für mich“ genutzt. Ich kann es auf der Plattform bereitstellen. Wenn jemand es aufruft, muss er jedes Mal $OPEN zahlen, und das System teilt automatisch. Ich bekomme den Anteil, der Modellbeitragende Teil geht an mich, die Bereitsteller der Trainingsdaten bekommen ihren Anteil, und die Staker bekommen den Wartungsanteil.
Das ist komplett anders als dieses Prinzip von $BTC , wo Leute selbst Minen, selbst verkaufen. Auch nicht vergleichbar mit $ETH , wo man einfach nur einen Vertrag deployt und dann keine laufenden Einnahmen hat. Das hier ist eine automatisch laufende „Revenue-Split“-Maschine.
Ich hab mir ausgerechnet, was es bringt: Wenn am Tag ein paar Dutzend Leute mein Vertragsmodell verwenden, dann reicht das pro Monat locker, um meine Miete zu zahlen. Und je öfter es aufgerufen wird, desto besser kann das Modell sich anhand von Rückmeldungen weiter optimieren – es wird mit jeder Nutzung genauer.
Ich bereite gerade das zweite Modell vor. Diesmal will ich Richtung Lebenslauf-Screening gehen – die Daten hab ich schon, am Wochenende geht’s los. #OpenLedger