我 habe wieder ein paar zusätzliche Geräte in das Ökosystem von @OpenLedger investiert. Ich habe die letzten Wochen im Detail nachverfolgt und dabei die Feinheiten der Datanet-Erträge gründlich aufgearbeitet. Meine Haltung ist dabei sogar deutlich stabiler geworden als zu Beginn, als ich noch ganz frisch dabei war. Viele sehen sich die sogenannten KI-Datenknoten viel zu einfach an: Sie glauben, wenn man sie einfach ans Netz hängt und im Konto $OPEN verfügbar ist, dann wächst das Vermögen automatisch kontinuierlich. Diese Art von passivem „Wohlfühl“-Vermögensillusion ist in Wahrheit der Traum vieler Einsteiger.
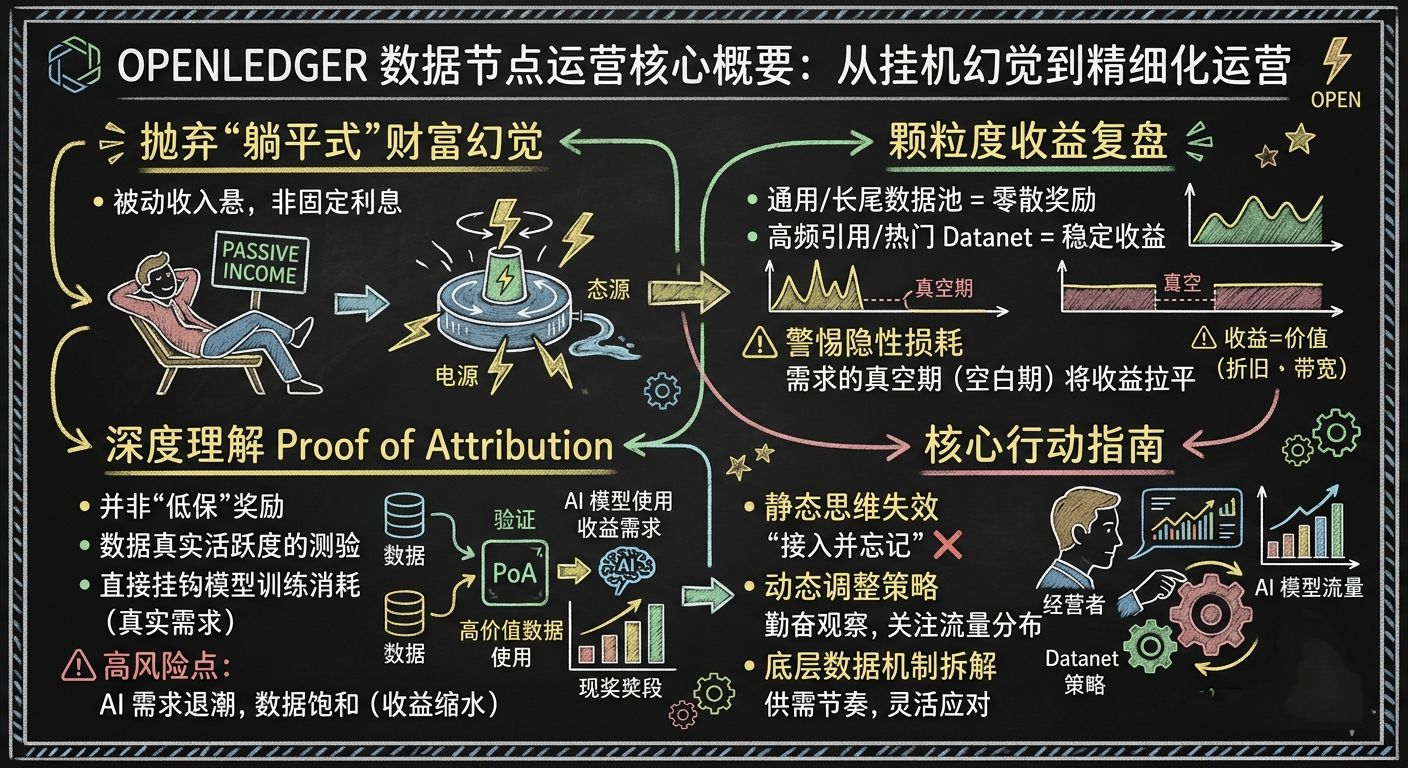
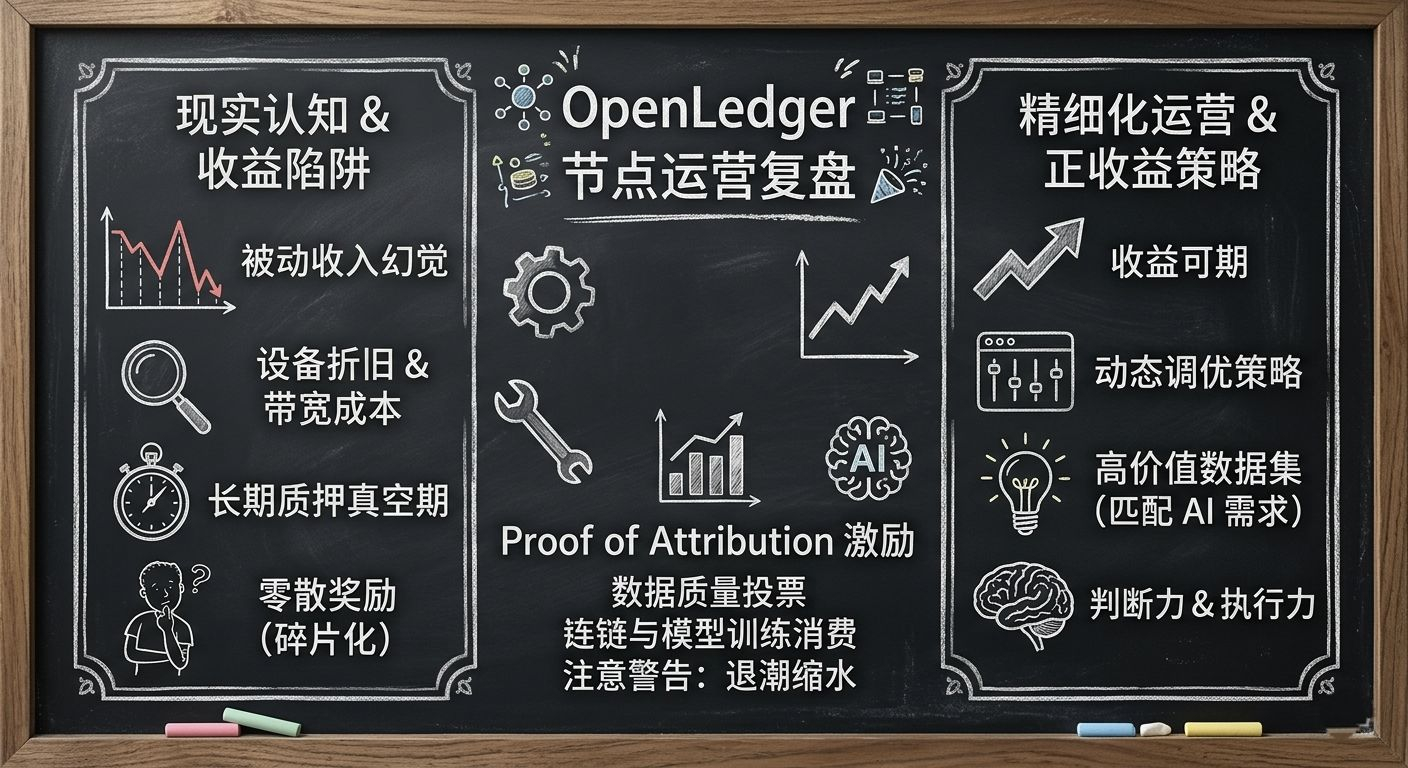
Ich habe mir die bisherigen Interaktionsprotokolle angesehen: Nur um die Zeit im Dauerbetrieb zu maximieren, wurden Knoten an diese langen Schwänze und eher selten genutzten Datensets gekoppelt. Die dadurch entstehenden fragmentierten Belohnungen sind – nachdem man Stromkosten und Netzwerkverluste abgezogen hat – nahezu erschreckend gering. Viele lassen sich von den sogenannten Airdrop-Erwartungen benebeln, aber sie übersehen, dass solche Daten von geringer Qualität im Kontext des KI-Trainings im Grunde überhaupt keine Verhandlungsmacht haben. Im besten Fall liefern sie dem Protokoll nur irgendeine Art von nutzlosen Zusatzlast. Wer in OpenLedger wirklich ein nachhaltiges Ertragsmodell aufbauen will, muss vor allem die Bedeutung der „Assetisierung“ von Daten verstehen. Du musst begreifen: Ein Knoten ist nicht nur ein physisches Endgerät, sondern ein dynamisch zu optimierendes Datenportal.
Durch den Abgleich konnte ich sehen, dass die Knoten, die stabil Erträge erzeugen, ausnahmslos genau die Datanet-Daten abdecken, die die aktuellen Anforderungen beim Training der gängigen Modelle treffen. Hier klafft eine riesige Wissenslücke: Die meisten sehen nur den aktuellen APY, aber sie ignorieren, dass die KI-Trainingsrechenleistung einer stufenweisen Schwankung unterliegt. Wenn du keine Strategie hast, um Datenpuffer vor der Nachfrage-Welle aufzubauen, dann sind deine Bandbreite und deine Speicherkapazität in den meisten Zeiten schlicht im Leerlauf – ineffektiv.
Lass uns auch über das #OpenLedger stark diskutierte Anreizsystem sprechen. Nach langem Beobachten ist mir klar geworden: Die sogenannte Verteilung der Belohnungen ist im Grunde die sofortige Preisbildung des Ökosystems für wertvolle Datensets. Wenn deine Daten nicht direkt die kritischen Pfade treffen – etwa bei Feinabstimmungen großer Modelle oder bei Retrieval-Augmented Generation – dann spielt es keine Rolle, wie lange dein Knoten online ist: Das Belohnungssystem wird sie über algorithmische Gewichtungen herausfiltern.
Kurz gesagt: Auf der $OPEN -„Spur“ sind statische Konfigurationsstrategien inzwischen komplett wirkungslos. Die zukünftige Gewinnspanne gehört nur denen, die den Knoten wirklich als Datenfabrik begreifen und ihn fein abgestimmt im Betrieb optimieren. Merke dir: OpenLedger belohnt niemals primär die reine Online-Zeit deiner Geräte, sondern vielmehr deine Urteils- und Umsetzungskraft als Datenanbieter in dieser Welle des KI-Wandels.
Ich habe mir die bisherigen Interaktionsprotokolle angesehen: Nur um die Zeit im Dauerbetrieb zu maximieren, wurden Knoten an diese langen Schwänze und eher selten genutzten Datensets gekoppelt. Die dadurch entstehenden fragmentierten Belohnungen sind – nachdem man Stromkosten und Netzwerkverluste abgezogen hat – nahezu erschreckend gering. Viele lassen sich von den sogenannten Airdrop-Erwartungen benebeln, aber sie übersehen, dass solche Daten von geringer Qualität im Kontext des KI-Trainings im Grunde überhaupt keine Verhandlungsmacht haben. Im besten Fall liefern sie dem Protokoll nur irgendeine Art von nutzlosen Zusatzlast. Wer in OpenLedger wirklich ein nachhaltiges Ertragsmodell aufbauen will, muss vor allem die Bedeutung der „Assetisierung“ von Daten verstehen. Du musst begreifen: Ein Knoten ist nicht nur ein physisches Endgerät, sondern ein dynamisch zu optimierendes Datenportal.
Durch den Abgleich konnte ich sehen, dass die Knoten, die stabil Erträge erzeugen, ausnahmslos genau die Datanet-Daten abdecken, die die aktuellen Anforderungen beim Training der gängigen Modelle treffen. Hier klafft eine riesige Wissenslücke: Die meisten sehen nur den aktuellen APY, aber sie ignorieren, dass die KI-Trainingsrechenleistung einer stufenweisen Schwankung unterliegt. Wenn du keine Strategie hast, um Datenpuffer vor der Nachfrage-Welle aufzubauen, dann sind deine Bandbreite und deine Speicherkapazität in den meisten Zeiten schlicht im Leerlauf – ineffektiv.
Lass uns auch über das #OpenLedger stark diskutierte Anreizsystem sprechen. Nach langem Beobachten ist mir klar geworden: Die sogenannte Verteilung der Belohnungen ist im Grunde die sofortige Preisbildung des Ökosystems für wertvolle Datensets. Wenn deine Daten nicht direkt die kritischen Pfade treffen – etwa bei Feinabstimmungen großer Modelle oder bei Retrieval-Augmented Generation – dann spielt es keine Rolle, wie lange dein Knoten online ist: Das Belohnungssystem wird sie über algorithmische Gewichtungen herausfiltern.
Kurz gesagt: Auf der $OPEN -„Spur“ sind statische Konfigurationsstrategien inzwischen komplett wirkungslos. Die zukünftige Gewinnspanne gehört nur denen, die den Knoten wirklich als Datenfabrik begreifen und ihn fein abgestimmt im Betrieb optimieren. Merke dir: OpenLedger belohnt niemals primär die reine Online-Zeit deiner Geräte, sondern vielmehr deine Urteils- und Umsetzungskraft als Datenanbieter in dieser Welle des KI-Wandels.