Warum ich denke, dass OpenLedger mehr als nur eine KI-Infrastruktur ist
Ich sehe OpenLedger als mehr als nur eine weitere KI-Infrastruktur-Story. Für mich geht es bei der echten Gelegenheit nicht nur um Daten, Attribution oder Herkunft. Es geht um den Druck, der sich um die KI-Inferenz aufbaut, während Maschinen anfangen, vertrauenswürdigen Kontext zu benötigen, bevor sie handeln.
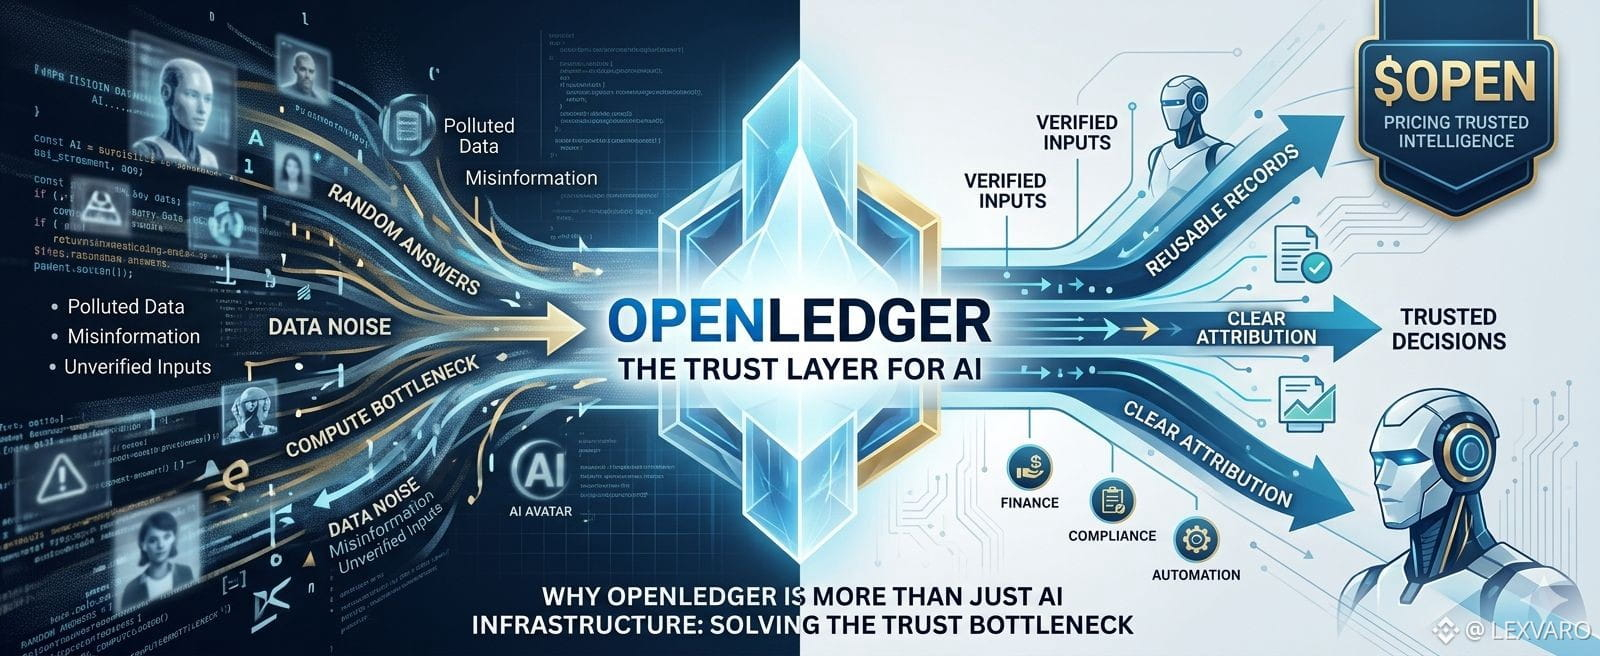
Ich denke, hier wird $OPEN interessant. KI-Antworten sind leicht zu generieren, aber vertrauenswürdige Antworten sind viel schwieriger zu produzieren. Wenn Agenten, Modelle und Anwendungen beginnen, mit Finanzen, Compliance, Trading und Automatisierung umzugehen, können sie sich nicht auf zufällige oder verschmutzte Daten verlassen. Sie benötigen verifizierte Inputs, wiederverwendbare Aufzeichnungen und klare Attribution.
Deshalb glaube ich, dass der Wert von OpenLedger aus Abhängigkeit kommen könnte, nicht nur aus Aktivität. Jeder kann durch Anreize eine Teilnahme schaffen, aber echte Nachfrage erscheint, wenn KI-Systeme immer wieder auf dieselben verifizierten Daten zurückgreifen, weil sie die Ergebnisse verbessern.
Ich sehe den zukünftigen Engpass in der KI als Vertrauen, nicht nur als Rechenleistung. Mehr Modelle und mehr Inhalte werden mehr Lärm erzeugen. Die wertvolle Schicht wird die sein, die entscheidet, was vertrauenswürdig, wiederverwendbar, anerkannt und bezahlt werden sollte.
Wenn OpenLedger diese Schicht werden kann, dann könnte $OPEN nicht nur die Teilnahme preisgeben. Es könnte vertrauenswürdige Intelligenz bepreisen.
#OpenLedger @OpenLedger $OPEN
Ich sehe OpenLedger als mehr als nur eine weitere KI-Infrastruktur-Story. Für mich geht es bei der echten Gelegenheit nicht nur um Daten, Attribution oder Herkunft. Es geht um den Druck, der sich um die KI-Inferenz aufbaut, während Maschinen anfangen, vertrauenswürdigen Kontext zu benötigen, bevor sie handeln.
Ich denke, hier wird $OPEN interessant. KI-Antworten sind leicht zu generieren, aber vertrauenswürdige Antworten sind viel schwieriger zu produzieren. Wenn Agenten, Modelle und Anwendungen beginnen, mit Finanzen, Compliance, Trading und Automatisierung umzugehen, können sie sich nicht auf zufällige oder verschmutzte Daten verlassen. Sie benötigen verifizierte Inputs, wiederverwendbare Aufzeichnungen und klare Attribution.
Deshalb glaube ich, dass der Wert von OpenLedger aus Abhängigkeit kommen könnte, nicht nur aus Aktivität. Jeder kann durch Anreize eine Teilnahme schaffen, aber echte Nachfrage erscheint, wenn KI-Systeme immer wieder auf dieselben verifizierten Daten zurückgreifen, weil sie die Ergebnisse verbessern.
Ich sehe den zukünftigen Engpass in der KI als Vertrauen, nicht nur als Rechenleistung. Mehr Modelle und mehr Inhalte werden mehr Lärm erzeugen. Die wertvolle Schicht wird die sein, die entscheidet, was vertrauenswürdig, wiederverwendbar, anerkannt und bezahlt werden sollte.
Wenn OpenLedger diese Schicht werden kann, dann könnte $OPEN nicht nur die Teilnahme preisgeben. Es könnte vertrauenswürdige Intelligenz bepreisen.
#OpenLedger @OpenLedger $OPEN