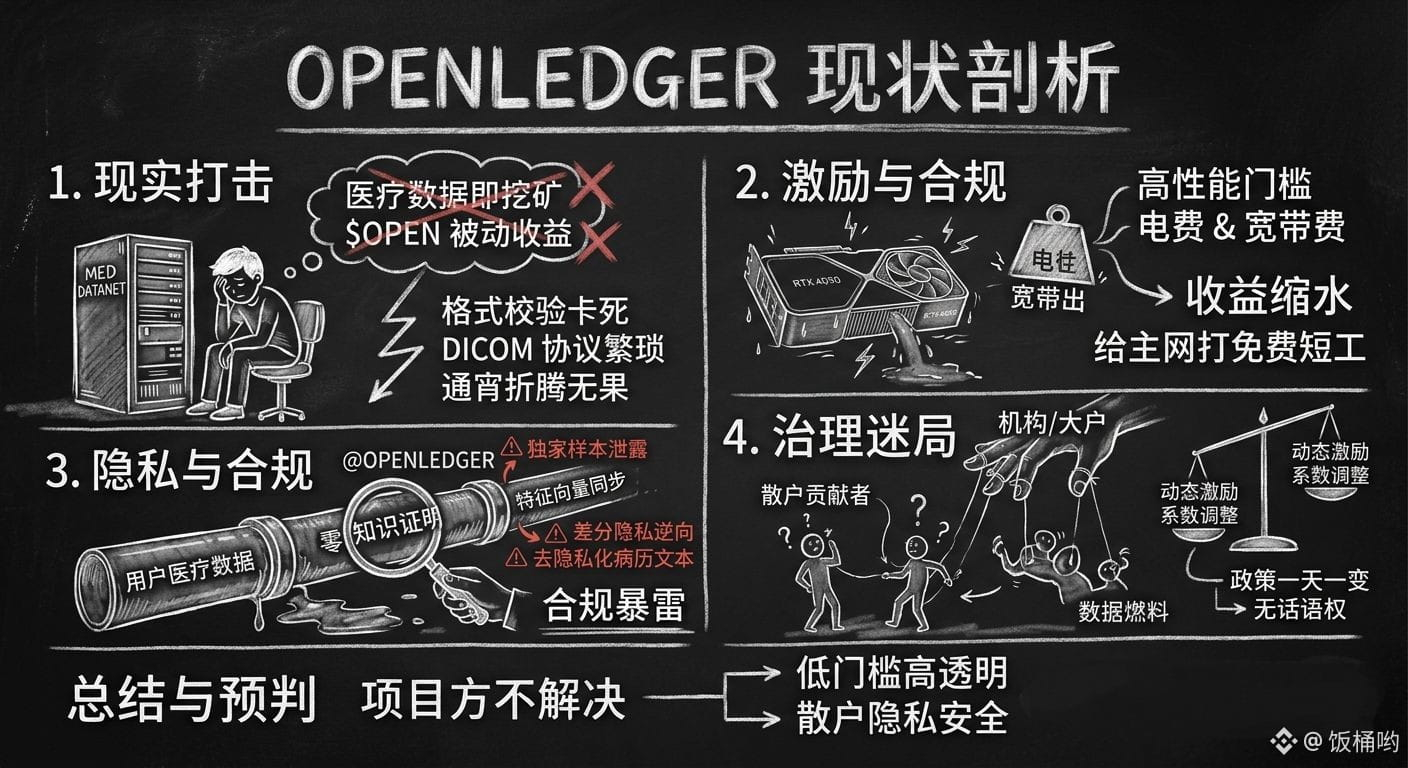
Neulich wurde auf dem Platz überall die KI-Medizinbild-Annotation-Platform von @OpenLedger angepriesen. Aus lauter Impuls habe ich das von mir im Studio gehortete Batch an Datensätzen mit Hautpathologie-Schnittbildern nach Med DataNet hochgeladen. Ergebnis: Ich habe mich damit einen ganzen Schlaf durchgearbeitet, hängengeblieben bei der Formatvalidierung, kam keinen Schritt weiter – die umständlichen DICOM-Konvertierungsprotokolle und die Logik zur Tag-Ausrichtung haben mich fast in den Wahnsinn getrieben.
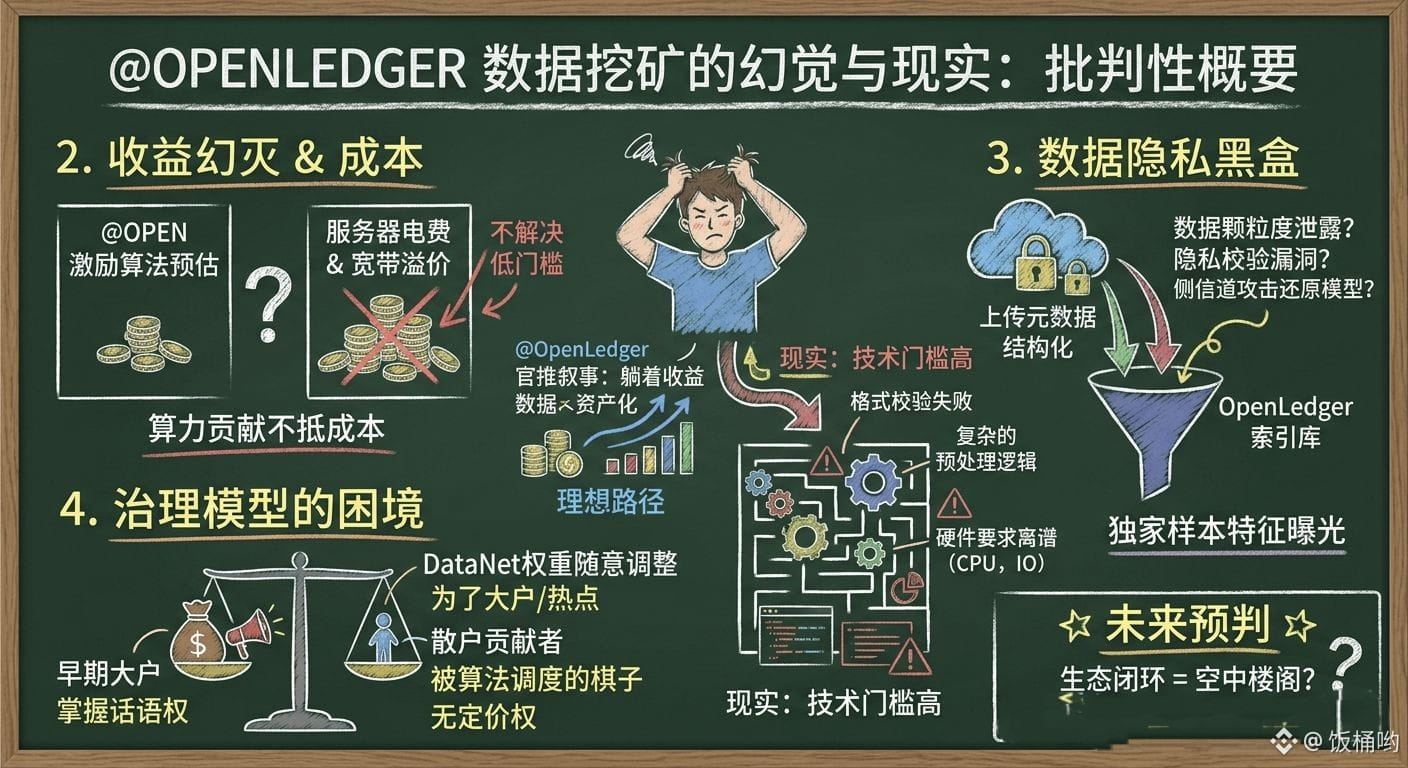
Ich gestehe: Vorher war ich von dieser offiziellen Render-Story des „Medizin-Daten-Mining“-Riesenplans heiß gemacht worden. Ich hatte mir eingeredet, dass ich einfach meine versteckten Assets hochlade und dann passives Einkommen aus $OPEN bekomme. Aber als ich dann wirklich zur Bereitstellung und Verifikation der Knoten ging, hat mir die Realität eine rechte Ohrfeige verpasst. In den offiziellen Dokumenten nennen sie das „Low-Barrier“-Mitbau, in Wahrheit sind die Anforderungen an GPU-Speicher und Netzwerk-Durchsatz so hoch, dass man nur staunen kann. Mit meiner eigenen 4090-Workstation habe ich drei Tage durchgerattert. Nach ihrer neuesten dynamischen Bonusformel gerechnet: Wenn man die Stromkosten mit durchgehend Vollauslastung und die Gebühren für den Business-Internetanschluss abzieht, ist das, was am Ende bei mir rauskommt, nicht mal genug, um $OPEN für einen Kaffee zu holen. Im Grunde mache ich nur Gratisarbeit für das Mainnet.
Noch beängstigender als die geschrumpfte Rendite ist aber das endlose schwarze Loch bei Daten-Urheberschaft (Datenrechte) und Compliance. @OpenLedger prahlt bei jedem mit ihren Zero-Knowledge-Proofs und der homomorphen Verschlüsselung und behauptet, dass Daten verfügbar, aber nicht sichtbar seien. In der Praxis brauchst du jedoch, um überhaupt an die Rechte für höherstufige Incentive-Gewichte zu kommen, dass du die Datenmerkmalsvektoren und die entprivatisierten Befundtexte synchron in einem Paket bereitstellst. Medizinische Daten seien angeblich dezentral und anonym gespeichert – aber wer garantiert, dass die Routing-Knoten in der Retrieval-Schicht nicht von Hackern durch Reverse Engineering mittels Differential Privacy geknackt werden? Sobald exklusive Samples geleakt werden, wer bekommt dann den Ärger? Nicht etwa die Angreifer, sondern doch wir, die digitalen Miner, die die Daten zuerst bereitstellen? #OpenLedger
Was mich noch mehr runterzieht, ist die Atmosphäre rund um die Community-Governance von $OPEN : Politik wechselt Tag für Tag, und wir Kleinanleger haben nicht einmal ein Recht auf vollständige Information, geschweige denn Mitspracherechte. Ganz offen: Wir sind schlicht das Treibstoffmaterial, das die Algorithmus-Macher immer wieder abgrasen. Ich habe die Märchenwelt jetzt komplett hinter mir. @OpenLedger – passiert hier wirklich eine echte Umwälzung bei der Verteilung von AI-Produktionsmitteln, oder wird nur unter dem Deckmantel von „dezentralem AI“ ein neuer Rundgang für Traffic-Pudding aufgebaut, ohne dass man überhaupt darüber diskutieren müsste? Die Antwort lasse ich hier: Wenn das Projektteam Privatsphäre-Sicherheit und Transparenz der Einnahmen für Kleinanleger nicht ernst nimmt, dann ist dieses angebliche „Web3+AI“-Narrativ am Ende nur Spiegel-und-Wasser – unabhängig davon, wie sehr ein paar Großadressen in der Community links die Hand und rechts die Hand tauschen.
Ich gestehe: Vorher war ich von dieser offiziellen Render-Story des „Medizin-Daten-Mining“-Riesenplans heiß gemacht worden. Ich hatte mir eingeredet, dass ich einfach meine versteckten Assets hochlade und dann passives Einkommen aus $OPEN bekomme. Aber als ich dann wirklich zur Bereitstellung und Verifikation der Knoten ging, hat mir die Realität eine rechte Ohrfeige verpasst. In den offiziellen Dokumenten nennen sie das „Low-Barrier“-Mitbau, in Wahrheit sind die Anforderungen an GPU-Speicher und Netzwerk-Durchsatz so hoch, dass man nur staunen kann. Mit meiner eigenen 4090-Workstation habe ich drei Tage durchgerattert. Nach ihrer neuesten dynamischen Bonusformel gerechnet: Wenn man die Stromkosten mit durchgehend Vollauslastung und die Gebühren für den Business-Internetanschluss abzieht, ist das, was am Ende bei mir rauskommt, nicht mal genug, um $OPEN für einen Kaffee zu holen. Im Grunde mache ich nur Gratisarbeit für das Mainnet.
Noch beängstigender als die geschrumpfte Rendite ist aber das endlose schwarze Loch bei Daten-Urheberschaft (Datenrechte) und Compliance. @OpenLedger prahlt bei jedem mit ihren Zero-Knowledge-Proofs und der homomorphen Verschlüsselung und behauptet, dass Daten verfügbar, aber nicht sichtbar seien. In der Praxis brauchst du jedoch, um überhaupt an die Rechte für höherstufige Incentive-Gewichte zu kommen, dass du die Datenmerkmalsvektoren und die entprivatisierten Befundtexte synchron in einem Paket bereitstellst. Medizinische Daten seien angeblich dezentral und anonym gespeichert – aber wer garantiert, dass die Routing-Knoten in der Retrieval-Schicht nicht von Hackern durch Reverse Engineering mittels Differential Privacy geknackt werden? Sobald exklusive Samples geleakt werden, wer bekommt dann den Ärger? Nicht etwa die Angreifer, sondern doch wir, die digitalen Miner, die die Daten zuerst bereitstellen? #OpenLedger
Was mich noch mehr runterzieht, ist die Atmosphäre rund um die Community-Governance von $OPEN : Politik wechselt Tag für Tag, und wir Kleinanleger haben nicht einmal ein Recht auf vollständige Information, geschweige denn Mitspracherechte. Ganz offen: Wir sind schlicht das Treibstoffmaterial, das die Algorithmus-Macher immer wieder abgrasen. Ich habe die Märchenwelt jetzt komplett hinter mir. @OpenLedger – passiert hier wirklich eine echte Umwälzung bei der Verteilung von AI-Produktionsmitteln, oder wird nur unter dem Deckmantel von „dezentralem AI“ ein neuer Rundgang für Traffic-Pudding aufgebaut, ohne dass man überhaupt darüber diskutieren müsste? Die Antwort lasse ich hier: Wenn das Projektteam Privatsphäre-Sicherheit und Transparenz der Einnahmen für Kleinanleger nicht ernst nimmt, dann ist dieses angebliche „Web3+AI“-Narrativ am Ende nur Spiegel-und-Wasser – unabhängig davon, wie sehr ein paar Großadressen in der Community links die Hand und rechts die Hand tauschen.