
OpenLedger und das seltsame Gefühl, dass KI möglicherweise endlich auf dieselbe Mauer trifft.
Ich bin lange genug in Krypto unterwegs, um nicht jedes Mal zu reagieren, wenn ein Projekt behauptet, es würde „etwas neu definieren“.
Meistens sind diese Worte nur recycelte Verpackung rund um dieselben alten Anreize. Neuer Token, neues Branding, dieselbe zugrunde liegende Realität: Ein paar Eingeweihte schöpfen den Wert ab, das Publikum stellt die Liquidität bereit, und irgendwann zieht die Erzählung weiter.
Wahrscheinlich ist das der Grund, warum ich in letzter Zeit langsamer dabei geworden bin, mich für irgendetwas mit KI zu begeistern. Der Raum fühlt sich ohnehin schon überfüllt an mit überdimensionierten Versprechen. Jede Woche gibt es ein weiteres Protokoll, das behauptet, es werde Intelligenz dezentralisieren, Agenten tokenisieren, das Rechnen neu erfinden oder sogar das Internet selbst ersetzen. Nach einer Weile verschwimmt alles zu demselben Hintergrundrauschen.
Aber hin und wieder fängt etwas meine Aufmerksamkeit ein – nicht weil ich plötzlich daran glaube, sondern weil es sich auf ein Problem zu fokussieren scheint, das tatsächlich existiert.
OpenLedger ist für mich eines dieser Projekte.
Ich sage nicht, dass es funktioniert. Ich sage nicht, dass es gewinnt. Ich sage nicht einmal, dass das Modell nachhaltig ist. Ich weiß es ehrlich gesagt noch nicht.
Aber ich merke immer wieder, dass die zugrunde liegende Frage, die sie stellen, sich viel echter anfühlt als die meisten KI-Erzählungen, die gerade durch den Krypto-Raum treiben.
Die Frage ist einfach: Wenn KI-Modelle zu den wertvollsten Systemen der Welt werden, warum weiß dann fast niemand mehr, wo der Wert eigentlich herkommt?
Das klingt auf den ersten Blick offensichtlich, aber je tiefer man darüber nachdenkt, desto seltsamer beginnt die gesamte KI-Ökonomie auszusehen.
Die meisten KI-Systeme werden heute auf Ozeanen von Daten aufgebaut, die von Menschen gesammelt wurden, die in der Regel nie eine Entschädigung, Eigentumsrechte oder auch nur eine Anerkennung sehen. Schriftsteller, Künstler, Forschende, Foren-User, Entwickler, Nischen-Communities, zufällige Internet-Archive – alles wird in Modelle eingesogen, die sich schließlich zu Produkten entwickeln, die Milliarden wert sind.
Und irgendwie hat einfach jeder akzeptiert, dass das normal ist.
Vielleicht, weil die Systeme zu groß geworden sind, um sie noch zu hinterfragen. Vielleicht, weil die Unternehmen, die sie bauen, schneller vorangekommen sind als die Regulierung. Vielleicht, weil niemand realistisch verfolgen konnte, wem was zugeschrieben wird, sobald die Modelle ein gewisses Ausmaß erreicht haben.
Dieser letzte Punkt ist entscheidend.
Seit Jahren ist eines der größten Probleme in der KI die Attribution selbst. Sobald ein Modell auf genug Daten trainiert, wird die Rückverfolgung von Einfluss immer unschärfer. Das Ganze wird zu einer Blackbox. Manchmal ist es eine nützliche Blackbox, aber trotzdem eine Blackbox.
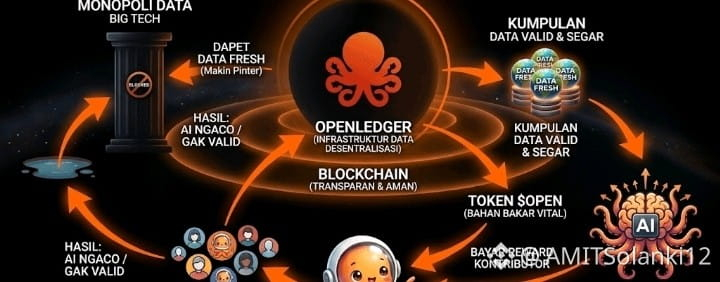
Das ist der Teil, um den OpenLedger mit dieser Idee von Proof of Attribution immer wieder kreist.
Das Konzept klingt beim ersten Lesen fast schon zu ambitioniert. Das Protokoll versucht, Modell-Ausgaben zurück mit den Daten zu verbinden, die sie beeinflusst haben, und belohnt dann Mitwirkende anteilig über das Netzwerk.
Ich habe gesehen, wie Krypto zuvor schon Ähnliches in verschiedenen Formen versucht hat. Tantiemen für Musik. Creator Economies. Speicher-Anreize. Aufmerksamkeitsmärkte. Datenmärkte.
Die meisten sind irgendwann an derselben Mauer gelandet: Einen Beitrag auf sinnvolle Weise zu messen, ist brutal schwer.#OpenAIToConfidentiallyFileForIPO $OPEN
#