
Als unabhängiger Entwickler habe ich anderthalb Monate damit verbracht, eine Desktop-Anwendung namens "Xiao Nan Web3 Sentinel" zu erstellen, die Web3-Dual-Chain-Asset-Überwachung und intelligente Analyse bietet. Sie unterstützt alle EVM-kompatiblen Chains und die Solana-Chain, integriert AI-Trade-Interpretationen, Multi-Channel-Push und On-Chain-Datenaggregation sowie viele weitere fortschrittliche Funktionen und läuft stabil seit mehreren Monaten.
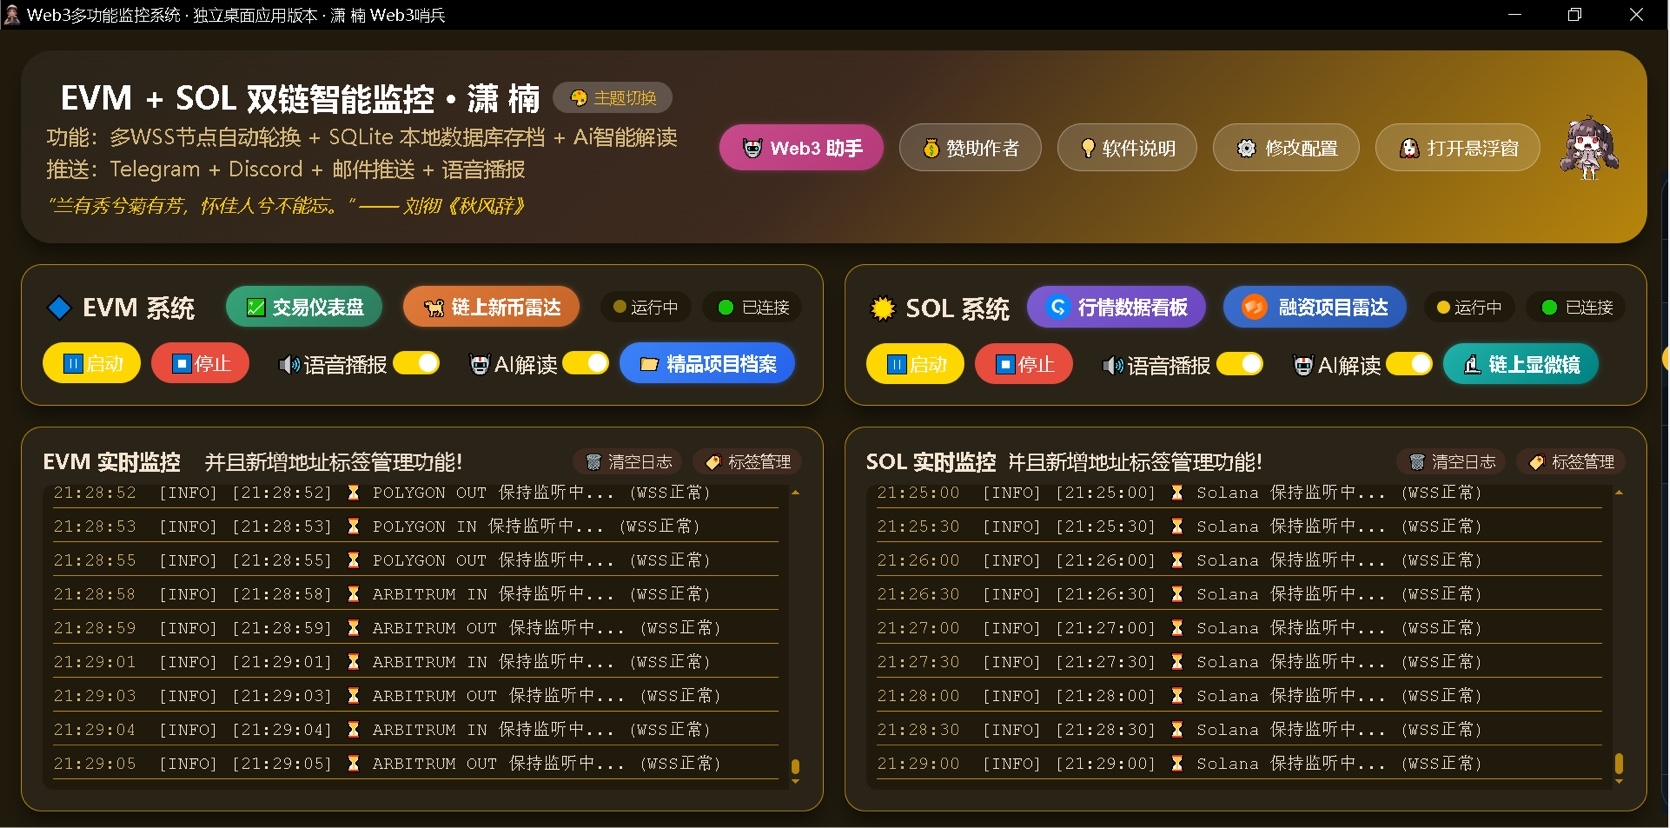
Vor kurzem habe ich einen technischen Überblick veröffentlicht, aber ich hatte das Gefühl, dass die Analyse der Kernimplementierung noch nicht ganz "stillt". Daher habe ich mich entschieden, diesen tiefgehenden technischen Rückblick zu schreiben. Ich werde ohne Zurückhaltung die Designentscheidungen und Implementierungsdetails teilen, die tief im Code verborgen sind, aus Perspektiven wie Prozessarchitektur, I/O-Modell, Datenkonsistenz und AI-Engineering. Ich hoffe, dass dieser Artikel Entwicklern, die ebenfalls im Web3-Bereich unterwegs sind, wertvolle Anhaltspunkte bietet.
Einführung in die Prozessarchitektur: Warum haben wir uns für "Hauptprozess + mehrere Unterprozesse" entschieden?
Viele Python-Monitoring-Skripte auf dem Markt verwenden einen einzelnen Prozess asyncio, aber ich habe von Anfang an die Mikro-Kernel-Architektur "Hauptprozess (GUI) + unabhängiger Unterprozess (EVM/SOL)" entschieden.
1.1 Isolation und Stabilität stehen über allem
WebSocket-Dauerverbindungen sind bei Netzwerkschwankungen anfällig für unerwartete Wiederverbindungen, und selbst die C-Erweiterungen der zugrunde liegenden Bibliotheken können aus unbekannten Gründen abstürzen. Wenn GUI und Überwachungslogik in einem Prozess vermischt sind, kann jede nicht gefangene Ausnahme oder Verletzung des Speicherzugriffs dazu führen, dass die gesamte Desktop-Anwendung abstürzt. Durch subprocess.Popen habe ich die EVM- und Solana-Überwachungslogik in unabhängige Unterprozesse gegliedert, wodurch ich physikalische Isolation erreicht habe: Evm.py kann abstürzen oder gewaltsam beendet werden, das Hauptfenster läuft weiterhin normal, das Tray-Icon verschwindet nicht, und der Benutzer kann auf „Start“ klicken, um es erneut zu starten.
Log-Throughput: Der Hauptprozess fängt die stdout des Unterprozesses über Pipes ab und liest sie zeilenweise mit dem forwardoutput-Thread, reinigt ANSI-Farbcodes und injiziert sie dann über window.evaluate_js in das Frontend-DOM, wodurch die Protokollaktualisierung in Echtzeit erfolgt und gleichzeitig der UI-Thread leicht bleibt.
1.2 Details der Lebenszyklusverwaltung
Im core_process.py ist das Stoppen von Unterprozessen nicht einfach terminate(). Ich habe einen starken Kill-Mechanismus implementiert:
python
proc.terminate()
proc.wait(timeout=3)
if proc.poll() is None:
proc.kill()
proc.wait(timeout=2)
if proc.poll() is None:
os.system(f'taskkill /F /PID {proc.pid}')
Dieses Set von Maßnahmen stellt sicher, dass selbst wenn der Python-Interpreter abstürzt, das Windows-Betriebssystem den Prozessbaum vollständig bereinigen kann, um zu verhindern, dass verbleibende Prozesse Ports oder Datenbanksperren belegen und den nächsten Start verhindern.
Zwei. I/O-Modell und hochverfügbare Verbindungen: Mehr als nur asyncio
2.1 Hybrides Überwachungsmodell: WSS Echtzeit + RPC-Kompensation
Für native Münzen der EVM-Kette gibt es kein standardmäßiges Transferereignisprotokoll, sodass keine WSS-Abonnements möglich sind. Ich habe einen Polling-Compensator entworfen: Alle 60 Sekunden wird über RPC eth_getBalance abgefragt, und wird mit dem Snapshot im Speicher verglichen; wenn die Differenz über 1e-18 liegt, wird eine Push-Nachricht ausgelöst. Dieser scheinbar einfache Mechanismus ist tatsächlich die letzte Verteidigungslinie, wenn das WSS-Abonnement nicht mehr aktiv ist.
Für Token und NFTs abonniert das System Logs und verarbeitet die ERC1155 TransferSingle- und TransferBatch-Ereignisse detailliert. Insbesondere enthält das data-Feld von TransferBatch ein dynamisches Array, und ich habe eine manuelle Offset-Analyse basierend auf der ABI-Spezifikation implementiert, anstatt auf schwere Bibliotheken zu vertrauen, was die Analyseausgaben erheblich reduziert.
2.2 Exponentielles Backoff für WSS und Hot-Switching von Knoten
In Produktionsumgebungen können öffentliche RPC/WSS-Knoten jederzeit drosseln oder ausfallen. Ich habe im chain_wss_monitor_direction eine Strategie für Knotenrotation und Wiederverbindung implementiert:
Knotenpool: In der Konfigurationsdatei sind für jede Kette mehrere WSS_NODES konfiguriert, die beim Start zufällig oder in Reihenfolge ausgewählt werden.
Backoff-Algorithmus: Nach einer Verbindungsunterbrechung beginnt das Wiederholungsintervall bei 5 Sekunden und verdoppelt sich jedes Mal bis zu 60 Sekunden, um eine DDoS-artige Wiederverbindungswelle zu vermeiden, bevor der Knoten wiederhergestellt ist.
Anpassung der nationalen Netzwerkinfrastruktur: Das System unterstützt die Konfiguration der HTTP-Adresse lokaler Proxy-Software und leitet den WSS-Datenverkehr über die websockets_proxy-Bibliothek an den Proxy weiter, um die stabile Kommunikation mit ausländischen Knoten wiederherzustellen.
2.3 Asynchrone Parsing-Pipeline von Solana
Die Blockgeschwindigkeit von Solana ist extrem schnell, und die Transaktionsstruktur ist komplex. Um zu verhindern, dass API-Aufrufe von Helius WSS-Nachrichteneingänge blockieren, habe ich ein entkoppeltes Modell für Produzenten und Verbraucher entworfen:
Produzenten: WSS logsSubscribe wirft die Signatur sofort in asyncio.Queue oder löst direkt eine Hintergrund-Aufgabe mit asyncio.create_task aus.
Verbraucher: Unabhängige asynchrone Aufgaben sind verantwortlich für den Aufruf der Helius /v0/transactions-Schnittstelle und die Analyse der Felder nativeTransfers, tokenTransfers, events.nft usw.
Dies gewährleistet, dass die recv()-Schleife der WSS-Verbindung niemals von langsamen HTTP-Anfragen blockiert wird und die Echtzeitkommunikation von Nachrichten in einer Umgebung mit extrem hohen TPS sichergestellt ist.
Drei. Datenkonsistenz: Von der Speicher-Deduplizierung zu SQLite-Beschränkungen
3.1 EVM-Seite: Eindeutiger Datenbankindex
Im EVM-Monitoring könnte dieselbe Transaktion aufgrund von WSS-Wiederverbindungen, Polling-Kompensationen usw. mehrmals verarbeitet werden. Das bloße Verlassen auf das Memory-Set reicht nicht aus, um mit Prozessneustarts umzugehen. Daher habe ich einen zusammengesetzten eindeutigen Constraint für die tx_history-Tabelle entworfen:
sql
UNIQUE(tx_hash, log_index, address)
Jede wiederholte Einfügung wird von SQLite's ON CONFLICT IGNORE stillschweigend verworfen, was Idempotenz auf der Ebene des Datenbankkerns garantiert. Für native Münztransfers ohne log_index wird tx_hash + address als zusammengesetzter Schlüssel verwendet.
3.2 Solana-Seite: Signatur-Deduplizierung innerhalb des Zeitfensters
Solana-Transaktionen haben kein log_index-Konzept, und Helius-Analysen können mehrere Datensätze erzeugen. Ich habe ein Memory-Set verwendet, um die zuletzt verarbeiteten Signaturen zu speichern und basierend auf der Idee des LimitedSizeDict eine Variante implementiert, die bei mehr als 1000 Signaturen automatisch die Hälfte leert (oder das älteste Element aus OrderedDict entfernt). Dieses Sliding-Window-Deduplizieren erzielt ein gutes Gleichgewicht zwischen Leistung und Genauigkeit.
Vier. AI-Engineering: Fehlertoleranz und die Kunst der JSON-Analyse bei mehreren Anbietern
4.1 Merkmalsgetriebenes dynamisches Scheduling
MultiAIClient ist das Herzstück des AI-Moduls. Es ist kein einfacher if-else-Zweig, sondern ein Scheduler, der auf Feature-Flags basiert. In der Konfigurationsdatei sind die von jedem Anbieter unterstützten Funktionen (wie transaction_insight, daily_report usw.) definiert. Bei der Anforderungsinterpretation filtert das System die Liste der Anbieter, die dieses Feature unterstützen, nach Priorität und startet die Anfragen; bei Timeout oder Fehler wird automatisch auf den nächsten Anbieter herabgestuft.
4.2 Defensive Analyse von LLM-Ausgaben
Große Modellausgaben in JSON sind unzuverlässig. Mein Verarbeitungsfluss ist viel komplexer als json.loads:
Reinigung: Markdown-Codeblock-Markierungen json` und entfernen.
Reguläre Ausdrücke: Wenn die Analyse fehlschlägt, benutze direkt den regulären Ausdruck r'"insight"\s*:\s*"([^"]*)"', um das Feld gewaltsam zu extrahieren, das ist die letzte Verteidigungslinie.
Feldzuordnung: Kompatibel mit verschiedenen Schlüsselbenennungen wie insight / Insight / Interpretation usw.
Dieses Mechanismus stellt sicher, dass selbst wenn Moonshot oder DeepSeek "ein halbes JSON" zurückgeben, das Frontend immer noch eine effektive Interpretation anzeigen kann, ohne dass JSONDecodeError einen weißen Bildschirm verursacht.
Fünf. Speicher und Leistung: LimitedSizeDict und asynchrone Warteschlangen
5.1 Benutzerdefiniertes Wörterbuch mit begrenzter Kapazität
Die Python-Standardbibliothek enthält kein eingebautes LRU-Dictionary mit Größenbeschränkung. Ich habe auf der Basis von collections.OrderedDict ein LimitedSizeDict implementiert:
python
def setitem(self, key, value):
if len(self) >= self.max_size:
self.popitem(last=False) # Entferne das früheste Element
super().__setitem__(key, value)
Diese einfache Datenstruktur wird für die Token-Informations-Caching, Preis-Caching und NFT-Metadaten-Caching verwendet. Sie stellt sicher, dass der Speicherverbrauch über lange Laufzeiten nicht linear mit der Zunahme der überwachten Adressen ansteigt, sondern auf einem sehr niedrigen Niveau stabil bleibt.
5.2 Asynchrone serielle Schreibvorgänge von Solana-Logs
Detaillierte Transaktionsprotokolle von Solana müssen in eine JSON-Datei geschrieben werden. Wenn mehrere Coroutinen gleichzeitig json.dump verwenden, kann dies leicht zu beschädigten Dateiformaten führen. Ich habe asyncio.Queue eingeführt:
Alle Schreibprotokollanfragen legen Daten in die Warteschlange.
Der einzige Hintergrund-Coroutine filewriter blockiert, wartet auf die Warteschlange, entnimmt Daten und führt dann Datei-I/O aus.
Dies vermeidet komplexe Thread-Locks und nutzt die asynchrone Eigenschaft, um die Datensicherheit unter hoher Last zu gewährleisten.
6. Bidirektionale Kommunikation zwischen Frontend und Backend: Tiefe Integration von pywebview
6.1 JS API-Injection
pywebview ermöglicht es, die Methoden von Python-Objekten direkt an das Frontend-JavaScript zu exponieren. Meine Api-Klasse erbt von mehreren Mixins, und alle öffentlichen Methoden, die mit def beginnen, werden automatisch Mitglieder von window.pywebview.api. Dadurch kann ich die Trennung von Frontend und Backend mit sehr geringen Kosten erreichen, wobei das Frontend sich nur auf die UI-Interaktion konzentrieren muss.
6.2 Unabhängige Instanzen des schwebenden Fensters und Kommunikation
Das schwebende Fenster ist kein untergeordnetes DIV des Hauptfensters, sondern ein zweites unabhängiges Fenster, das von pywebview erstellt wurde. Ich verwalte seinen Lebenszyklus über den FloatingWindowManager und nutze die js_api-Instanz des Hauptprozesses, um JS-Code in das schwebende Fenster zu injizieren (evaluate_js), was eine Echtzeitübertragung der Protokolle vom Hauptfenster zum schwebenden Fenster ermöglicht. Dieses Design stellt sicher, dass das schwebende Fenster, selbst wenn es geschlossen wird, den Betrieb der Hauptüberwachungsaufgabe nicht beeinträchtigt.
Sieben. Desktop-Anwendungs-Paketierung: Die Fallstricke von PyInstaller und praktische Erfahrungen im Engineering
Die Bereitstellung von Python-Projekten an Endbenutzer ohne technische Hintergründe erfordert das Packaging in eine eigenständige EXE. PyInstaller scheint mit einem Befehl erledigt zu sein, aber in komplexen Projekten verstecken sich unzählige Details, die Entwickler zum Verzweifeln bringen können. In diesem Abschnitt teile ich einige typische Fallen und Lösungen, die ich während des Packaging-Prozesses für "Xiaonan Web3 Sentinel" erlebt habe.
7.1 Implizite Importe und --hidden-import
PyInstaller erstellt den Abhängigkeitsbaum durch statische Analyse der Importanweisungen in der Eingabedatei. Viele Bibliotheken (wie pystray, websockets) verwenden jedoch importlib.import_module oder import, um Untermodule dynamisch zu laden, was dazu führt, dass die EXE zur Laufzeit ModuleNotFoundError auswirft.
Der Schlüssel zur Lösung dieses Problems liegt darin, die fehlenden Module anhand der Fehlermeldungen rückzuverfolgen und in den Packaging-Befehlen explizit --hidden-import zu deklarieren. Zum Beispiel muss die Tray-Icon-Funktion in diesem Projekt hinzugefügt werden:
bash
--hidden-import pystray._win32
--hidden-import pystray._util
--hidden-import win32event
--hidden-import win32api
Dies erfordert, dass Entwickler ein gewisses Verständnis für die interne Struktur der Abhängigkeiten haben, und oft ist es notwendig, den Quellcode zu lesen und durch Trial and Error alle impliziten Abhängigkeiten vollständig aufzulisten.
7.2 --collect-all und Ressourcen-Datei-Fallen
Die pywebview-Bibliothek enthält nicht nur Python-Code, sondern hängt auch von Frontend-HTML/JS und Edge WebView2-Laufzeitdateien ab. Die Standardanalyse von PyInstaller kann diese nicht-Code-Ressourcen nicht erkennen. Ohne weitere Maßnahmen kann das Programm nach dem Packaging aufgrund der fehlenden index.html oder webview.js einen weißen Bildschirm zeigen.
Die richtige Handhabung besteht darin, --collect-all pywebview zu verwenden; dieses Argument zwingt PyInstaller, alle Dateien im pywebview-Paketverzeichnis (einschließlich Binär- und statischer Ressourcen) vollständig in das Verpackungsverzeichnis zu kopieren. Dies ist der Standardansatz für die Behandlung solcher "schweren" GUI-Bibliotheken.
7.3 Binärabhängigkeiten und UPX-Kompression
Die Projektabhängigkeiten pywin32, Pillow usw. enthalten .pyd- und .dll-Binärdateien. Diese Dateien sind recht groß und werden nach dem Packaging mit PyInstaller nicht automatisch komprimiert. Durch die Integration des UPX-Tools und die Angabe von --upx-dir im Packaging-Befehl können die Binärdateien im endgültigen EXE mit einer hohen Kompressionsrate komprimiert werden (normalerweise 30%-50% Volumenreduktion). Es ist zu beachten, dass einige wenige veraltete Antivirenprogramme möglicherweise falsch positive Ergebnisse bei UPX-geschützten Programmen erzeugen, aber für technisch versierte Nutzer ist diese Wahrscheinlichkeit sehr gering und kann durch Einreichung von Mustern aufgehoben werden.
7.4 Pfad "Einfrieren" und sys._MEIPASS
Dies ist das Kernkonzept im Packaging mit PyInstaller. In der Entwicklungsphase greift das Programm auf Konfigurationsdateien und Bildressourcen über file oder relative Pfade zu. Nach der Packung in eine Einzeldatei EXE werden alle Ressourcen in ein temporäres Verzeichnis entpackt, dessen Pfad in der sys._MEIPASS-Variable gespeichert ist.
Entwickler müssen die gesamte Logik für den Dateizugriff im Code global ersetzen. Ein typisches Muster sieht wie folgt aus:
python
def get_resource_path(relative_path):
if getattr(sys, 'frozen', False):
base = sys._MEIPASS
else:
base = os.path.abspath(".")
return os.path.join(base, relative_path)
Das Ignorieren dieser Anpassung führt dazu, dass das Programm zur Laufzeit keine externen Dateien finden kann, was Neulinge oft in das "Pfad-Hell" führt. Mein Ansatz ist, diese Funktion in utils.py zu kapseln und im gesamten Projekt einheitlich aufzurufen, um sicherzustellen, dass das Pfadverhalten vor und nach dem Packaging konsistent ist.
7.5 Besondere Behandlung von Unterprozessen
Dieses System verwendet einen Hauptprozess zum Starten von Unterprozessen. Nach dem Packaging sind die Unterprozess-Skripte Evm.py und Sol.py ebenfalls in der EXE verpackt. Wenn der Hauptprozess weiterhin versucht, Evm.py mit python.exe zu starten, schlägt dies aufgrund fehlender Dateien fehl. Meine Lösung besteht darin, beim Starten des Unterprozesses dynamisch zu prüfen, ob wir uns im Packaging-Modus befinden, und den richtigen --main-exe-dir-Parameter zu übergeben, damit der Unterprozess das Verzeichnis der Konfigurationsdatei finden kann. Diese logischen Details wurden im Abschnitt zur Prozessarchitektur beschrieben und werden hier nicht weiter ausgeführt.
Acht. Fazit
Wenn ich auf den gesamten Entwicklungsprozess zurückblicke, von einem einzelnen Skript zu einer Mehrprozessarchitektur, von rohem WebSocket zu einem hochverfügbaren Knotenpool, von einfachen print-Logs zu strukturiertem SQLite-Speicher, ist jeder Schritt eine Vertiefung des Verständnisses für Engineering. Die Erkundung des Packaging-Abschnitts hat mir auch klar gemacht: Nur Software stabil zum Laufen zu bringen ist der erste Schritt; den Nutzern eine einfache Handhabung zu ermöglichen, ist die eigentliche Lieferung.
Dies ist nicht nur ein Überwachungstool, sondern auch das Resultat meiner praktischen Erfahrungen in den Bereichen asynchrone Programmierung, Prozessmanagement, AI-Integration und Desktop-Softwareentwicklung.
Wenn Sie an Details zu einer der im Text erwähnten Technologien interessiert sind, besuchen Sie bitte mein GITHUB:
https://github.com/pingdj/Web3
Erhalten Sie Software und weitere technische Dokumentationen. Ich freue mich auch auf den Austausch und die Diskussion mit Ihnen auf dem Binance-Platz.
Über den Autor: Xiaonan, Full-Stack & Web3 unabhängiger Entwickler, spezialisiert auf Python-Desktop-Anwendungen, Blockchain-Datenanalyse und die Umsetzung von AI-Engineering.
