


Heute ist der 15. Dezember, und es ist unser erstes Programm nach der Pause. Viele von euch wissen wahrscheinlich, dass ich eine Woche im Krankenhaus war, weshalb wir pausiert haben. Die Zeit im Krankenhaus war ziemlich unangenehm, denn erst wenn man die Gesundheit und die Freiheit der Bewegung verliert, erkennt man die Bedeutung der Gesundheit. In einem ungesunden Zustand denkt man nicht an Geld oder andere Gedanken, und Geld hilft in vielen Fällen auch nicht bei Krankheiten, da einige Krebsarten nicht geheilt werden können, egal wie viel Geld man hat. Da wir die Bedeutung der Gesundheit erkannt haben und wir eine Gemeinschaft sind, die Handeln und Wissen vereint, sollten wir nicht nur wissen, sondern auch handeln. Wenn du die Wichtigkeit der Gesundheit erkennst, solltest du regelmäßig Pausen machen, pünktlich essen, regelmäßig Sport treiben, nicht rauchen und keinen Alkohol trinken. Handeln ist immer viel schwieriger als Wissen, wie ich in (Jeder sollte ein BTC haben) gesagt habe. Wenn du Bitcoin verstanden hast, solltest du sofort kaufen, auch wenn es nur 0,01 BTC sind. Das ist der wahre Wert von Bitcoin.
Kommen wir zum Hauptthema: Lassen Sie uns die 62. Ausgabe des Launchpool-VANA auf Binance ansehen und eine Prognose für den Preis abgeben.
Gesamtangebot der Genesis-Token: 112.641.600 VANA (93,87% der maximalen Token-Versorgung)
Maximale Token-Versorgung: 120.000.000 VANA
Die anfängliche Umlaufmenge von VANA bei der Listung auf Binance: 30.084.000 VANA (25,07% der maximalen Token-Versorgung)
Die gesamte Menge des Launchpools beträgt 4.800.000 VANA (4% der maximalen Token-Versorgung)
Einführung
Vana ist ein Netzwerk, das auf den Daten der Benutzer basiert. Vana L1 ermöglicht es den Benutzern, Daten in DataDAOs zu aggregieren und dabei Kontrolle und Privatsphäre zu wahren.
Entwickler können diese dezentralen Datensätze nutzen, um die nächste Generation von Anwendungen, wie KI-Modelle und datengetriebene dApps, zu erstellen.
Systemarchitektur
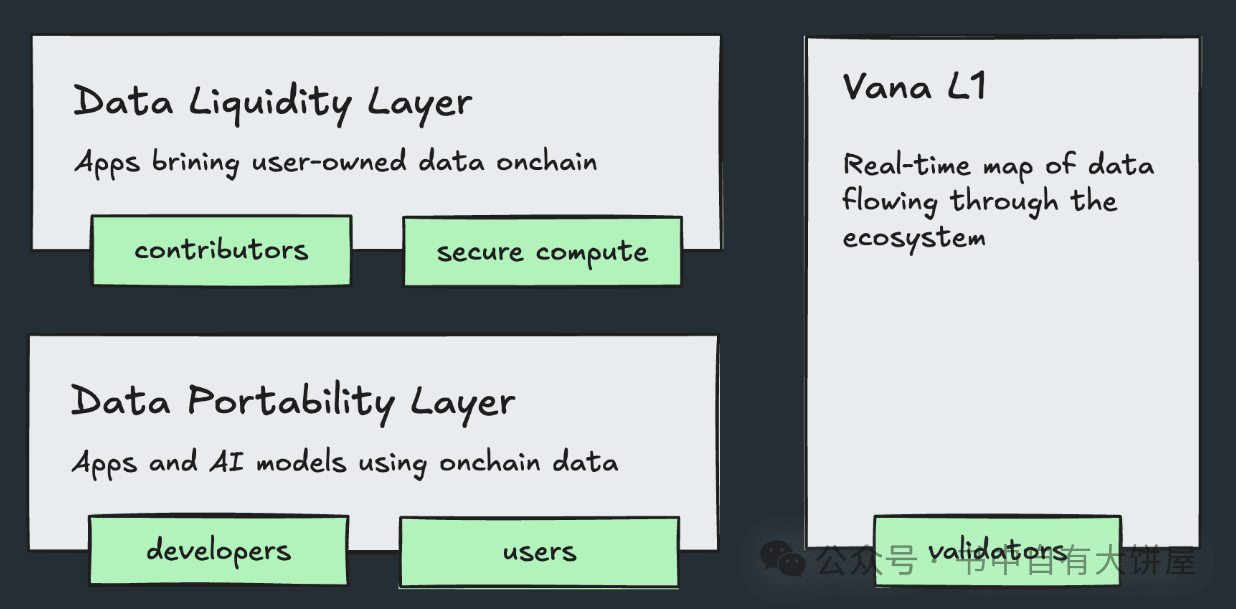
Das Netzwerk besteht aus zwei Hauptschichten, die das Eigentum an Daten, die Sicherheit und die Verfügbarkeit gewährleisten:
Datenfluss-Schicht: Die Betriebsgrundlage der Data Decentralized Autonomous Organizations (DataDAOs), die darauf abzielt, Daten on-chain zu bringen und in übertragbare digitale Vermögenswerte umzuwandeln.
Die Datenportabilitätsschicht: Unterstützt Anwendungen, die auf Benutzerdaten basieren, und ermöglicht durch validierte Daten die Benutzerhoheit.
Datenfluss-Schicht
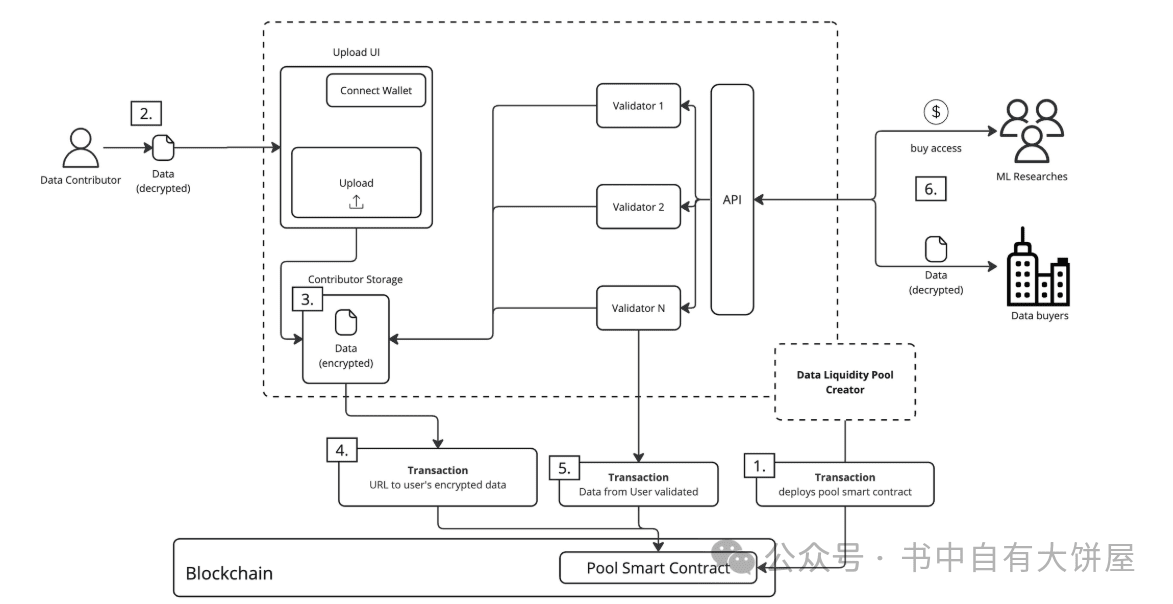
Die Datenfluss-Schicht ist die zentrale Grundlage von Vana und unterstützt die Verarbeitung von Daten als flüssigem Vermögenswert. Durch dezentrale Mechanismen können Daten in dieser Schicht sicher verifiziert, tokenisiert und gehandelt werden. Diese Schicht führt DataDAOs ein, die durch die Aggregation ähnlicher Datentypen von verschiedenen Beitragenden einen dezentralen und vertrauenslosen Datenmarkt schaffen.
Hauptfunktionen
Datenvalidierung: Die Echtheit, das Eigentum, die Qualität und die Einzigartigkeit der beitragenden Daten werden durch den Mechanismus „Proof of Contribution“ (Beweis des Beitrags, PoC) verifiziert.
Daten-Tokenisierung: Validierte Daten werden tokenisiert und für den Handel oder die Nutzung im Netzwerk bereitgestellt. Jedes DataDAO gibt seine eigenen Token aus, um Beitragende zu belohnen, die wertvolle Daten bereitstellen.
Transaktionen und Governance: DataDAO-Token ermöglichen es Benutzern, an der Daten-Governance teilzunehmen und Daten innerhalb des Vana-Ökosystems als Vermögenswerte zu handeln.
DataDAOs
DataDAOs sind der dezentrale Markt für Daten:
Datenbeitragende: Reichen Daten an DataDAOs ein und erhalten Governance-Rechte und Belohnungen.
Datenvalidierung: Erfolgt im Satya-Netzwerk (eine Gruppe sicherer Rechenknoten), um die Qualität und Integrität der Daten sicherzustellen.
Datenverbraucher: Können auf diese validierten Datensätze zugreifen, um KI-Training oder andere Zwecke zu nutzen.
DataDAOs ermutigen zur Bereitstellung hochwertiger Daten und bieten transparente Mechanismen, um die Nutzung und das Training der Daten zu gewährleisten.
Datenportabilitätsschicht
Die Datenportabilitätsschicht ist die Anwendungsebene von Vana, die den Zugriff, das Teilen und die Nutzung dezentraler Datensätze zwischen verschiedenen Plattformen und Anwendungen ermöglicht. Diese Schicht gewährleistet, dass die Daten, die den Benutzern gehören, zwischen verschiedenen Diensten und Systemen interoperabel sind und gleichzeitig die Privatsphäre und Sicherheit gewahrt bleibt. Der Charakter dieser Schicht besteht darin, dass jede DLP einen standardisierten Metadatenrahmen und Datenstruktur für ihr Gebiet definiert, um die Konsistenz und Verfügbarkeit aggregierter Datensätze sicherzustellen.
Hauptfunktionen
1. Datenfreigabe über Anwendungen hinweg
- Diese Schicht unterstützt den nahtlosen Fluss von Daten zwischen Anwendungen und gewährleistet gleichzeitig, dass die Benutzer die volle Kontrolle behalten. Benutzer können bestimmten Anwendungen den Zugriff auf ihre Daten gestatten und so ihre Privatsphäre und Sicherheit gewährleisten.
2. Interoperabilität
- Die Datenportabilitätsschicht ist mit verschiedenen Plattformen, Protokollen und Anwendungen kompatibel, damit Daten über Ökosysteme hinweg verwendet werden können. Zum Beispiel können KI-Modelle, die mit Vana dezentralisierten Datensätzen trainiert wurden, von mehreren KI-Anwendungen genutzt werden.
3. Governance und Zugriffskontrolle
- Die Datenbesitzer behalten die Kontrolle über ihre Daten, einschließlich der Entscheidung, wie und von wem die Daten genutzt werden. Darüber hinaus nehmen die Beitragenden durch den Besitz von DataDAO-Token an der Governance teil und beeinflussen die Entscheidungen zum Datenaustausch.
Dezentrale Anwendungen (dApps)
Die Datenportabilitätsschicht unterstützt dezentrale Anwendungen, die mit validierten Datensätzen interagieren:
- KI-Modelle
Entwickler können KI-Modelle erstellen, auf dezentralisierte Datensätze zugreifen und diese für das Training nutzen, um die ethische Nutzung der Daten zu gewährleisten.
- Datengetriebene Anwendungen
Anwendungen, die auf nutzergenerierten Daten basieren, können die sicheren und interoperablen Datensätze von Vana nutzen, um ein besseres Benutzererlebnis und bessere Dateninsights zu bieten.
Token-Ökonomie
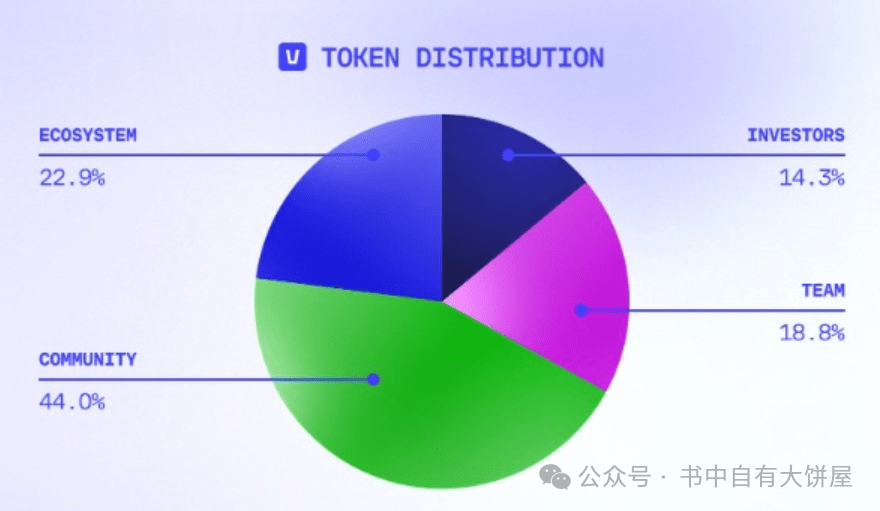
Die Gesamtmenge an Tokens beträgt 120.000.000, der anfängliche Umlauf liegt bei 25,1%. Die Token-Verteilung ist wie folgt: Kernbeitragende/Team 18,8%, Community 44%, Investoren 14,2%, Ökosystem 22,9%. Team und Investoren sind für 12 Monate gesperrt, die gesamte Tokenfreigabe erfolgt über 5 Jahre (Team). Aktuell hat das Projekt laut offizieller Webseite 20 Millionen USD an Investitionen erhalten, und die Investoren haben definitiv Gewinn gemacht, denn nach dem Investorenanteil beträgt die Marktkapitalisierung nur 140 Millionen USD.
Lassen Sie uns nun den Preis des Launchpools berechnen. Basierend auf einem Pool von 17 Millionen BNB beträgt die Rendite vergangener Launchpools etwa 1%-2%. Daher sollte der Preis zwischen 30 und 60 USD liegen (basierend auf einem BNB-Preis von 700 USD). Unter Berücksichtigung der Gesamtmenge beträgt die Marktkapitalisierung bereits zwischen 3,6 und 7,2 Milliarden USD, was bereits sehr übertrieben ist. Im Vergleich dazu haben wir zuvor eine Marktkapitalisierung von 140 Millionen USD für die Investitionen berechnet, was bereits um das 20-fache gestiegen ist.
Was sollte also der angemessene Marktwert eines KI-Datenprojekts sein? Man kann Ocean (den Marktführer für dezentrale Datenhandelsplattformen - Ocean Protocol) als Vergleich heranziehen, das ebenfalls Datenverarbeitung im Zusammenhang mit KI betreibt. Man kann sagen, dass das, was sie tun, nahezu identisch ist. Ocean fusionierte mit AGIX und FET, und vor der Fusion betrug die Marktkapitalisierung von Ocean etwa 1 Milliarde USD.
Das Team von Ocean ist sehr kompetent, und ich habe auch nachgesehen, dass das Team von Vana im Vergleich dazu erheblich hinterherhinkt. Im technischen Vergleich, da Ocean schon 2017 existierte, gab es damals tatsächlich nicht viel Erfahrung im Bereich der Datenverarbeitung und -handels. Daher war ein NFT-basiert Datenhandelsmarkt nicht ausreichend, und in dem von Vana erwähnten Problem des doppelten Ausgebens von Daten sehe ich auch keine gute Lösung, denn tatsächlich gibt es viele Schritte im Datenhandelsprozess. Wenn ich die Daten erhalte, bearbeite ich sie einmal und gebe sie dann doppelt aus, dann gibt es tatsächlich keine gute Vermeidungsstrategie. Daher ist es zwar so, dass Vana in den Verarbeitungsmethoden möglicherweise etwas fortschrittlicher ist, aber im Grunde genommen gibt es im Bereich des Daten-Trainings- und Handels keinen signifikanten Fortschritt.
Es ist jedoch unbestreitbar, dass die Schulung und Wertschöpfung persönlicher Daten der richtige Weg ist. Es gibt jedoch derzeit viele Schwierigkeiten, aber das hindert nicht eine Welle nach der anderen von Unternehmern daran, sich verschiedene Lösungen auszudenken. Manchmal kann der technische Fortschritt zu Beginn langsam sein, aber diese Ansammlung kann jederzeit einen qualitativen Wandel auslösen und die Ankunft unserer KI-Ära beschleunigen! Die Zukunft ist da!