
#web3tips
web3tips
53,788 Aufrufe
89 Kommentare
Hot
Zuletzt
Artikel
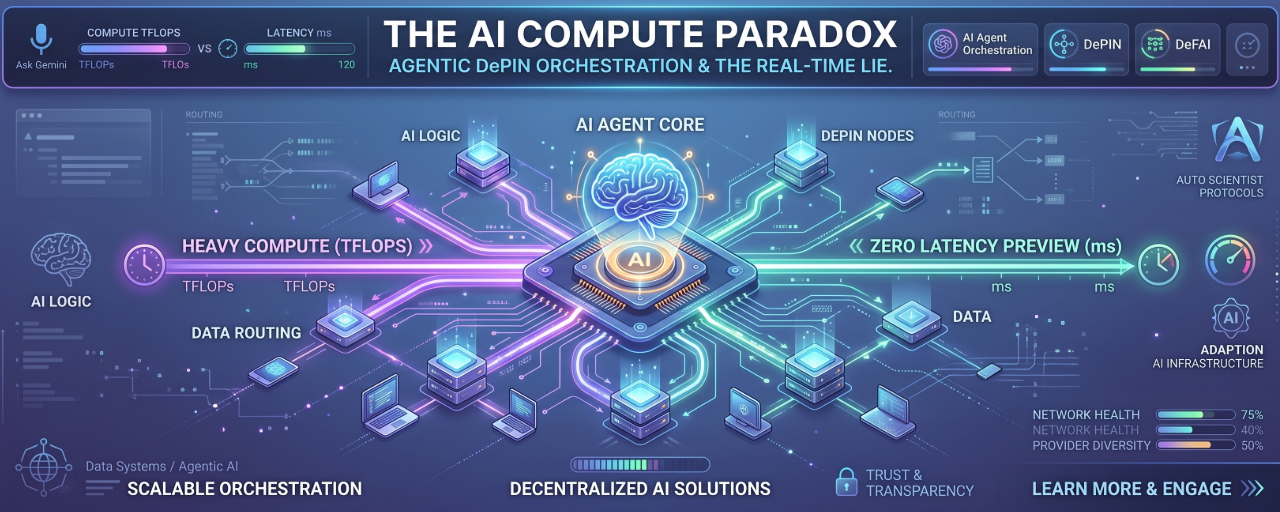
Die größte Lüge in der KI-Krypto? „Zero-Latenz bei schwerem Compute.“Jeder möchte, dass seine KI-Agenten enormes "Brainpower" und sofortige Antwortzeiten haben. Aber wenn du im Einsatz bist, kennst du das physikalische Paradox: Du kannst keinen massiven, nicht quantisierten PyTorch-Batch-Job drücken und dann Sub-50-ms-Latenz auf einem einzelnen Edge-Node erwarten.
Das Geheimnis, um KI wirklich zu skalieren, ist nicht nur, mehr zentralisierte GPUs auf das Problem zu werfen—es ist DeFAI (Dezentrale KI)-Orchestrierung über DePIN-Netzwerke.
Wenn du bei einer Ressourcen-Engstelle aufläufst, krachen die schlauesten Architekturen nicht; sie passen sich an. Indem wir KI-Agenten nutzen, die Workloads dynamisch über ein dezentrales Netzwerk routen, können wir das Widerspruchsproblem zwischen Compute und Latenz lösen.
Die größte Lüge in der KI-Krypto? „Zero-Latenz bei schwerem Compute.“
Jeder möchte, dass seine KI-Agenten enormes "Brainpower" und sofortige Antwortzeiten haben. Aber wenn du im Einsatz bist, kennst du das physikalische Paradox: Du kannst keinen massiven, nicht quantisierten PyTorch-Batch-Job drücken und dann Sub-50-ms-Latenz auf einem einzelnen Edge-Node erwarten.
Das Geheimnis, um KI wirklich zu skalieren, ist nicht nur, mehr zentralisierte GPUs auf das Problem zu werfen—es ist DeFAI (Dezentrale KI)-Orchestrierung über DePIN-Netzwerke.
Wenn du bei einer Ressourcen-Engstelle aufläufst, krachen die schlauesten Architekturen nicht; sie passen sich an. Indem wir KI-Agenten nutzen, die Workloads dynamisch über ein dezentrales Netzwerk routen, können wir das Widerspruchsproblem zwischen Compute und Latenz lösen.
Das Geheimnis, um KI wirklich zu skalieren, ist nicht nur, mehr zentralisierte GPUs auf das Problem zu werfen—es ist DeFAI (Dezentrale KI)-Orchestrierung über DePIN-Netzwerke.
Wenn du bei einer Ressourcen-Engstelle aufläufst, krachen die schlauesten Architekturen nicht; sie passen sich an. Indem wir KI-Agenten nutzen, die Workloads dynamisch über ein dezentrales Netzwerk routen, können wir das Widerspruchsproblem zwischen Compute und Latenz lösen.
65
🛡️ Vertrauen Sie nicht, überprüfen Sie: Vermeidung von gefälschten Airdrops
Wenn Airdrops zu gut erscheinen, um wahr zu sein, sind sie es wahrscheinlich.
Heutiger schneller Tipp: Überprüfen Sie immer die offiziellen Kanäle des Projekts, bevor Sie Ihre Brieftasche verbinden.
💡 Bleiben Sie sicher da draußen.
#CryptoSecurity #Web3Tips #DYOR
🛡️ Vertrauen Sie nicht, überprüfen Sie: Vermeidung von gefälschten Airdrops
Wenn Airdrops zu gut erscheinen, um wahr zu sein, sind sie es wahrscheinlich.
Heutiger schneller Tipp: Überprüfen Sie immer die offiziellen Kanäle des Projekts, bevor Sie Ihre Brieftasche verbinden.
💡 Bleiben Sie sicher da draußen.
#CryptoSecurity #Web3Tips #DYOR
Wenn Airdrops zu gut erscheinen, um wahr zu sein, sind sie es wahrscheinlich.
Heutiger schneller Tipp: Überprüfen Sie immer die offiziellen Kanäle des Projekts, bevor Sie Ihre Brieftasche verbinden.
💡 Bleiben Sie sicher da draußen.
#CryptoSecurity #Web3Tips #DYOR
92
Anmelden und weiter Inhalte entdecken
Krypto-Nutzer weltweit auf Binance Square kennenlernen
⚡️ Bleib in Sachen Krypto stets am Puls.
💬 Die weltgrößte Kryptobörse vertraut darauf.
👍 Erhalte verlässliche Einblicke von verifizierten Creators.
E-Mail-Adresse/Telefonnummer
Trendthemen
1
#HKMAPlansWholesaleCBDCByYearEnd
509 Aufrufe
62 Kommentare
2
#NEARSurges26%Past$3.45
5,880 Aufrufe
67 Kommentare
3
#BOJHikesRatesTo31YearHigh
14,665 Aufrufe
457 Kommentare
4
#ChainlinkPowersBottomlinePaymentPlatform
18,381 Aufrufe
477 Kommentare
5
#DtcpayCompletes$25MSeriesA
352 Aufrufe
21 Kommentare
6
#InjectiveLaunchesINJOnSolana
1,478 Aufrufe
78 Kommentare
7
#StellarActivatesProtocol28At211TPS
25,836 Aufrufe
596 Kommentare
8
#SECGrantsInnovationExemptionForTokenizedStocks
21,688 Aufrufe
462 Kommentare
9
#XRPGains3%AsRippleAddsMPPSupport
19,626 Aufrufe
360 Kommentare
10
#SPGlobalToAcquireOpenZeppelin
10,884 Aufrufe
225 Kommentare