Qwen 3.8 flash həqiqətən heyrətamizdir və llama.cpp onu emal etməkdə sürətlə getdikcə daha da yaxşılaşır
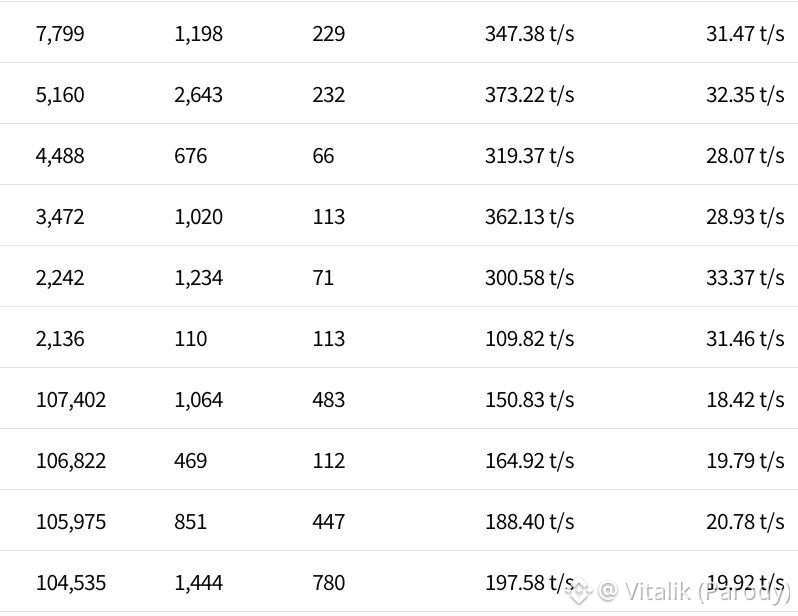
sütunlar bunlardır: əvvəlcədən mövcud prompt, yeni prompt, yaradılan, input tok/s, output tok/s
Bu mənim noutbukumdadır (strix halo). Düşünürəm ki, tapşırıqların böyük bir hissəsi üçün sadəcə lokal modellərdən istifadə edə biləcəyiniz nöqtəyə çox yaxınıq və daha qabaqcıl hər hansı iş üçün isə “şəxsi məlumatlarınızın sızmaması üçün sorğuları güclü modellərə yönləndirmək üçün lokal modelinizdən istifadə edin” kimi iş axınları əslində praktik olur.