我最近重新理解了 KGeN:AI 可能真的缺的不是更多数据》
最近研究 KGeN,我最大的一个感受是:
AI的数据越多,“数据是不是真的来自人”反而可能越重要。
以前看到 AI 项目讲数据,我基本不会停留太久。毕竟现在网上什么数据都有。
但问题也恰恰在这里。
AI 生成的文章、图片、声音越来越多,机器人账号也越来越普遍。以后如果 AI 大量学习这些已经被 AI 生成过的内容,会不会出现一个循环?
AI生成 → AI学习 → 再生成 → 再训练AI。
数量越来越大,但真实的人类经验反而可能越来越少。
这也是我开始认真看 KGeN 的原因。
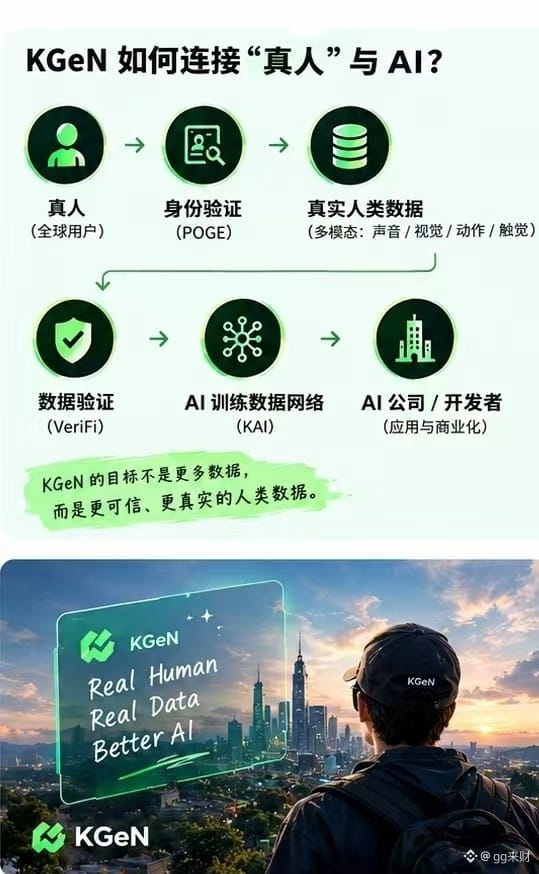
KGeN 目前把自己定位成 Verified Human Network,核心方向是获取经过验证的真实人类、多模态数据,用于 Physical AI 和 LLM。官方提到的数据类型包括声音、视觉、动作和触觉,并覆盖 60+ 个国家。
我觉得这里最值得思考的并不是“AI”这个热门概念,而是:
如果未来 AI 要真正理解现实世界,它是不是必须先理解真实的人类?
比如一个机器人要学会生活在真实环境里,单纯看互联网图片可能远远不够。
它需要知道人怎么说话、怎么行动、怎么观察环境,甚至人在不同场景下会做出什么反应。
这时候,真实的人类数据就不再只是数据量的问题,而是数据来源和质量的问题。
KGeN 现在的思路,就是把真人、验证、多模态数据和 AI 训练需求连接起来。其产品体系里也包括 K-Quest,用经过验证的人类完成任务来采集 Physical AI 和 LLM 所需要的多模态数据。
当然,我不会现在就说 KGeN 一定会成功。
对我来说,更值得继续观察的是:
真实用户能不能持续增长?
数据需求能不能持续产生?
这些数据能不能真正被 AI 公司使用?
最后能不能形成长期的商业闭环?
这些问题,比单纯看短期价格有意思得多。
这个答案,我还在继续观察
#KGen
最近研究 KGeN,我最大的一个感受是:
AI的数据越多,“数据是不是真的来自人”反而可能越重要。
以前看到 AI 项目讲数据,我基本不会停留太久。毕竟现在网上什么数据都有。
但问题也恰恰在这里。
AI 生成的文章、图片、声音越来越多,机器人账号也越来越普遍。以后如果 AI 大量学习这些已经被 AI 生成过的内容,会不会出现一个循环?
AI生成 → AI学习 → 再生成 → 再训练AI。
数量越来越大,但真实的人类经验反而可能越来越少。
这也是我开始认真看 KGeN 的原因。
KGeN 目前把自己定位成 Verified Human Network,核心方向是获取经过验证的真实人类、多模态数据,用于 Physical AI 和 LLM。官方提到的数据类型包括声音、视觉、动作和触觉,并覆盖 60+ 个国家。
我觉得这里最值得思考的并不是“AI”这个热门概念,而是:
如果未来 AI 要真正理解现实世界,它是不是必须先理解真实的人类?
比如一个机器人要学会生活在真实环境里,单纯看互联网图片可能远远不够。
它需要知道人怎么说话、怎么行动、怎么观察环境,甚至人在不同场景下会做出什么反应。
这时候,真实的人类数据就不再只是数据量的问题,而是数据来源和质量的问题。
KGeN 现在的思路,就是把真人、验证、多模态数据和 AI 训练需求连接起来。其产品体系里也包括 K-Quest,用经过验证的人类完成任务来采集 Physical AI 和 LLM 所需要的多模态数据。
当然,我不会现在就说 KGeN 一定会成功。
对我来说,更值得继续观察的是:
真实用户能不能持续增长?
数据需求能不能持续产生?
这些数据能不能真正被 AI 公司使用?
最后能不能形成长期的商业闭环?
这些问题,比单纯看短期价格有意思得多。
这个答案,我还在继续观察
#KGen