


أبرز النقاط
في Binance، نستخدم تعلم الآلة (ML) لحل مجموعة متنوعة من مشكلات الأعمال، بما في ذلك على سبيل المثال لا الحصر: احتيال الاستيلاء على الحساب (ATO)، واحتيال P2P، وتفاصيل الدفع المسروقة.
باستخدام عمليات تعلم الآلة (MLOps)، قام علماء بيانات Binance Risk AI ببناء خط أنابيب متكامل لتعلم الآلة يعمل في الوقت الفعلي، ويقوم باستمرار بتقديم خدمات تعلم آلي جاهزة للإنتاج.

لماذا نستخدم MLOps؟
لبدء، فإن إنشاء خدمة تعلم آلي هو عملية تكرارية. يقوم علماء البيانات باستمرار بإجراء تجارب لتحسين مقياس محدد، سواءً بشكل غير متصل أو عبر الإنترنت، وذلك استنادًا إلى الهدف المتمثل في تقديم قيمة للأعمال. إذًا كيف يمكننا تمكين هذه العملية لتكون أكثر كفاءة — على سبيل المثال، تقليل وقت طرح نموذج تعلم الآلة إلى السوق (time-to-market)؟
ثانيًا، يتأثر سلوك خدمات تعلم الآلة ليس فقط بالكود الذي نحدده نحن المطورون، بل أيضًا بالبيانات التي تجمعها. تُعرَف هذه الفكرة أيضًا باسم انحراف المفهوم (concept drift)، وهي مُمَزَّة في ورقة Google المعنونة Hidden Technical Debt in Machine Learning Systems.
خذ الاحتيال كمثال؛ فالمحتال ليس مجرد آلة بل إنسان يتكيّف ويغيّر باستمرار طريقة هجومه. وبهذا، ستتطور مجموعة البيانات الأساسية لتُحاكي التغييرات في مسارات الهجوم. كيف يمكننا ضمان أن النموذج في بيئة الإنتاج يأخذ أحدث نمط بيانات في الحسبان بشكل فعّال؟
للتغلب على التحديات المذكورة أعلاه، نستخدم مفهومًا يُسمى MLOps، وهو مصطلح اقترحته Google في البداية عام 2018. في MLOps، نركز على أداء النموذج والبنية التحتية الداعمة للنظام في الإنتاج. وهذا يمكّننا من بناء خدمات تعلم آلي قابلة للتوسع، وعالية التوفر، وموثوقة، وقابلة للصيانة.
تفصيل خط أنابيب تعلم الآلة المتكامل في الوقت الحقيقي
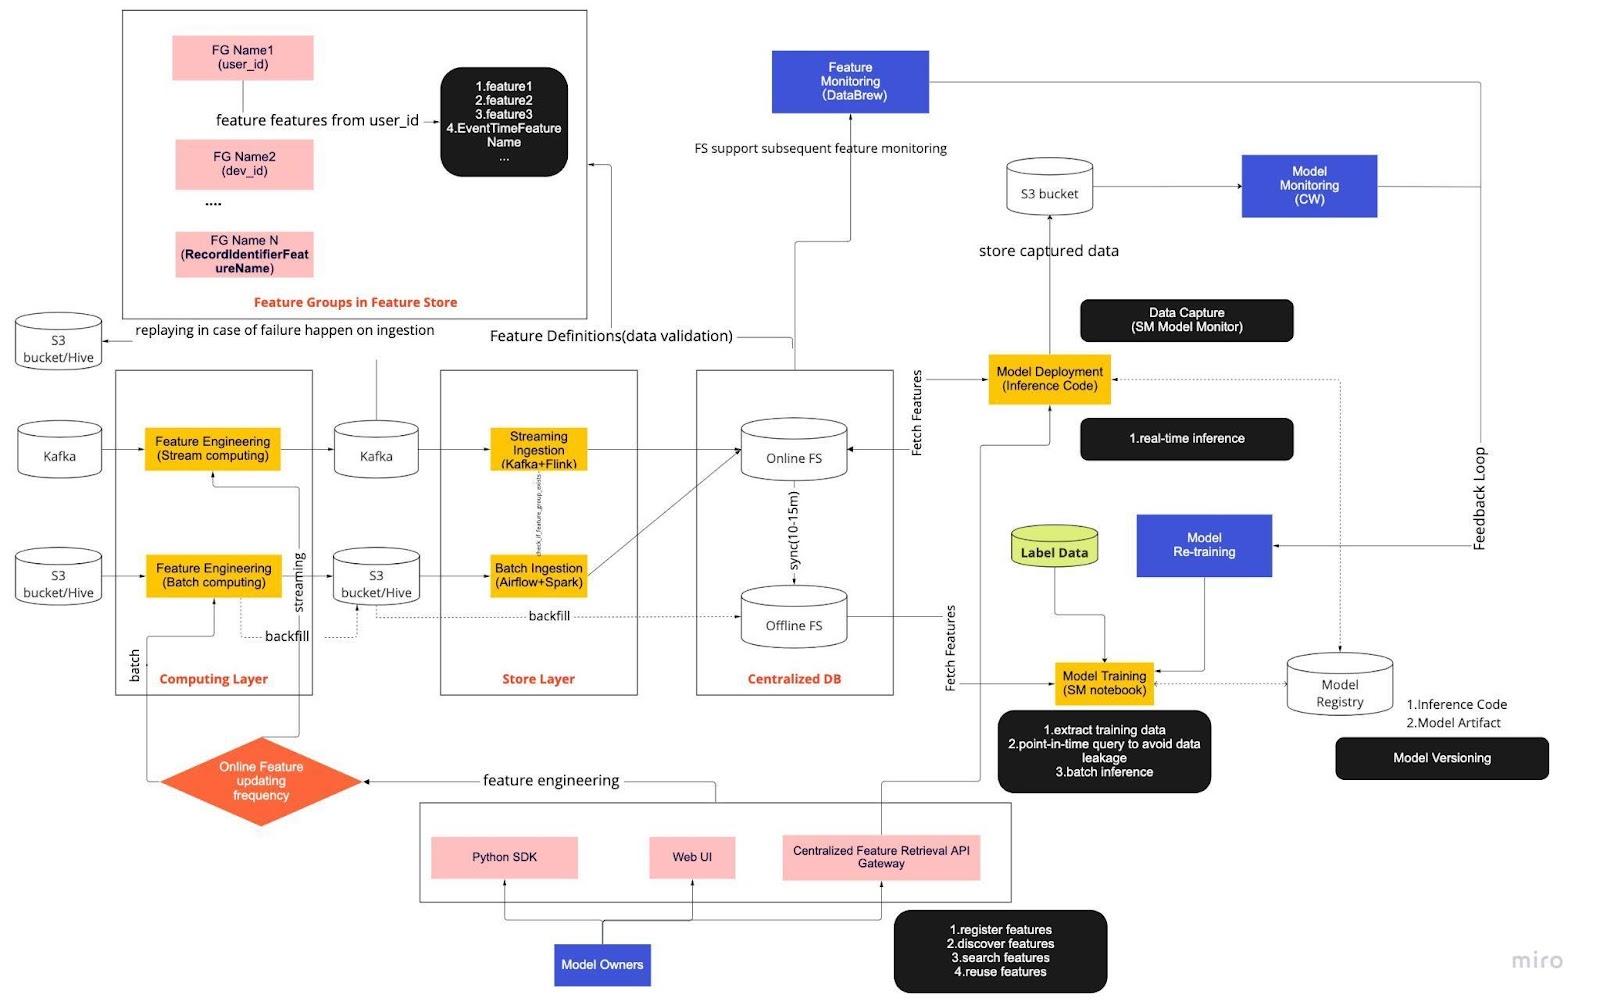
اعتبر المخطط أعلاه بمثابة إجراء التشغيل القياسي (SOP) الخاص بنا لتطوير نموذج تعلم آلي في الوقت الحقيقي مع مخزن الميزات. يحدد خط الأنابيب المتكامل من البداية إلى النهاية كيف يطبق فريقنا MLOps، وهو مبني على نوعين من المتطلبات: وظيفية وغير وظيفية.
وظيفية
معالجة البيانات
تدريب النموذج
تطوير النموذج
نشر النموذج
المراقبة
متطلبات غير وظيفية
قابل للتوسع
عالي التوفر
موثوق
قابل للصيانة
يتم تقسيم خط الأنابيب كذلك إلى ستة مكونات رئيسية:
طبقة الحوسبة
طبقة التخزين
قاعدة البيانات المركزية
تدريب النموذج
نشر النموذج
مراقبة النموذج
1. طبقة الحوسبة

تُعَد طبقة الحوسبة مسؤولة بشكل أساسي عن هندسة الميزات، وهي عملية تحويل البيانات الخام إلى ميزات مفيدة.
نُصنِّف طبقة الحوسبة إلى نوعين بناءً على وتيرة التحديث: الحوسبة البثّية لتحديثات بفواصل زمنية دقيقة/ثانية، والحوسبة الدفعية لتحديثات بفواصل يومية/ساعة.
عادةً ما تأتي بيانات إدخال طبقة الحوسبة من قاعدة البيانات المعتمدة على الأحداث، والتي تشمل Apache Kafka وKinesis، أو من قاعدة بيانات OLAP، والتي تشمل Apache Hive للحلول مفتوحة المصدر وSnowflake للحلول السحابية.
2. طبقة التخزين
تُعَد طبقة التخزين المكان الذي نسجّل فيه تعريفات الميزات، ونقوم بنشرها في مخزن الميزات لدينا، كما تنفّذ عمليات backfill، وهي عملية تُمكّننا من إعادة بناء الميزات باستخدام البيانات التاريخية كلما تم تعريف ميزة جديدة. عادةً ما تكون backfill مهمة لمرة واحدة يمكن لعلماء البيانات تنفيذها في بيئة دفتر (notebook). وبما أن Kafka لا يمكنه تخزين الأحداث إلا لمدة سبعة أيام الأخيرة، فإنه يستخدم آلية نسخ احتياطي إلى جدول s3/hive لزيادة تحمل الأعطال.
ستلاحظ أن الطبقة الوسيطة، Hive وKafka، موجودة بشكل مقصود بين طبقتي الحوسبة والتخزين. تخيّل هذا الترتيب كونه عازلًا بين الحوسبة وكتابة الميزات. يمكن تشبيه ذلك بفصل المُنتِج عن المُستهلِك. فالحوسبة البثّية هي المُنتِج، بينما إدخال البث هو المُستهلِك.
إن فصل الحوسبة عن الإدخال يوفر مجموعة متنوعة من الفوائد لخطوط تعلم الآلة لدينا. أولًا، يمكننا زيادة متانة خط الأنابيب في حال حدوث أعطال. ما زال بإمكان علماء البيانات سحب قيمة الميزات من قاعدة البيانات المركزية، حتى إذا كانت طبقة الإدخال أو طبقة الحوسبة غير متاحة بسبب مشكلات تشغيلية أو أعطال في الأجهزة أو مشاكل في الشبكة.
علاوة على ذلك، يمكننا توسيع نطاق أجزاء مختلفة من البنية التحتية بشكل مستقل وتقليل الطاقة اللازمة لبناء خط الأنابيب وتشغيله. على سبيل المثال، إذا تعطل الأمر لأي سبب، فلن تمنع طبقة الإدخال طبقة الحوسبة. ومن ناحية الابتكار، يمكننا التجربة واعتماد تقنيات جديدة، مثل إصدار جديد لتطبيق Flink، دون التأثير في البنية التحتية الحالية لدينا.

تُعد كل من طبقة الحوسبة وطبقة التخزين ما نطلق عليه اسم خطوط أنابيب الميزات الآلية. تكون هذه الخطوط مستقلة، وتعمل بجدولات مختلفة، وتنقسم إلى خطوط بثّية أو دفعية. إليك كيفية عمل الخطّين بشكل مختلف: قد تُحدِّث مجموعة ميزات واحدة في خط دفعية كل ليلة، بينما يتم تحديث مجموعة أخرى كل ساعة. في خط بثّي، تُحدَّث مجموعة الميزات في الوقت الحقيقي مع وصول بيانات المصدر إلى تيار إدخال، مثل موضوع Apache Kafka.
3. قاعدة بيانات مركزية
تُعَد طبقة قاعدة البيانات المركزية المكان الذي يعرض فيه علماء البيانات لدينا بياناتهم الجاهزة للميزات إلى مخزن ميزات عبر الإنترنت (online) أو دون اتصال (offline).
يتميز مخزن الميزات عبر الإنترنت بكونه منخفض زمن الاستجابة وعالي التوفر، ما يتيح البحث في السجلات في الوقت الحقيقي. من ناحية أخرى، يوفر مخزن الميزات دون اتصال مستودعًا آمنًا وقابلًا للتوسع لجميع بيانات الميزات. وهذا يتيح للباحثين إنشاء مجموعات بيانات للتدريب أو التحقق أو التقييم الدفعي انطلاقًا من مجموعة من مجموعات الميزات المُدارة مركزيًا، مع سجل كامل لقيم الميزات التاريخية في نظام تخزين الكائنات.
تقوم كلا مخزني الميزات تلقائيًا بالمزامنة معًا كل 10-15 دقيقة لتجنب انحراف التدريب-الخدمة. وفي مقال مستقبلي، سنقوم بإجراء تحليل معمق لكيفية استخدام مخازن الميزات داخل الخطوط.
4. تدريب النموذج
تُعَد طبقة تدريب النموذج المكان الذي يستخرج فيه علماء البيانات بيانات التدريب من مخزن الميزات دون اتصال لضبط خدمات تعلم الآلة (ML) لدينا بشكل أدق (finetune). نستخدم استعلامات بنقطة زمنية محددة (point-in-time) لمنع تسرب البيانات أثناء عملية الاستخراج.
بالإضافة إلى ذلك، تتضمن هذه الطبقة عنصرًا حاسمًا يُعرف باسم حلقة تعليقات لإعادة تدريب النموذج. تُقلّل إعادة تدريب النموذج من خطر انحراف المفهوم (concept drift) من خلال ضمان أن النماذج المُنشرَة تعكس بدقة أحدث أنماط البيانات — على سبيل المثال، قيام مهاجم بتغيير سلوك هجومه.
5. نشر النموذج
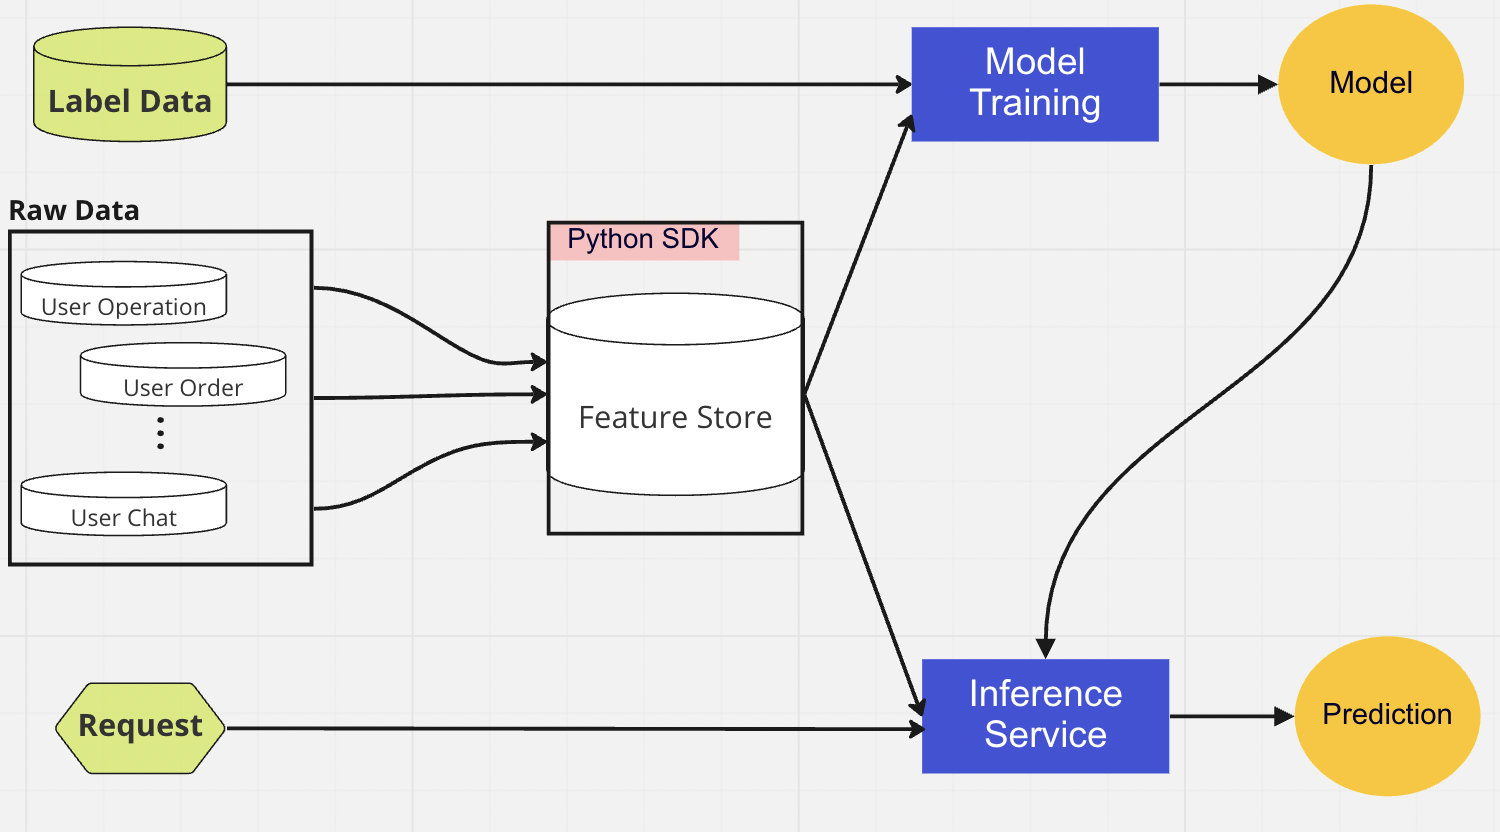
فيما يتعلق بنشر النموذج، نستخدم بشكل أساسي خدمة تسجيل/تقييم مبنية على السحابة باعتبارها العمود الفقري لخدمة تقديم البيانات في الوقت الحقيقي. إليك مخططًا يوضح كيف يتكامل كود الاستدلال الحالي مع مخزن الميزات.

6. مراقبة النموذج
في هذه الطبقة، يقوم فريقنا بمراقبة مؤشرات استخدام خدمات التسجيل مثل QPS وزمن الاستجابة والذاكرة ومعدل استخدام وحدة المعالجة المركزية/وحدة معالجة الرسوم (CPU/GPU). بالإضافة إلى هذه المؤشرات الأساسية، نستخدم البيانات المُلتقطة للتحقق من توزيع الميزات عبر الزمن، وانحراف التدريب-الخدمة، وانحراف التنبؤ لضمان حد أدنى من انحراف المفهوم.
أفكار ختامية
لخّصًا، إن تقسيم بنية خط الأنابيب لدينا بشكل غير محكم إلى طبقة حوسبة وطبقة تخزين وقاعدة بيانات مركزية يمنحنا ثلاث فوائد رئيسية مقارنةً ببنية مترابطة بشكل أكبر.
خطوط أنابيب أكثر متانة في حال الأعطال
مرونة أكبر عند اختيار الأدوات لتنفيذها
مكونات قابلة للتوسع بشكل مستقل
هل ترغب في استخدام تعلم الآلة لحماية أكبر منظومة عملات رقمية في العالم ومستخدميها؟ اطلع على Binance Engineering/AI في صفحة الوظائف لدينا للحصول على إعلانات شواغر مفتوحة.