


2024.03.14
项目介绍
Grass于去年六月推出,其构建了一个去中心化的网络抓取网络,重点是将公共网络数据转化为人工智能数据集。该网络是一个由用户拥有和运营的网络,也是任何人接触AI的最简单的方式。每个人都可以快速地建立自己的Grass节点,具体可以看看鹅鹅之前发的教程,手机也可以撸!
目前在Whales上场外已经达到了4.6U/一千分的价格,单台设备IP在75%的网络情况下,一个月大概可以挖50000分,也就是240U。好久之前鹅鹅让你们挖结果好多人都在偷懒没挖,现在告诉你一个月开着电脑或者手机就能挖240u,只要你过年去亲戚朋友家多挂几台,就是好几个240u,有没有一点点后悔啊!后悔了就快来补作业啊!!
目前Grass计划在SOL上推出首个Layer 2 数据 Rollup,鹅鹅特地分成了太长不看版本和官方文章版本,供小伙伴阅读理解。
太长不看
Grass在提出这次计划之前仅仅有着DEPIN加AI概念,然而现在它却计划建立属于自己的AI公链。这就意味着,Grass扩展到了另外一个与之前完全不同的业务模式,从之前帮助AI企业清洗数据的单纯业务增加了数据分类账功能和ZK处理器功能。一但Layer 2搭建完成,它的概念将变成SOL+DEPIN+AI+首个数据Rollup概念,四重概念叠加起来,具体有多大的含金量我就不说了,小伙伴还不赶紧来挖?
电脑版教程:
https://weibo.com/ttarticle/p/show?id=2309404997006383775962
手机版教程:
https://weibo.com/ttarticle/p/show?id=2309404998038614573232
正片
Grass:史上首个 Layer 2 数据 Rollup
在过去几周中,我们发布了一些内容,以解释 Grass 在 AI 堆栈中的角色。现在,您已经了解到,该协议执行了许多功能,以帮助构建者访问网络数据,用于训练其模型。这是 AI 流程的关键第一阶段,也是所有开发的起点。
在 Grass 的情况下,一组节点托管在居民设备上,从网络中抓取和处理原始数据。它清洁并转换数据为结构化数据集,以供 AI 训练使用。最重要的是,它以一种涉及并奖励全球近百万人参与的方式获取网络数据。它单独创建了 AI 数据提供的类别,并且这也是全球一些最大的 AI 公司选择与我们合作的原因。它就是 AI 的数据层。
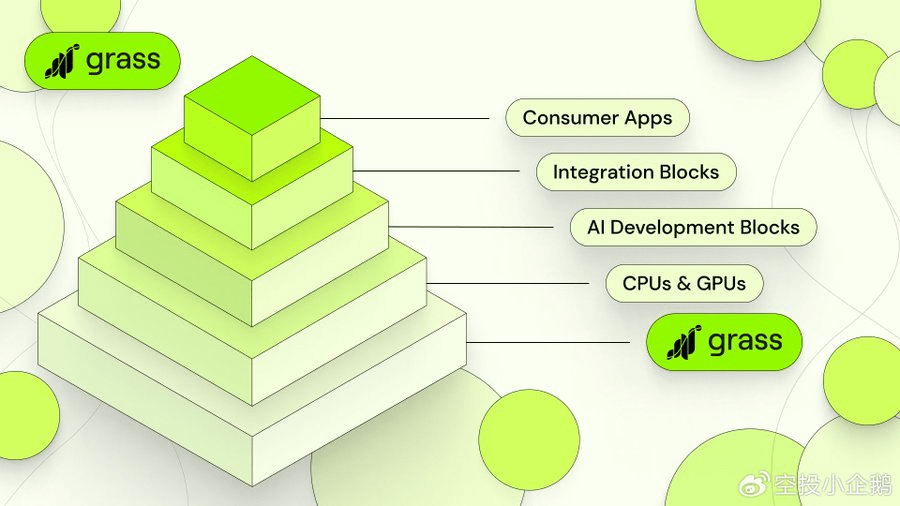
与此同时,我们过去几周还一直在思考人工智能的当前状态。我们问自己最紧迫的问题是什么,作为 AI 基础设施的一个重要组成部分,我们能做些什么来解决这些问题。
我们的结论是,当前 AI 面临的最大问题是缺乏数据透明度。看看新闻就会明白。问问自己,为什么一个 AI 模型会将埃隆·马斯克与希特勒相提并论?或者从世界历史中抹去整个族群?是训练时使用了错误的数据吗?或者更糟的是,使用了有选择性地选择给出错误答案的好数据?
答案是,我们不知道。而且我们不知道是因为没有办法知道。我们不知道这些模型是训练在什么数据上的,因为没有机制来证明它。没有办法让用户验证数据的来源,因为没有办法让建造者自己验证它。
这就是 Grass 计划要解决的问题,而我们现在正在建立一个 Layer 2 数据 Rollup 来解决这个问题。您可能会问,如何做到的?
请允许我们解释一下。
Layer Two 如何建立数据来源
世界需要一种证明 AI 训练数据来源的方法,这就是 Grass 现在正在构建的。很快,每次由 Grass 节点抓取的数据,都将记录元数据以验证抓取数据的网站。然后,这些元数据将永久嵌入到每个数据集中,使建造者能够完全确定其来源。然后,他们可以与用户分享这个谱系,用户可以放心,与之交互的 AI 模型没有被故意训练出误导性答案。
这是一项重大的工作,并且需要对我们的协议进行主要扩展,以准备将抓取操作扩展到每分钟数千万个网络请求。每个请求都需要验证,这将比任何 L1 可以提供的吞吐量还要大。这就是为什么我们宣布计划建立一个 Layer 2 解决方案来处理我们能力的重大升级。该 L2 将是一个主权 Rollup,配备了 ZK 处理器,以便可以批处理元数据进行验证,并用于为我们产生的每个数据集提供持久的谱系。这是使所有 AI 开发的基础层能够进入下一阶段所必需的。
这样做的好处很多:它将抵御数据污染,赋予开源 AI 能力,并为我们每天与之交互的模型提供透明性。
接下来,我们将描述系统的基本设计。
Grass 的架构
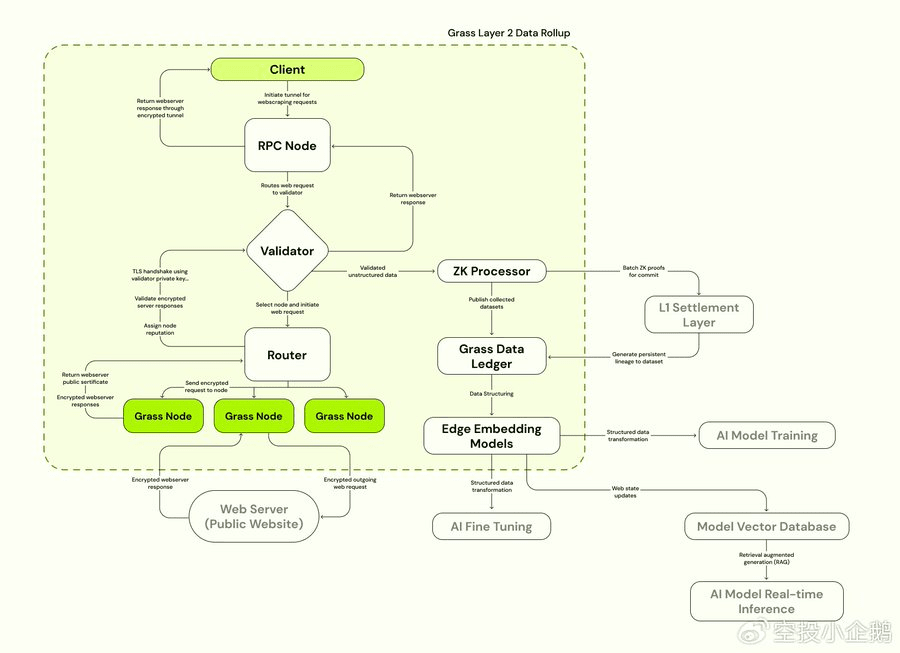
理解这些升级的最简单方法是查看 Grass 数据 Rollup 的图表。在左边,在客户端和 Web 服务器之间,您会看到 Grass 的网络,就像传统定义的那样。客户端发出网络请求,通过验证器,最终通过 Grass 节点进行路由。客户端请求的网站的服务器将响应网络请求,允许其数据被抓取并发送回线路。然后,数据将被清理、处理,并准备用于训练下一代 AI 模型。
在 L2 图表中,您将看到右侧有两个主要的附加部分,这将随着 Grass 的主权Layer 2的推出而加入:Grass 数据分类账和 ZK 处理器。
这两者各自都有自己的功能,所以我们将逐一解释它们。
Grass数据分类账
数据分类账是Grass上所有数据的最终存储地。它是每个在Grass上抓取的数据集的永久分类账,现在嵌入了元数据以记录其从起源时刻的血统。每个数据集的元数据证明将存储在 Solana 的结算层上,结算数据本身也将通过分类账可供访问。Grass有一个存储其抓取的数据的地方的重要性需要注意,尽管我们很快就会谈到这一点。
ZK 处理器
正如我们上面所描述的,ZK 处理器的目的是协助记录在Grass网络上抓取的数据集的来源。想象一下这个过程。
当网络上的一个节点 - 换句话说,使用Grass扩展功能的用户 - 向给定网站发送网络请求时,它会返回一个加密响应,其中包含节点请求的所有数据。对于所有目的而言,这就是我们的数据集诞生的时刻,也是需要记录的起源时刻。
而这正是我们记录元数据时捕捉到的时刻。它包含许多字段 - 会话密钥、抓取的网站的 URL、目标网站的 IP 地址、交易的时间戳,当然还有数据本身。这是所有必要的信息,可以毫无疑问地知道特定数据集来自它所声称的网站,因此特定的 AI 模型是正确地 - 且忠实地 - 训练的。
ZK 处理器的作用是因为这些数据需要在链上结算,但我们不希望所有这些数据对 Solana 验证者都可见。而且,将来在Grass上执行的网络请求的数量之庞大将不可避免地超出任何 L1 的吞吐能力 - 即使是像 Solana 这样功能强大的 L1。Grass将很快扩展到每分钟执行数千万个网络请求的程度,每一个请求的元数据都需要在链上结算。没有 ZK 处理器制作证明并首先将它们批处理,我们不可能将这些交易提交到 L1。因此,L2 -是实现我们设定目标的唯一可能方式。
现在,为什么这是一个大问题?
Layer 2的好处
数据分类账
数据分类账的重要性在于它将Grass的扩展提升到另一个 - 也是根本不同的 - 业务模式。虽然协议将继续审查发送自己网络请求并在网络上抓取自己数据的买家,但其活动的日益增长的一部分将涉及已存储在分类账上的数据。有了这种能力,Grass现在可以策略性地抓取用于 LLM 训练的数据,并将其托管在一个不断扩大的数据存储库中。
这个存储库是模块化 AI 堆栈的数据层,构建者可以从中挑选出组成部分来训练无限不同的模型。它本质上是互联网的微缩模型,提供已经结构化且准备好供 AI 摄取的训练数据。
ZK 处理器
我们已经详细介绍了为什么 ZK 处理器很重要。通过使我们能够创建记录Grass数据集来源的元数据的证明,它为建造者和用户验证 AI 模型是否实际上正确训练提供了一种机制。这本身就是一件大事。
然而,有一件事我们之前没有提到。
除了记录数据集来源的网站外,元数据还指示了数据集在网络上经过的节点。显著的是,这意味着每当一个节点抓取网络时,他们可以获得他们的工作的信用,而不泄露任何关于自己的身份信息。
现在,为什么这很重要?
这很重要,因为一旦你可以证明哪些节点完成了哪些工作,你就可以开始按比例奖励他们。有些节点比其他节点更有价值。有些节点比他们的同行抓取更多的数据。而这些恰恰是我们需要激励的节点,以继续过去几个月我们所见的网络的迅速扩张。我们相信这种机制将显著提高对全球最需求地区的奖励,最终鼓励这些地方的人们注册并指数级地增加网络的容量。
不用说,网络越大,我们抓取的能力就越大,我们存储的网络数据存储库也就越大。一个正反馈循环将不可避免地产生,更多的数据意味着我们将有更多可以提供给需要训练数据的 AI 实验室 - 从而为网络持续增长提供激励。
结论
总的来说,当今人工智能领域的大多数突出问题都源于对模型训练方式缺乏可见性,我们相信这可以通过为开源人工智能赋予验证数据来源的系统来解决。我们的解决方案是构建史上首个Layer 2数据rollup,这将使得引入记录所有数据集来源的元数据的机制成为可能。
这些数据的ZK证明将存储在L1结算层上,而元数据本身最终将与其基础数据集相关联,因为这些数据集本身存储在我们自己的数据分类账上。Grass为模块化人工智能堆栈提供了数据层,这些发展将为节点提供者带来更大的透明度和奖励,这些奖励与他们执行的工作量成比例。
这次更新应该有助于传达我们即将推出的一些项目,并澄清推动我们决策的思路。我们很高兴能在让人工智能更加透明的过程中发挥作用,并且对未来我们产品可能出现的许多应用场景感到兴奋。这些升级将为开发者们打开广阔的机会,所以如果您或您的团队有兴趣在Grass上构建,请在Discord上联系我们。感谢您的支持,请继续关注。
在人工智能革命中获得一份利益。