


الوجبات السريعة الرئيسية
تستفيد Binance من إدارة السعة لمواجهة الزيادات غير المخطط لها في حركة المرور الناتجة عن التقلبات العالية، مما يضمن بنية تحتية كافية وفي الوقت المناسب وموارد حوسبة لمتطلبات الأعمال.
اختبارات تحميل Binance في بيئة الإنتاج (بدلاً من بيئة التدريج) للحصول على معايير خدمة دقيقة. تساعد هذه الطريقة في التحقق من أن تخصيص الموارد لدينا كافٍ لخدمة حمل محدد.
تتعامل البنية التحتية لـ Binance مع كميات كبيرة من حركة المرور، ويتطلب الحفاظ على الخدمة التي يمكن للمستخدمين الاعتماد عليها إدارة مناسبة للسعة واختبار التحميل التلقائي.

لماذا تحتاج Binance إلى عملية متخصصة لإدارة السعة؟
تُعد إدارة السعة دعامة أساسية لاستقرار النظام. فهي تتضمن ضبط حجم موارد التطبيقات والبنية التحتية لتكون مناسبة للاحتياجات الحالية والمستقبلية للأعمال وبالتكلفة الصحيحة. وللمساعدة في تحقيق هذا الهدف، نبني أدوات وخطوط معالجة لإدارة السعة لتجنب التعطّل ومساعدة الأعمال على تقديم تجربة مستخدم سلسة.
تتعامل أسواق العملات المشفرة غالبًا مع فترات أكثر انتظامًا من التقلب مقارنة بالأسواق المالية التقليدية. وهذا يعني أن نظام Binance يجب أن يكون قادرًا على تحمل اندفاع حركة المرور من وقت لآخر عندما يتفاعل المستخدمون مع تحركات السوق. ومع إدارة السعة بشكل صحيح، نحافظ على السعة كافية لطلب الأعمال العام، بما في ذلك سيناريوهات اندفاع حركة المرور هذه. هذه النقطة الجوهرية بالضبط هي ما يجعل عمليات إدارة السعة لدى Binance فريدة ومليئة بالتحديات.
لنلقِ نظرة على العوامل التي غالبًا ما تعيق العملية وتؤدي إلى خدمة بطيئة أو غير متاحة. أولاً، لدينا حمل زائد (overload)، وغالبًا ما يحدث بسبب زيادة مفاجئة في حركة المرور. على سبيل المثال، قد ينتج ذلك عن حدث تسويقي أو إشعار دفع (push notification) أو حتى هجوم DDoS (هجوم حجب الخدمة الموزع).
تؤثر حركة المرور الاندفاعية (Surge traffic) وعدم كفاية السعة على وظائف النظام كما يلي:
تتولى الخدمة المزيد والمزيد من العمل.
تزداد مدة الاستجابة إلى الحد الذي لا يمكن فيه لأي طلب أن يتمتّع باستجابة ضمن مهلة/timeout الخاصة بالعميل. يحدث هذا التدهور عادةً بسبب تشبع الموارد (CPU، الذاكرة، IO، الشبكة، إلخ.) أو بسبب توقفات GC المطولة (لفترات توقف جمع القمامة) داخل الخدمة نفسها أو تبعياتها.
النتيجة هي أن الخدمة لن تكون قادرة على معالجة الطلبات بسرعة وبشكل مناسب.
تفكيك العملية
الآن بعد أن ناقشنا المبدأ العام لإدارة السعة، دعونا نرى كيف تطبق Binance ذلك على أعمالها. إليكم نظرة سريعة على بنية نظام إدارة السعة لدينا مع بعض سير العمل الرئيسية.
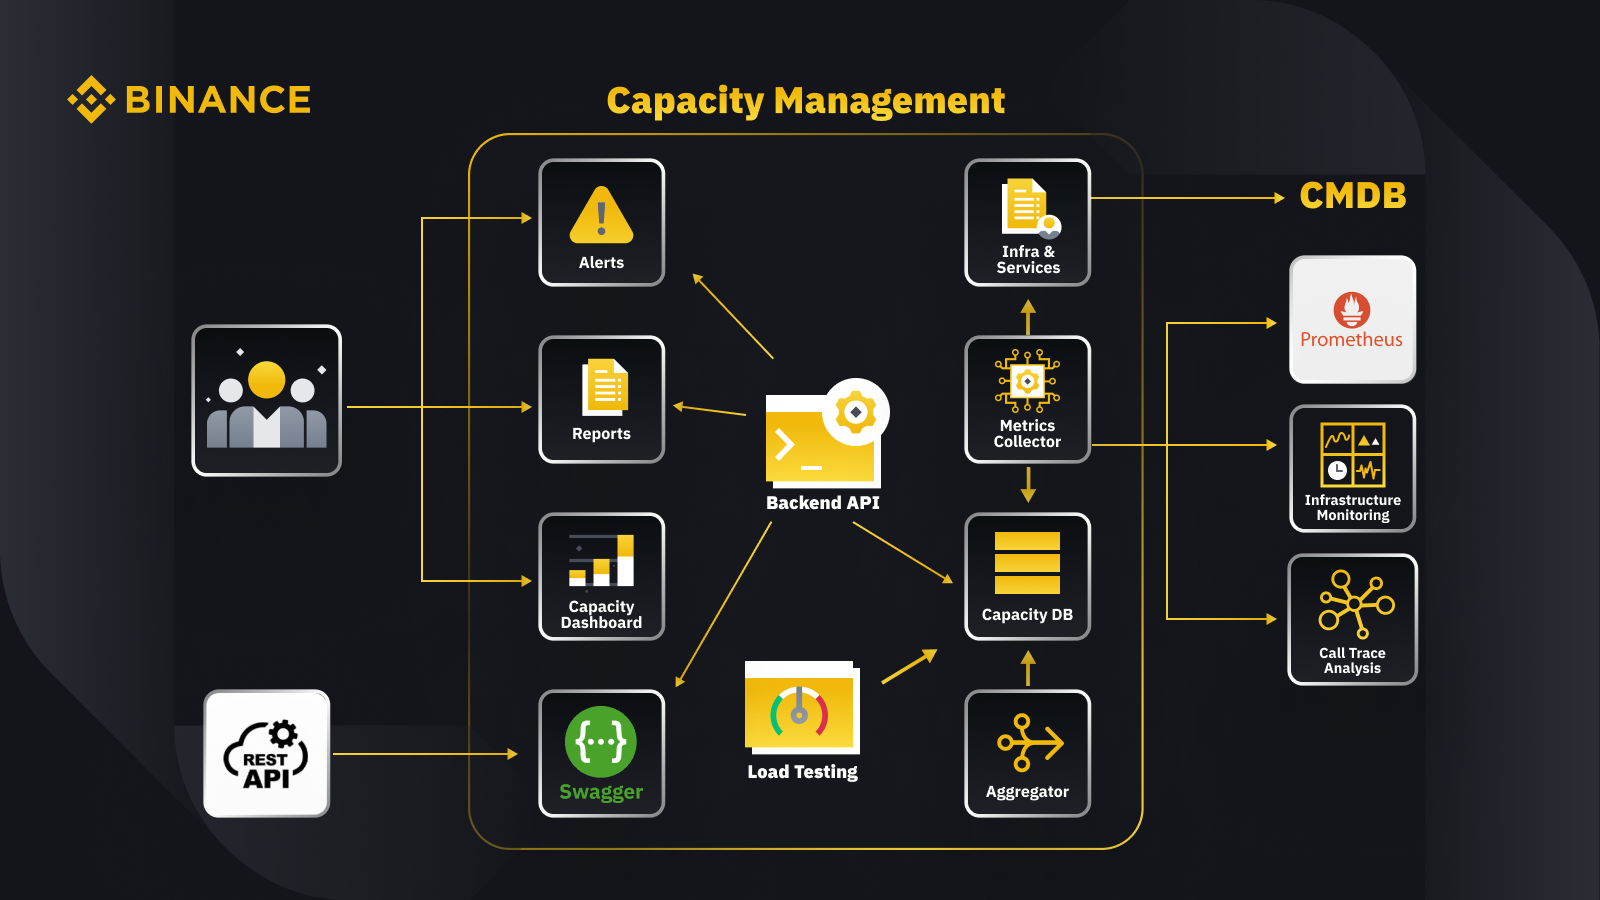
من خلال جلب البيانات من قاعدة بيانات إدارة الإعدادات (CMDB)، نقوم بتوليد إعدادات البنية التحتية والخدمات. العناصر الموجودة في هذه الإعدادات هي كائنات إدارة السعة.
يقوم جامع المقاييس (metrics collector) بجلب مؤشرات السعة من Prometheus لبيانات طبقة الأعمال والخدمات، ومن Infrastructure Monitoring لمؤشرات طبقة الموارد، ومن نظام تحليل مسار الاستدعاء (call trace analysis system) لمعلومات التتبع (trace information). يقوم جامع المقاييس بتخزين البيانات في قاعدة بيانات السعة (CDB).
ينفذ نظام اختبار التحميل اختبارات إجهاد على الخدمات ويخزن بيانات المعيار (benchmark data) في CDB.
يستلم المُجمِّع بيانات السعة من قاعدة بيانات CDB ويُجملها لأبعاد البيانات اليومية وأعلى مستوى تاريخي (ATH). بعد التجميع، يكتب البيانات المُجمَّعة مرة أخرى في CDB.
من خلال معالجة البيانات من CDB، يوفّر واجهة برمجة التطبيقات الخلفية (Backend API) لوحات السعة والتنبيهات والتقارير، إضافةً إلى REST API وبيانات السعة ذات الصلة لأغراض التكامل.
يحصل أصحاب المصلحة على رؤى حول السعة عبر لوحة السعة والتنبيهات والتقارير. ويمكنهم أيضًا استخدام أنظمة أخرى ذات صلة، بما في ذلك المراقبة التي تحصل على بيانات سعة الخدمات عبر REST API الذي توفره منظومة إدارة السعة مع Swagger.
الاستراتيجية
تعتمد استراتيجية إدارة السعة والتخطيط لدينا على المعالجة المُحفَّزة بالذروة (peak-driven processing). المعالجة المُحفَّزة بالذروة هي عبء العمل الذي تُواجهه موارد الخدمة (خوادم الويب، قواعد البيانات، إلخ.) أثناء الاستخدام في أوقات الذروة.
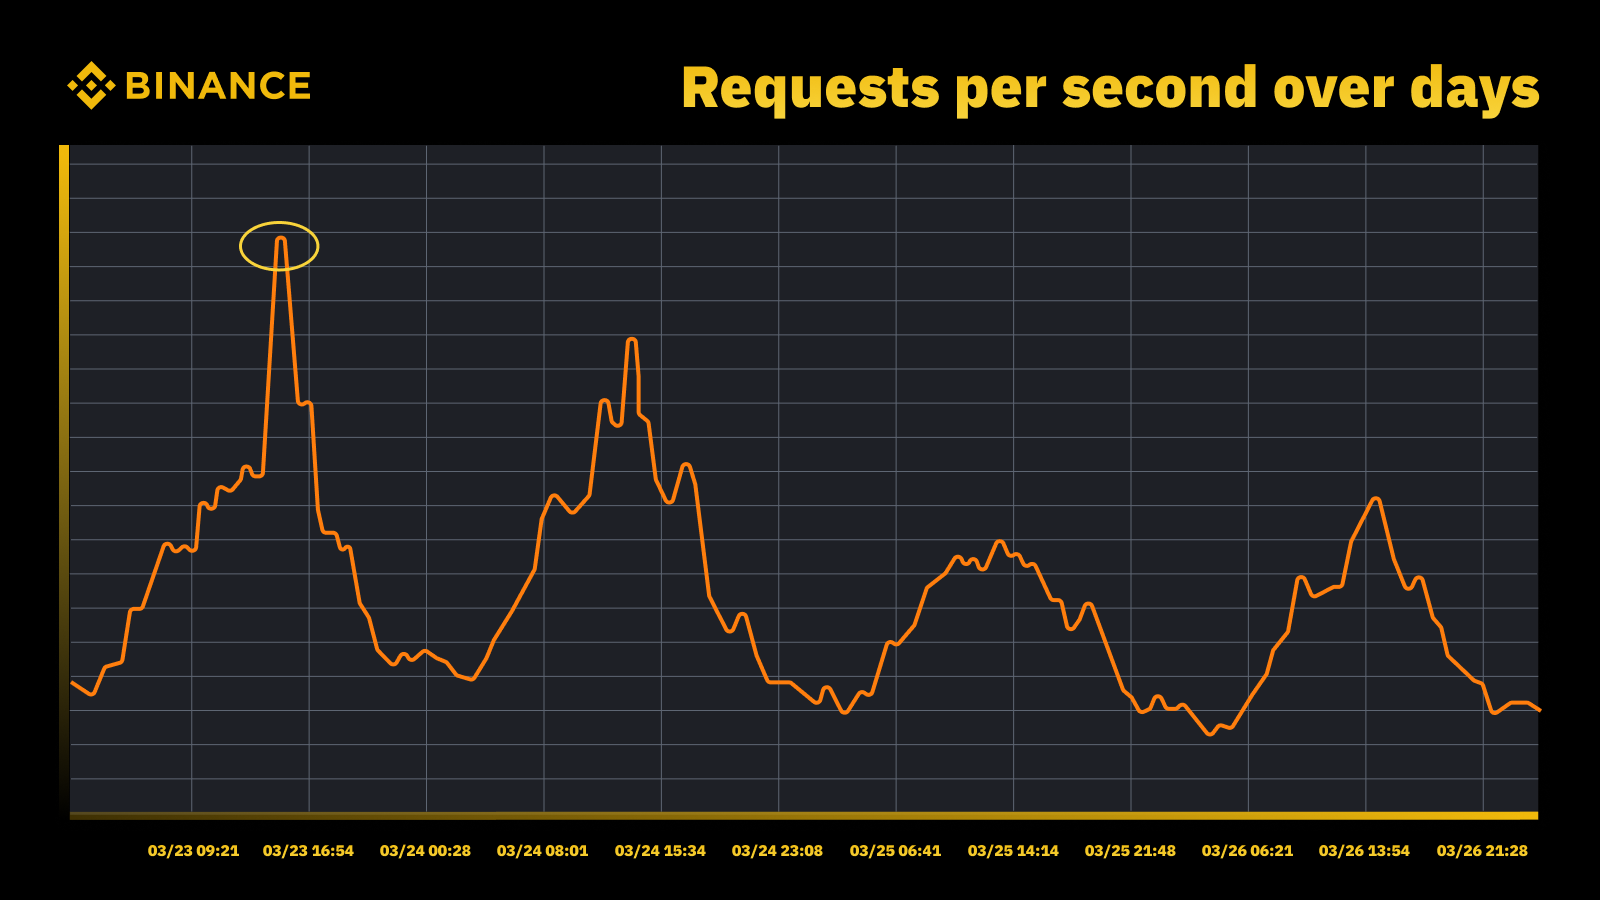
اندفاع حركة المرور عندما رفعَت الجهة الفيدرالية (Fed) الفائدة في مارس 2023
نحلل القمم/الذروات الدورية ونستخدمها لتوجيه مسار السعة. كما هو الحال مع أي مورد مُحفَّز بالذروة، نريد معرفة متى تحدث الذروات ثم نستكشف ما الذي يحدث فعليًا أثناء تلك الدورات.
هناك أمرٌ آخر مهم ننظر إليه إلى جانب منع التعطّل وهو التوسّع التلقائي (Autoscaling). يعالج التوسّع التلقائي حالات التعطّل عبر زيادة السعة ديناميكيًا بمزيد من مثيلات خدمة ما. ثم يتم توزيع الزيادات في حركة المرور، ويظل الحمل الذي تتعامل معه مثيلة واحدة من الخدمة (أو أحد التبعيات) ضمن مستوى يمكن التحكم فيه.
للتوسّع التلقائي مكانته، لكنه يَقصُر عندما يُستخدم بمفرده للتعامل مع حالات التعطّل. عادةً لا يمكنه الاستجابة بالسرعة الكافية لزيادة مفاجئة في حركة المرور، ويعمل بشكل أفضل عندما تكون الزيادة تدريجية.
القياس
يلعب القياس دورًا حاسمًا في أعمال إدارة السعة لدى Binance، وتُعد عملية جمع البيانات لدينا هي خطوة القياس الأولى. وبناءً على معايير مكتبة البنية التحتية لتكنولوجيا المعلومات (ITIL)، نجمع البيانات للقياس داخل عمليات إدارة السعة الفرعية، أي:
المورد - استهلاك موارد البنية التحتية لتكنولوجيا المعلومات الناتج عن استخدام التطبيق/الخدمة. يركّز على مؤشرات الأداء الداخلية للموارد الحاسوبية الفعلية والافتراضية، بما في ذلك وحدة المعالجة المركزية للخادم، والذاكرة، وتخزين الأقراص، وعرض النطاق للشبكة، إلخ.
الخدمة. مقاييس أداء المستوى التطبيقي، وSLA، وزمن الاستجابة (latency)، والإنتاجية (throughput) الناشئة عن الأنشطة التجارية. يركّز على مقاييس الأداء الخارجية بناءً على كيفية إدراك المستخدمين للخدمة، بما في ذلك زمن استجابة الخدمة، والإنتاجية، والذروات/القمم، إلخ.
الأعمال. تجمع بيانات تقيس الأنشطة التجارية التي يعالجها التطبيق المستهدف، بما في ذلك الطلبات، وتسجيل المستخدمين، والمدفوعات، إلخ.
ستؤدي إدارة السعة اعتمادًا على استغلال موارد البنية التحتية فقط إلى تخطيط غير دقيق. والسبب في ذلك أنها قد لا تعكس أحجام الأعمال الفعلية والإنتاجية التي تدفع سعة البنية التحتية لدينا.
توفر الأحداث المجدولة مكانًا ممتازًا لمناقشة هذا الأمر بشكل أعمق. لنأخذ حملة Watch Web Summit 2022 على Binance Live لتقديم مكافآت Crypto Box حتى 15,000 BUSD. بالإضافة إلى مؤشرات طبقة الموارد والخدمة الأساسية، كان علينا أيضًا مراعاة أحجام الأعمال. اعتمدنا هنا في تخطيط السعة على مؤشرات أعمال مثل العدد التقديري لمشاهدي البث المباشر، والحد الأقصى لطلبات الرحلات/الطلبات المتداخلة داخل الطيران (in-flight requests) لصندوق Crypto Box، وزمن الاستجابة من طرف إلى طرف (end-to-end latency)، وعوامل أخرى.
بعد جمع البيانات، تقوم عمليات إدارة السعة لدينا بتجميع وتلخيص العديد من نقاط البيانات التي تم جمعها مقابل مُحرِّك سعة (capacity driver) محدد. القيمة المُجمَّعة للمؤشر هي قيمة واحدة يمكن استخدامها في التنبيه حول السعة والتقارير والوظائف الأخرى المتعلقة بالسعة.
يمكننا تطبيق عدة أساليب لتجميع البيانات على نقاط البيانات الدورية، مثل: المجموع (sum)، المتوسط (average)، الوسيط (median)، الحد الأدنى (minimum)، الحد الأقصى (maximum)، النسبة المئوية (percentile)، وأعلى مستوى تاريخي (ATH).

تحدد طريقتنا المختارة مخرجات عملية إدارة السعة والقرارات الناتجة عنها. نختار طرقًا مختلفة بناءً على سيناريوهات مختلفة. على سبيل المثال، نستخدم طريقة الحد الأقصى (maximum) للخدمات الحرجة ونقاط البيانات ذات الصلة. ولتسجيل أعلى حركة مرور، نستخدم طريقة ATH.
للاستخدامات/حالات الاستخدام المختلفة، نستخدم أنواع دقة/حبيبية (granularity) مختلفة لتجميع البيانات. في معظم الحالات، نستخدم إما الدقيقة أو الساعة أو اليوم أو ATH.
باستخدام دقة دقيقة، نقيس عبء عمل الخدمة لإجراء تنبيهات مناسبة وفي الوقت المناسب حول التعطّل بسبب الحمل الزائد.
نستخدم بيانات مُجمَّعة على أساس كل ساعة لبناء بيانات يومية، ثم نقوم بتجميع بيانات الساعة لتسجيل قمة/ذروة اليوم (daily peak).
عادةً نستخدم البيانات اليومية لتقارير السعة، ونعتمد على بيانات ATH في نمذجة السعة والتخطيط.
تُعد إحدى المقاييس الأساسية لإدارة السعة هي القياس/التحكيم المعياري لأداء الخدمة (service benchmarking). يساعدنا ذلك على قياس أداء الخدمة والسعة بدقة. نحصل على معيار/Benchmark الخدمة عبر اختبارات التحميل (load testing)، وسنتناول ذلك بمزيد من التفصيل لاحقًا.
إدارة السعة بناءً على الأولوية
حتى الآن، رأينا كيف نجمع مؤشرات السعة ونُجمِّع البيانات بأنواع مختلفة من الحبيبية/الدقة. مجال آخر مهم يجب مناقشته هو الأولوية، وهي مفيدة في سياق التنبيه وتقارير السعة. بعد ترتيب أصول تقنية المعلومات (IT assets)، يتم إعطاء الأولوية لاستخدامات البنية التحتية والموارد الحاسوبية المحدودة للخدمات والأنشطة الحرجة أولاً.
يمكن تعريف حرجية الخدمة وطلبات العمل بطرق متعددة. مرجع مفيد هو Google في كتاب SRE. يعرّفون مستويات الحرجية مثل CRITICAL_PLUS وCRITICAL وSHEDDABLE_PLUS وما إلى ذلك. وبالمثل، نعرّف عدة مستويات أولوية مثل P0 وP1 وP2 وما إلى ذلك.
نعرّف مستويات الأولوية كما يلي:
P0: بالنسبة لأكثر الخدمات والطلبات حرجة، وهي التي ستؤدي إلى تأثير جسيم يمكن أن يلاحظه المستخدم إذا فشلت.
P1: بالنسبة لتلك الخدمات والطلبات التي ستؤدي إلى تأثير يمكن أن يلاحظه المستخدم، ولكن يكون التأثير أقل من تأثيرات P0. من المتوقع تزويد خدمات P0 وP1 بسعة كافية.
P2: هذه هي الأولوية الافتراضية للمهام الدفعية (batch jobs) والمهام غير المتصلة/غير المباشرة (offline jobs). قد لا تؤدي هذه الخدمات والطلبات إلى تأثير يمكن أن يلاحظه المستخدم إذا أصبحت غير متاحة جزئيًا.
ما هو اختبار التحميل (Load Testing)، ولماذا نستخدمه في بيئة الإنتاج؟
اختبار التحميل هو عملية اختبار برمجيات لاوظيفية (non-functional) يتم فيها اختبار أداء التطبيق تحت عبء عمل محدد. يساعد ذلك على تحديد كيفية تصرف التطبيق عند الوصول إليه من قبل عدة مستخدمين نهائيين في الوقت نفسه.
في Binance، أنشأنا حلاً يمكّننا من تشغيل اختبار التحميل في بيئة الإنتاج. عادةً يُجرى اختبار التحميل في بيئة staging، لكننا لم نستطع استخدام هذا الخيار بناءً على أهدافنا الشاملة لإدارة السعة. سمح اختبار التحميل في بيئة الإنتاج لنا بـ:
جمع معيار/Benchmark دقيق لخدماتنا تحت ظروف حمل واقعية.
زيادة الثقة في النظام وموثوقيته وأدائه.
تحديد الاختناقات في النظام قبل حدوثها في بيئة الإنتاج.
تمكين المراقبة المستمرة لبيئات الإنتاج.
تمكين إدارة سعة استباقية مع دورات اختبار مُطبَّعة (normalized) تحدث بانتظام.
فيما يلي يمكنك رؤية إطار اختبار التحميل لدينا مع بعض النقاط الأساسية التي نأخذها:

يحتوي إطار الخدمات المصغّرة (microservice framework) لدى Binance على طبقة أساسية لدعم توجيه حركة المرور المعتمد على الإعدادات (config-driven) وبناءً على الأعلام (flag-based)، وهو أمر ضروري لمنهجيتنا TIP.
تم اعتماد تحليل الكناري الآلي (Automated canary analysis/ACA) لتقييم المثيل الذي نختبره. يقارن المقاييس الرئيسية التي تم جمعها في نظام المراقبة، لذلك يمكننا إيقاف/إنهاء الاختبار إذا حدث أي أمر غير متوقع لتقليل تأثيرات المستخدمين.
يتم جمع المعايير والمقاييس أثناء اختبار التحميل لإنتاج رؤى حول السلوك وأداء التطبيقات.
يتم إتاحة واجهات برمجة التطبيقات (APIs) لمشاركة بيانات أداء قيمة في سيناريوهات مختلفة، مثل إدارة السعة وضمان الجودة. يساعد ذلك على بناء نظام بيئي مفتوح.
ننشئ مسارات عمل آلية (automation workflows) لتنظيم جميع الخطوات ونقاط التحكم من منظور اختبار شامل من طرف إلى طرف. كما نوفر مرونة في التكامل مع أنظمة أخرى، مثل خط CI/CD وبوابة العمليات.
نهج الاختبار في الإنتاج (TIP) لدينا
يوفر نهج اختبار الأداء التقليدي (تشغيل الاختبارات في بيئة staging مع حركة مرور مُحاكاة أو مُطابقة) بعض المزايا. ومع ذلك، فإن نشر بيئة staging شبيهة بالإنتاج لديه في سياقنا سلبيات أكثر:
يُكلف تقريبًا ضعفي تكلفة البنية التحتية وجهود الصيانة.
من الصعب للغاية جعل الاختبار يعمل فعليًا من طرف إلى طرف في الإنتاج، خصوصًا في بيئة خدمات مصغّرة واسعة النطاق عبر وحدات أعمال متعددة.
يضيف ذلك مخاطر خصوصية البيانات والأمان بشكل أكبر، إذ قد نحتاج حتمًا إلى تكرار البيانات في staging.
لن تستطيع حركة المرور المُحاكية أن تعيد إنتاج ما يحدث فعليًا في الإنتاج. سيكون المعيار/Benchmark المستخرج في بيئة staging غير دقيق وقيمته أقل.
اختبار الإنتاج، والمعروف أيضًا باسم TIP، هو منهجية لاختبار “يميني/Shift-right” حيث يتم اختبار الكود الجديد والميزات والإصدارات في بيئة الإنتاج. يُعد اختبار التحميل في الإنتاج الذي اعتمدناه مفيدًا جدًا لأنه يساعدنا على:
تحليل ثباتية (stability) النظام ومتانته (robustness).
اكتشاف معايير/benchmarks والاختناقات للتطبيقات تحت مستويات مختلفة من حركة المرور ومواصفات الخوادم ومعلمات التطبيقات.
التوجيه المعتمد على FlowFlag
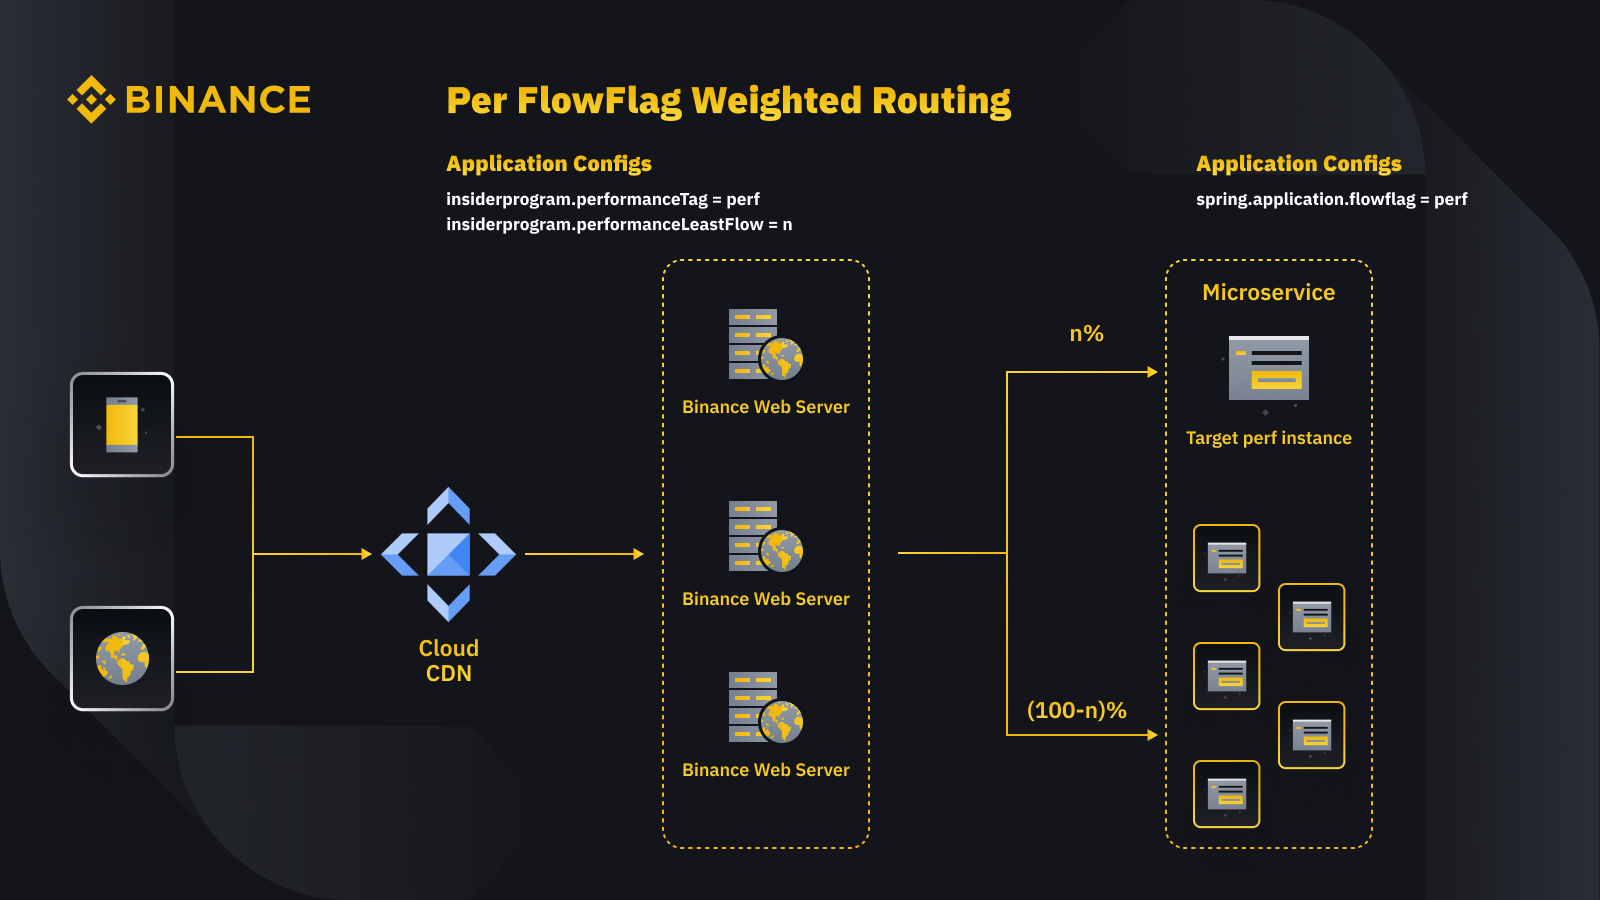
يُعد توجيهنا المعتمد على FlowFlag داخل إطار الخدمات المصغّرة (microservice base framework) هو الأساس لتمكين TIP. ويصح ذلك لحالات محددة، بما في ذلك التطبيقات التي تستخدم Eureka لاكتشاف الخدمة لتوزيع حركة المرور.
كما هو موضح في الرسم البياني: يقوم خادم الويب لدى Binance كنقطة دخول بتحديد نسبة من حركة المرور كما هي محددة في الإعدادات باستخدام رؤوس FlowFlag. أثناء اختبار التحميل، يمكننا اختيار مضيف واحد من خدمة محددة ووضعه كهدف لقياس/instance للأداء (perf instance) في الإعدادات؛ ثم يتم في النهاية توجيه طلبات قياس الأداء الموسومة/المعلّمة إلى مثيل الأداء عند وصولها إلى الخدمة للمعالجة.
إنه يعتمد بالكامل على الإعدادات، وبالتحميل الساخن (hot loading). يمكننا بسهولة ضبط نسبة عبء العمل عبر الأتمتة دون الحاجة إلى نشر إصدار جديد.
يمكن تطبيقه على نطاق واسع على معظم خدماتنا، لأن هذه الآلية جزء من بوابة (gateway) وحزمة الأساس.
إن نقطة التغيير الواحدة تعني أيضًا إمكانية التراجع السريع (rollback) لتقليل المخاطر في الإنتاج
بينما نحول حلنا ليكون أكثر سَحابيّة بطبيعتها (cloud-native)، فإننا نستكشف أيضًا كيفية بناء نهج مماثل لدعم سيناريوهات توجيه حركة المرور الأخرى التي تقدمها مزودات السحابة العامة أو Kubernetes.
تحليل كناري آلي لتقليل مخاطر تأثير المستخدمين
نشر الكناري (Canary deployment) هو استراتيجية نشر لتقليل مخاطر إدخال إصدار برمجيات جديد إلى الإنتاج. يتضمن عادةً نشر نسخة جديدة من البرنامج، تُسمى إصدار الكناري (canary release)، إلى شريحة صغيرة من المستخدمين جنبًا إلى جانب نسخة التشغيل المستقرة. ثم نقسم حركة المرور بين النسختين بحيث يتم توجيه جزء من الطلبات الواردة إلى نسخة الكناري.
بعد ذلك، يتم تقييم جودة نسخة الكناري عبر ما يُسمى بتحليل الكناري (canary analysis). يقارن ذلك المقاييس الرئيسية التي تصف سلوك النسخة القديمة والجديدة. إذا حدث تدهور كبير في المقاييس، يتم إلغاء/إيقاف الكناري، ويتم توجيه كل حركة المرور إلى النسخة المستقرة لتقليل تأثير أي سلوك غير متوقع.
نستخدم نفس المفهوم لبناء حل اختبار التحميل التلقائي لدينا. يستخدم الحل منصة Kayenta لإجراء تحليل كناري آلي (ACA) عبر Spinnaker لتمكين عمليات نشر الكناري التلقائية. يبدو سير عمل اختبار التحميل المعتاد لدينا عند اتباع هذه الطريقة كالتالي:
من خلال سير العمل، نضيف تدريجيًا أحمال حركة المرور (مثل 5% و10% و25% و50%) إلى المضيف الهدف كما هو محدد أو حتى يصل إلى نقطة تعثره/حده الأقصى.
تحت كل مستوى تحميل، يتم تشغيل تحليل الكناري بشكل متكرر باستخدام Kayenta لفترة زمنية معينة (مثل 5 دقائق) لمقارنة المقاييس الرئيسية للمضيف قيد الاختبار مع فترة ما قبل التحميل كمرجع (baseline)، وفترة ما بعد التحميل الحالية كاختبار (experiment).
يركز التقييم/المقارنة (نموذج إعدادات الكناري canary config model) على التحقق مما إذا كان المضيف الهدف:
يصل إلى قيود الموارد، مثل تجاوز استخدام CPU لنسبة 90%.
لديه زيادة كبيرة في مقاييس الفشل، مثل سجلات الأخطاء، أو استثناءات HTTP، أو رفضات حدود المعدل (rate limit rejects).
ما زالت المقاييس الأساسية للتطبيق ضمن حدود معقولة، مثل زمن استجابة HTTP أقل من ثانيتين (قابل للتخصيص لكل خدمة).
في كل تحليل، يقدّم Kayenta تقريرًا يوضح النتيجة، وينتهي الاختبار فورًا عند حدوث فشل.
عادةً ما يستغرق اكتشاف الفشل هذا أقل من 30 ثانية، مما يقلل بشكل كبير من احتمال التأثير على تجربة المستخدمين النهائيين لدينا.

تمكين رؤى البيانات (Enabling Data Insights)
من الضروري جمع معلومات كافية حول جميع العمليات وتنفيذ الاختبارات التي تم وصفها مسبقًا. الهدف النهائي هو تحسين موثوقية ومتانة نظامنا، وهو أمر مستحيل دون رؤى البيانات.
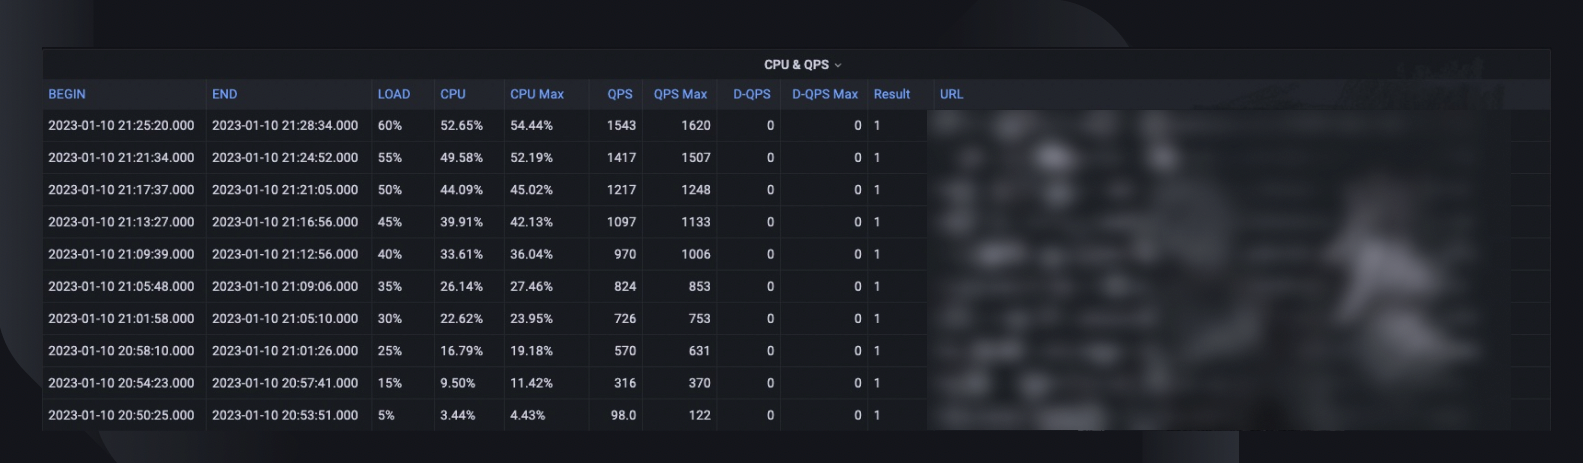
يلخّص ملخص الاختبار الشامل الحد الأقصى لنسبة الحمل التي كان المضيف قادرًا على التعامل معها، وأعلى استخدام لـCPU، وQPS للمضيف. وبناءً على ذلك، يقوم أيضًا بتقدير عدد المثيلات التي قد نحتاج إلى نشرها لتلبية حجز السعة لدينا، مع مراعاة جميع أعلى مستوى تاريخي لـ QPS للخدمات.
تشمل المعلومات الأخرى القيمة للتحليل إصدار البرنامج (software version) ومواصفات الخادم (server spec) وعدد النسخ/المثيلات الموزعة (deployed count)، ورابط إلى لوحة المراقبة (monitor dashboard) التي يمكننا من خلالها الرجوع لمعرفة ما حدث أثناء الاختبار.

يشير منحنى المعيار/Benchmark إلى كيفية تغير الأداء خلال آخر ثلاثة أشهر حتى نكتشف أي مشكلات محتملة مرتبطة بإصدار تطبيق محدد.

تُظهر اتجاهات CPU وQPS كيف يرتبط استخدام CPU بحجم الطلبات الذي كان على الخادم التعامل معه. يمكن لهذا المقياس أن يساعد في تقدير “مساحات/احتياطيات” قدرة الخادم لنمو حركة المرور الوارد.
يلتقط سلوك زمن استجابة واجهات API كيفية تغير وقت الاستجابة تحت ظروف تحميل مختلفة لأفضل خمس واجهات API. ثم يمكننا تحسين النظام عند الحاجة على مستوى كل واجهة API بشكل منفصل.

تساعدنا مقاييس توزيع حمل واجهات API في فهم كيف يؤثر تركيب واجهات API على أداء الخدمة، وتمنحنا رؤى إضافية حول مجالات التحسين.
التطبيع والتحويل إلى منتج (productization)
مع استمرار نمو نظامنا وتطوره، سنواصل متابعة وتحسين ثباتية وموثوقية الخدمة. وسنستمر في ذلك عبر:
جدول منتظم ومُثبت لاختبار التحميل للخدمات الحرجة.
اختبار تحميل تلقائي كجزء من مسارات CI/CD لدينا.
زيادة تحويل الحل كاملًا إلى منتج (productization) للتحضير لاعتماده على نطاق واسع عبر المنظمة بأكملها.
القيود
توجد بعض القيود على منهجية اختبار التحميل الحالية:
التوجيه المعتمد على FlowFlag ينطبق فقط على إطار الخدمات المصغّرة لدينا. نعمل على توسيع الحل ليغطي سيناريوهات توجيه أكثر عبر الاستفادة من ميزة التوجيه الموزون الشائعة لدى موازِنات حمل السحابة أو Ingress الخاص بـ Kubernetes.
وبما أننا نستند في الاختبار إلى حركة مرور المستخدمين الفعليين في الإنتاج، فلا يمكننا إجراء اختبارات الميزات (feature tests) مقابل واجهات API أو حالات استخدام محددة. كذلك، بالنسبة للخدمات ذات الحجم المنخفض جدًا، ستكون قيمة الاختبار محدودة لأننا قد لا نتمكن من تحديد الاختناق فيها.
نجري هذه الاختبارات على خدمات فردية بدلاً من تغطية سلاسل الاستدعاء من طرف إلى طرف.
قد يؤثر اختبار التحميل في الإنتاج أحيانًا على المستخدمين الحقيقيين إذا حدثت حالات فشل. لذلك يجب أن تكون لدينا تحليلات للأعطال وخطة تراجع تلقائي (auto-rollback) مع قدرات أتمتة كاملة.
أفكار ختامية
من الضروري بالنسبة لنا التفكير في سيناريوهات اندفاع حركة المرور لمنع تعطل النظام وضمان استمرار توفره. لهذا السبب بنينا عمليات إدارة السعة واختبار التحميل الموضحة طوال هذا المقال. وللتلخيص:
تدار إدارة السعة لدينا وفق نهج قائم على الذروات ومُدمجة في كل مرحلة من دورة حياة الخدمة، وتمنع التعطل عبر أنشطة مثل القياس، وتحديد الأولوية، والتنبيه، وتقارير السعة، إلخ. هذا هو في النهاية ما يجعل عمليات Binance واحتياجاتها فريدة مقارنة بحالة إدارة سعة نموذجية.
إن معيار/Benchmark الخدمة المستخرج من اختبار التحميل هو محور إدارة السعة والتخطيط. فهو يحدد بشكل دقيق موارد البنية التحتية اللازمة لدعم احتياجات الأعمال الحالية والمستقبلية. وبشكل نهائي، كان يجب تنفيذ ذلك في الإنتاج باستخدام حل فريد تم بناؤه بواسطة Binance وقد مكننا من تلبية احتياجاتنا المحددة.
مع وضع كل ذلك معًا، نأمل أن تتمكن من رؤية أن التخطيط الجيد والأطر الشاملة يساعدان في إنشاء الخدمة التي يعرفها موظفو Binance ويستمتعون بها.
المراجع
Dominic Ogbonna، A-Z of Capacity Management: Practical Guide for Implementing Enterprise IT Monitoring & Capacity Planning، الفصل 4، الفصل 6
Luis Quesada Torres، Doug Colish، SRE Best Practices for Capacity Management
Alejandro Forero Cuervo، Sarah Chavis، كتاب Google SRE، الفصل 21 - التعامل مع الحمل الزائد (Handling Overload)
قراءات إضافية
(مدونة) كيف يشغّل Binance Ledger تجربة Binance الخاصة بك
(مدونة) تقديم Binance Oracle VRF: الجيل التالي من العشوائية القابلة للتحقق
(مدونة) Binance تنضم إلى تحالف FIDO استعدادًا لتنفيذ مفاتيح المرور (Passkeys)