
اختيار البنية التحتية المناسبة للحوسبة من أجل الذكاء الاصطناعي
تختار معظم فرق الذكاء الاصطناعي مزوّدي خدمات الحوسبة بطريقة خاطئة.
يقارنون أسعار H100 بالساعة، ويتصفحون تصنيفات مزودي الخدمة، ويختارون الخيار الأرخص. وبعد ستة أشهر، يجدون أنفسهم أمام قيود السعة وارتفاع التكاليف والارتهان لمورّد واحد.
المشكلة؟ ينبغي أن تستند قرارات الحوسبة إلى متطلبات أعباء العمل، لا إلى أسعار وحدات GPU فحسب.
إليك إطارًا أفضل.
1. اطرح الأسئلة الصحيحة أولًا
قبل اختيار مزوّد خدمة، ضع خمسة أمور في الحسبان:
- عبء العمل: تدريب دفعي أم استدلال بزمن استجابة منخفض؟
- الميزانية: هل الإنفاق تجريبي أم أن الطلب واسع النطاق ويمكن التنبؤ به؟
- DevOps: هل يستطيع فريقك إدارة عدة مزوّدين للبنية التحتية؟
- الامتثال: هل تحتاج إلى HIPAA أو SOC 2 أو ضوابط إقليمية للبيانات؟
- قابلية التوسع: هل تستطيع البنية التحتية التعامل مع زيادة مفاجئة في الطلب بمقدار 10×؟
تحدد الإجابات نموذج الحوسبة الأنسب.
2. تعرّف على نماذج الحوسبة الثلاثة
مزوّدو الخدمات السحابية فائقة النطاق (AWS/GCP): منظومات ناضجة، وامتثال قوي، وأدوات متكاملة. لكنهم غالبًا ما يفرضون أسعارًا مرتفعة ورسومًا على نقل البيانات إلى الخارج، كما أن الموافقة على حصص GPU قد تستغرق وقتًا طويلًا.
مزوّدو الخدمات السحابية الناشئون: أسعار تنافسية لوحدات GPU وإمكانية أسرع للوصول إلى موارد الحوسبة الخام، لكن قد ينطوي ذلك على اعتماد أكبر على سعة مزوّد واحد.
شبكات الحوسبة المجمّعة (GPU.net): تربط موارد GPU الموزعة عبر سوق موحّد، ما يتيح وصولًا أوسع إلى السعة وأسعارًا تنافسية وتوسعًا مرنًا.
يلبي كل نموذج احتياجات مختلفة. والهدف هو تجنب القيود غير الضرورية على البنية التحتية.
3. التدريب والاستدلال ليسا الشيء نفسه
هذا أحد أكثر الأخطاء تكلفةً التي ترتكبها فرق الذكاء الاصطناعي.
يتطلب التدريب عناقيد GPU قوية، ووصلات ربط عالية السرعة مثل NVLink، ومعالجة فعّالة على دفعات.
يتطلب الاستدلال زمن استجابة منخفضًا، وتوزيعًا جغرافيًا، وأوقات بدء سريعة، وتوافرًا عاليًا، وتكلفة محسّنة لكل رمز.
يُجرى التدريب على مراحل مكثفة، أما الاستدلال فيستمر ما دام المستخدمون يستفيدون من منتجك المعتمد على الذكاء الاصطناعي.
يجب أن تراعي استراتيجية البنية التحتية لديك كليهما.
4. وسّع نطاق بنيتك التحتية على مراحل
- ما قبل ملاءمة المنتج للسوق (PMF): أعطِ الأولوية للحوسبة عند الطلب. وتجنب الالتزامات طويلة الأجل ما دام الطلب غير مؤكد.
- النمو المبكر: افصل بين عناقيد التدريب والاستدلال. حلّل الإنفاق على مدى 60 يومًا قبل التفكير في السعة المحجوزة.
- التوسع إلى الإنتاج: قلّل الاعتماد على مورّد واحد من خلال عمليات نشر قابلة للنقل، ومعايير مفتوحة للحاويات، وبنية تحتية متعددة المورّدين.
لا تبنِ بنية تحتية لشركة لم تصبحها بعد.
5. أين يتناسب GPU.net
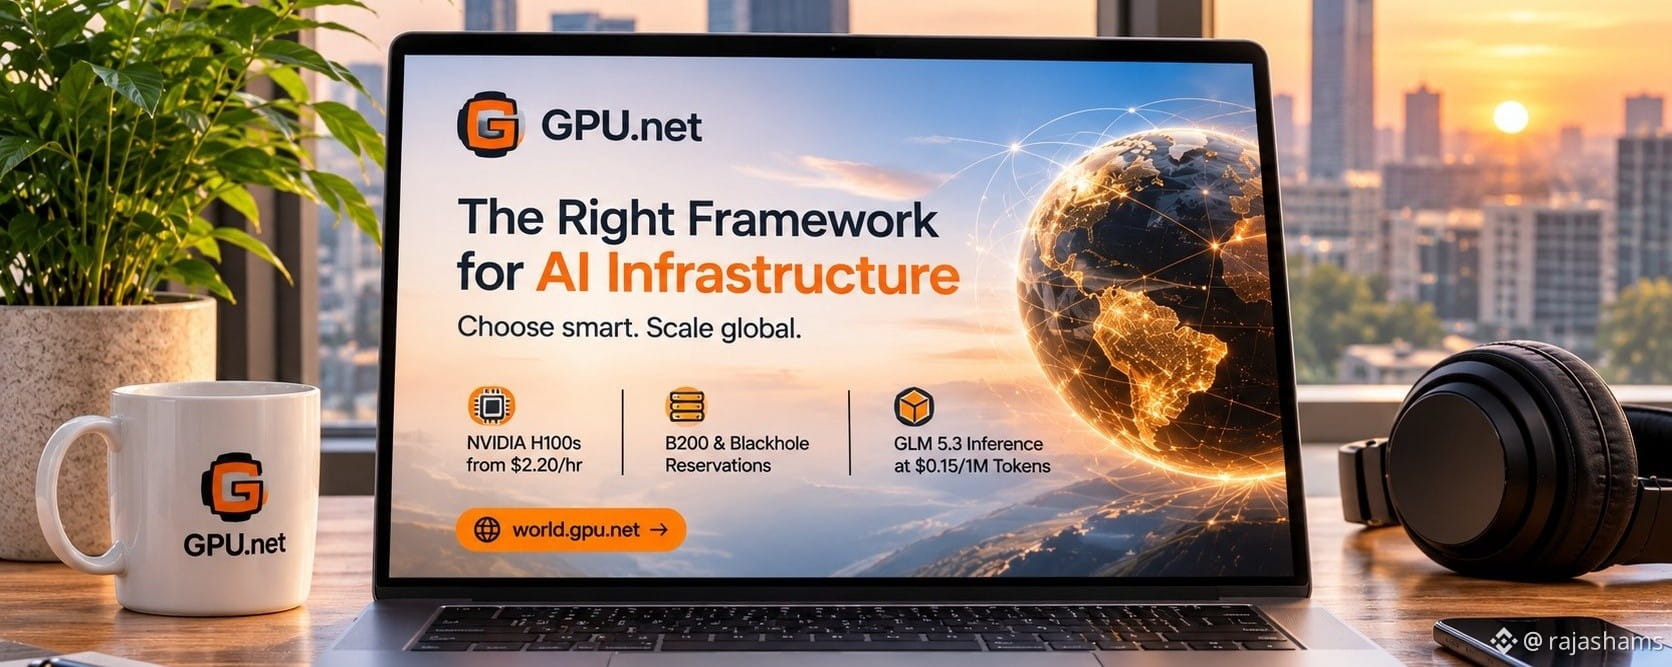
يجمع GPU.net سعة وحدات GPU الموزعة وخدمات الذكاء الاصطناعي ضمن منظومة واحدة.
تشمل عروضه:
- وحدات NVIDIA H100 GPU بسعر يبدأ من 2.20 دولارًا في الساعة.
- خيارات حجز B200 وBlackwell.
- استدلال GLM 5.3 المتوافق مع OpenAI بسعر 0.15 دولار لكل مليون رمز.
تربط المنظومة الأوسع أيضًا بين حوسبة GPU والنماذج المستضافة ووكلاء الذكاء الاصطناعي وفرص العائد المرتبطة بوحدات GPU.
الصورة الأكبر
لن يتحدد مستقبل البنية التحتية للذكاء الاصطناعي بمزوّد سحابي واحد.
بل ستحدده كفاءة وصول أحمال العمل إلى موارد الحوسبة العالمية، بناءً على التكلفة والموقع الجغرافي والتوافر وزمن الاستجابة.
لن تقتصر الميزة التنافسية على امتلاك مزيد من وحدات GPU، بل ستتمثل في الوصول إلى موارد الحوسبة المناسبة في الوقت المناسب وبتكلفة مناسبة
استكشف منظومة GPU.net: https://world.gpu.net/
#AI #GPU #DePIN #AIInfrastructure #C#cloudcomputing #Aİ #CloudInfrastructure #GPURental #DePIN