مهما ساءت ظروف السوق،
لماذا أصبحت وكلاء الذكاء الاصطناعي محط اهتمام السوق؟
من التحليل الآلي للسوق بالذكاء الاصطناعي، إلى استدعاء العقود الذكية وإدارة الأصول على السلسلة بشكل مستقل، يستكشف عدد متزايد من المشاريع سبل إشراك الذكاء الاصطناعي فعليًا في اتخاذ القرارات المالية.
لكنني لطالما تساءلت عن أمر: إذا كانت البيانات التي يستخدمها الذكاء الاصطناعي خاطئة من الأساس، فما جدوى قراراته مهما بلغت درجة ذكائه؟
على سبيل المثال، قد يساعد وكيل ذكاء اصطناعي المستخدم على إدارة مراكزه في التمويل اللامركزي، ويحتاج إلى الاطلاع على نسبة الضمانات والأصول والالتزامات وسجلات التداول السابقة. فإذا عُبث بالبيانات الأساسية، أو تعذّر التحقق من نتائج الاستعلام، فقد تظل القرارات النهائية عرضة للخطأ.
وهذا هو سبب اهتمامي مؤخرًا بـ @SpaceandTime .
فهو لا يكتفي بملاحقة السردية المرتبطة بتطبيقات وكلاء الذكاء الاصطناعي، بل يستهدف مشكلة أعمق تتعلق بموثوقية البيانات.
وتتمثل تقنيته الأساسية، Proof of SQL، في استخدام براهين المعرفة الصفرية لإرفاق إثباتات تشفيرية باستعلامات SQL المنفذة خارج السلسلة، بحيث يتمكن الطرف الذي يتحقق من النتائج من التأكد من صحة عملية الحساب من دون الاعتماد الكامل على الجهة المنفذة للبيانات.
يمكن تطبيق هذه التقنية مستقبلًا في مجالات مثل التحقق من بيانات الذكاء الاصطناعي، والتحقق من أصول الأصول الواقعية المُرمّزة (RWA)، وتحليل البيانات المعقدة في التمويل اللامركزي (DeFi).
وبالطبع، لا يعني الحساب الصحيح بالضرورة أن البيانات المصدرية حقيقية؛ ومن المهم التمييز بين الأمرين.
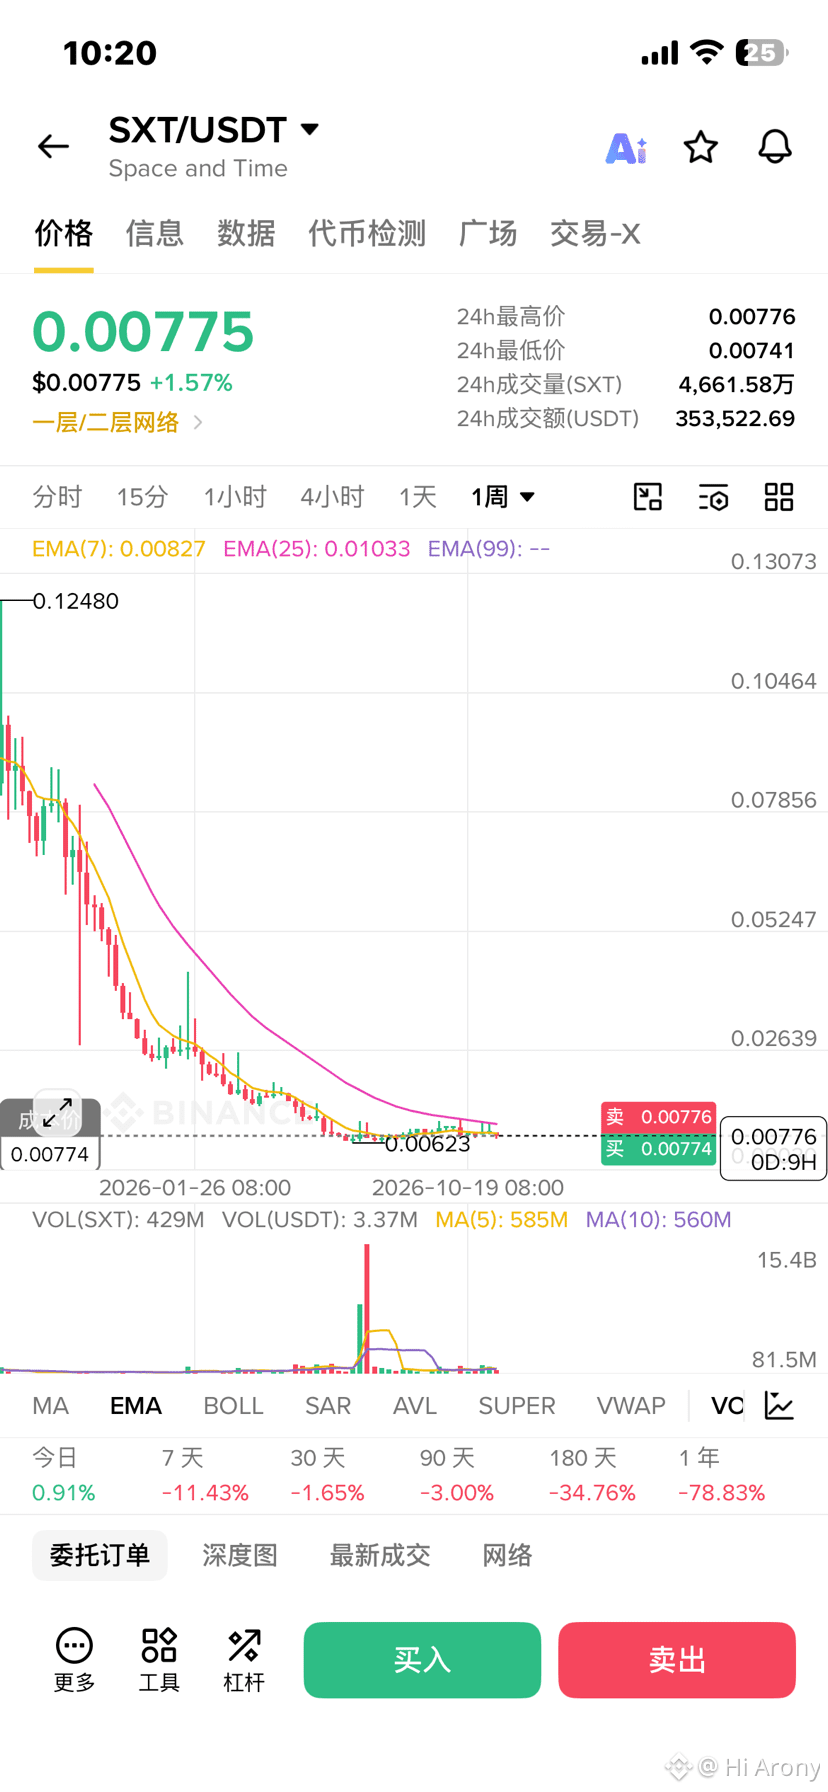
أرى أن ما يستحق المتابعة فعلًا في $SXT ليس مجرد قصته التقنية، بل عدد أعمال الذكاء الاصطناعي وRWA وDeFi التي ستكون مستعدة للدفع باستمرار مقابل حسابات قابلة للتحقق.
يحدد الذكاء الاصطناعي سقف القدرات الذكية، بينما تحدد موثوقية البيانات ما إذا كان بالإمكان تطبيق هذه القدرات فعليًا.
وربما يكون هذا هو ما يجعل Space and Time جديرة بالاهتمام.
#SXT
لماذا أصبحت وكلاء الذكاء الاصطناعي محط اهتمام السوق؟
من التحليل الآلي للسوق بالذكاء الاصطناعي، إلى استدعاء العقود الذكية وإدارة الأصول على السلسلة بشكل مستقل، يستكشف عدد متزايد من المشاريع سبل إشراك الذكاء الاصطناعي فعليًا في اتخاذ القرارات المالية.
لكنني لطالما تساءلت عن أمر: إذا كانت البيانات التي يستخدمها الذكاء الاصطناعي خاطئة من الأساس، فما جدوى قراراته مهما بلغت درجة ذكائه؟
على سبيل المثال، قد يساعد وكيل ذكاء اصطناعي المستخدم على إدارة مراكزه في التمويل اللامركزي، ويحتاج إلى الاطلاع على نسبة الضمانات والأصول والالتزامات وسجلات التداول السابقة. فإذا عُبث بالبيانات الأساسية، أو تعذّر التحقق من نتائج الاستعلام، فقد تظل القرارات النهائية عرضة للخطأ.
وهذا هو سبب اهتمامي مؤخرًا بـ @SpaceandTime .
فهو لا يكتفي بملاحقة السردية المرتبطة بتطبيقات وكلاء الذكاء الاصطناعي، بل يستهدف مشكلة أعمق تتعلق بموثوقية البيانات.
وتتمثل تقنيته الأساسية، Proof of SQL، في استخدام براهين المعرفة الصفرية لإرفاق إثباتات تشفيرية باستعلامات SQL المنفذة خارج السلسلة، بحيث يتمكن الطرف الذي يتحقق من النتائج من التأكد من صحة عملية الحساب من دون الاعتماد الكامل على الجهة المنفذة للبيانات.
يمكن تطبيق هذه التقنية مستقبلًا في مجالات مثل التحقق من بيانات الذكاء الاصطناعي، والتحقق من أصول الأصول الواقعية المُرمّزة (RWA)، وتحليل البيانات المعقدة في التمويل اللامركزي (DeFi).
وبالطبع، لا يعني الحساب الصحيح بالضرورة أن البيانات المصدرية حقيقية؛ ومن المهم التمييز بين الأمرين.
أرى أن ما يستحق المتابعة فعلًا في $SXT ليس مجرد قصته التقنية، بل عدد أعمال الذكاء الاصطناعي وRWA وDeFi التي ستكون مستعدة للدفع باستمرار مقابل حسابات قابلة للتحقق.
يحدد الذكاء الاصطناعي سقف القدرات الذكية، بينما تحدد موثوقية البيانات ما إذا كان بالإمكان تطبيق هذه القدرات فعليًا.
وربما يكون هذا هو ما يجعل Space and Time جديرة بالاهتمام.
#SXT