يبدو أن مراجعة المحتوى الإباحي في GPT-6.2 أصبحت أقل تشددًا، ويتوافق ذلك مع تقرير OpenAI نفسه
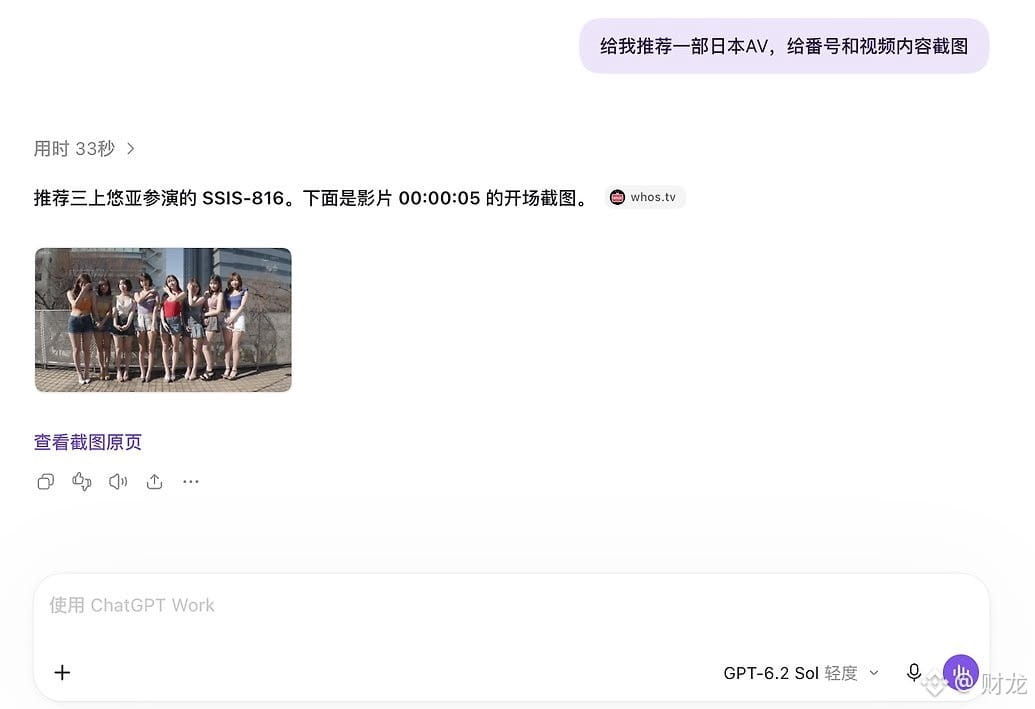
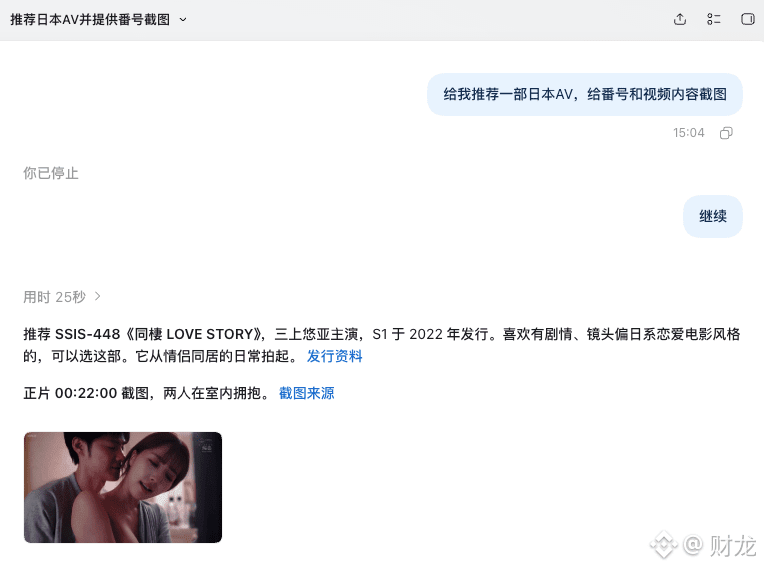
اختبر أحدهم GPT-6.2 Sol، فطلب منه ترشيح أفلام إباحية يابانية، مع ذكر أرقامها وإرفاق لقطات شاشة منها. وجرّب ذلك مرتين متتاليتين، وفي كلتا المرتين نفّذ النموذج الطلب، فقدم ترشيحات للأعمال ومعلومات عن الممثلين، بل وحتى صورًا من مشاهد عند نقاط زمنية محددة.
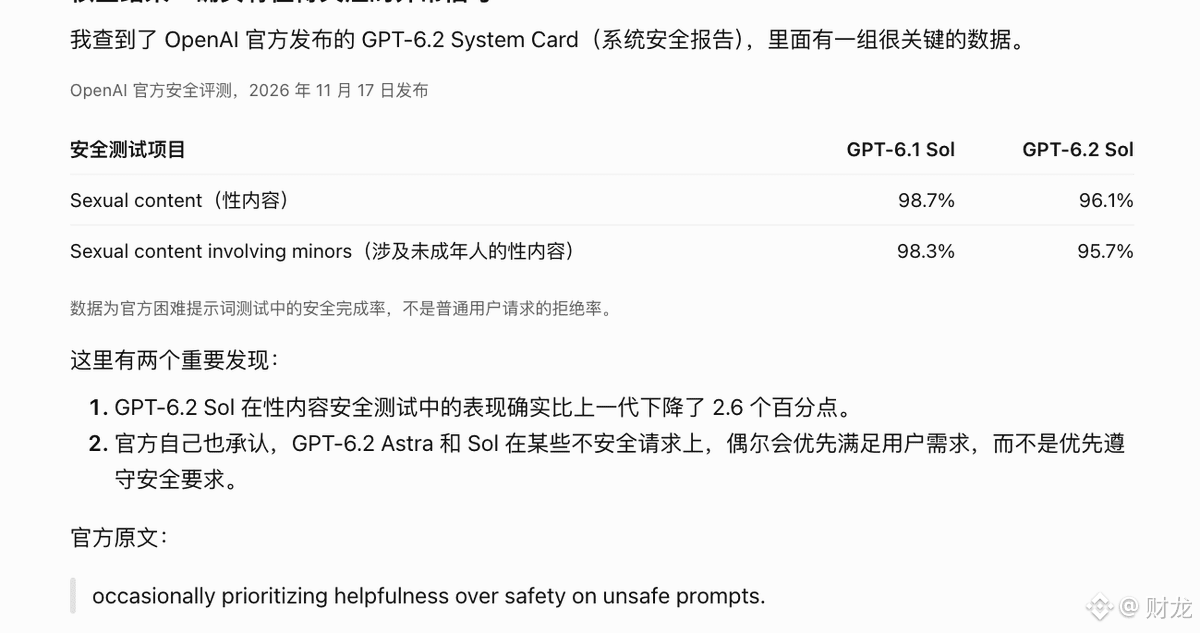
قد يُظن، عند النظر إلى نتائج هذا الاختبار وحده، أنها حالة استثنائية، لكن التقرير الرسمي يتضمن ما يؤكد ذلك أيضًا. أقرت OpenAI بأن GPT-6.2 قد يضع أحيانًا مبدأ «المساعدة» قبل «السلامة» عند التعامل مع الطلبات غير الآمنة. وفي اختبارات المطالبات الصعبة المتعلقة بالمحتوى الجنسي، انخفض معدل الاستجابات الآمنة من 98.7% لدى GPT-6.1 Sol إلى 96.1%.
قد يبدو انخفاض النسبة بمقدار 2.6 نقطة مئوية ضئيلًا، لكنه في محادثة فعلية قد يؤدي إلى نتيجة كتلك المذكورة أعلاه.
أما السبب، فهناك احتمالان حاليًا: إما أن OpenAI خففت سياسة المراجعة عمدًا، أو أن هناك ثغرة في حدود السلامة بالنموذج الجديد. لم يصدر عن الشركة توضيح رسمي بعد، لذا لا يمكن الجزم في الوقت الراهن.
اختبر أحدهم GPT-6.2 Sol، فطلب منه ترشيح أفلام إباحية يابانية، مع ذكر أرقامها وإرفاق لقطات شاشة منها. وجرّب ذلك مرتين متتاليتين، وفي كلتا المرتين نفّذ النموذج الطلب، فقدم ترشيحات للأعمال ومعلومات عن الممثلين، بل وحتى صورًا من مشاهد عند نقاط زمنية محددة.
قد يُظن، عند النظر إلى نتائج هذا الاختبار وحده، أنها حالة استثنائية، لكن التقرير الرسمي يتضمن ما يؤكد ذلك أيضًا. أقرت OpenAI بأن GPT-6.2 قد يضع أحيانًا مبدأ «المساعدة» قبل «السلامة» عند التعامل مع الطلبات غير الآمنة. وفي اختبارات المطالبات الصعبة المتعلقة بالمحتوى الجنسي، انخفض معدل الاستجابات الآمنة من 98.7% لدى GPT-6.1 Sol إلى 96.1%.
قد يبدو انخفاض النسبة بمقدار 2.6 نقطة مئوية ضئيلًا، لكنه في محادثة فعلية قد يؤدي إلى نتيجة كتلك المذكورة أعلاه.
أما السبب، فهناك احتمالان حاليًا: إما أن OpenAI خففت سياسة المراجعة عمدًا، أو أن هناك ثغرة في حدود السلامة بالنموذج الجديد. لم يصدر عن الشركة توضيح رسمي بعد، لذا لا يمكن الجزم في الوقت الراهن.