#sxt $SXT @SpaceandTime لقد تعمقتُ مؤخرًا في مشروع سبيس آند تايم، وهناك أمرٌ فيه أثار اهتمامي فعلًا.
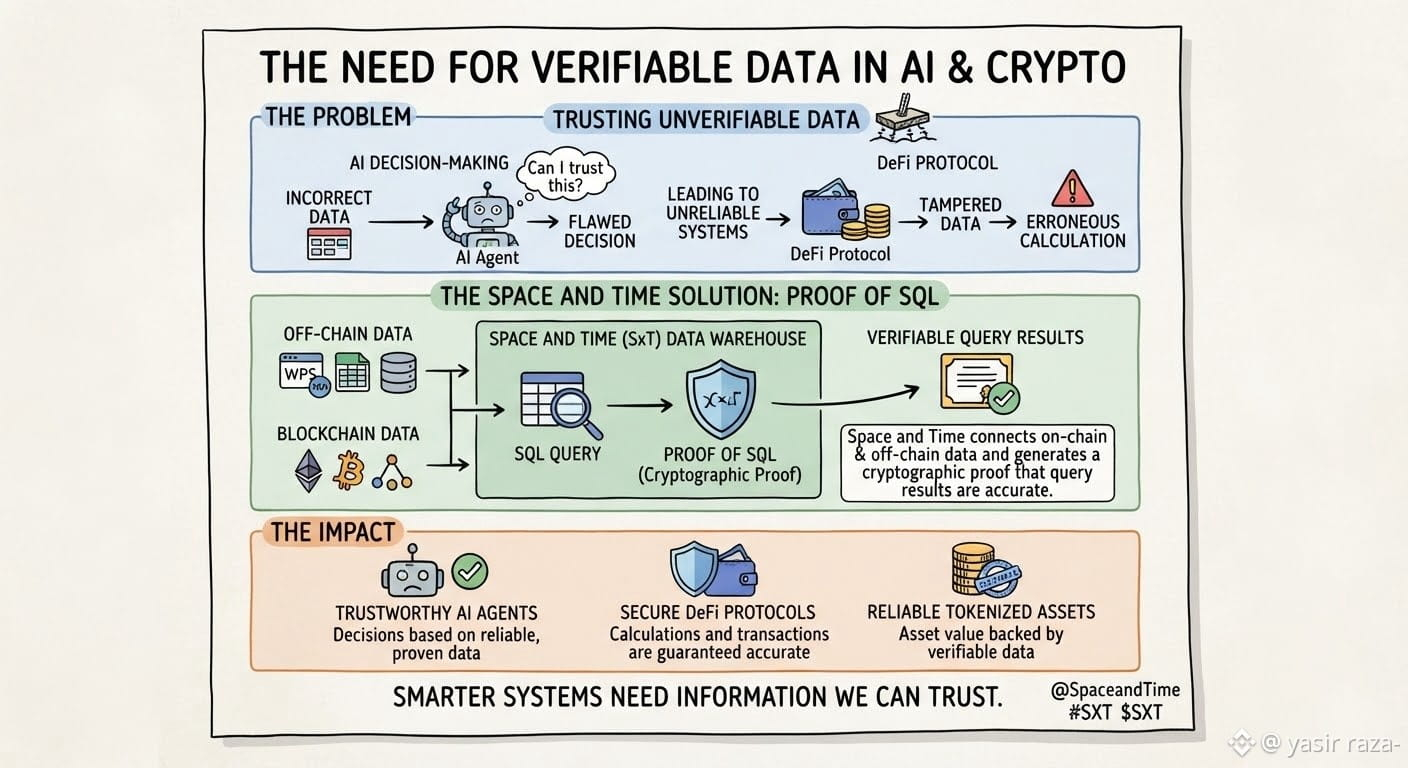
نتحدث كثيرًا عن مدى التطور الهائل للذكاء الاصطناعي، لكننا لا نتحدث بما يكفي عن البيانات التي يستخدمها. ماذا لو اتخذ وكيل ذكاء اصطناعي قرارًا بناءً على معلومات غير صحيحة؟ أو احتسب بروتوكول للتمويل اللامركزي شيئًا ما باستخدام بيانات جرى تغييرها؟
هذه مشكلة أكبر مما قد تبدو عليه.
يعمل مشروع سبيس آند تايم على معالجة ذلك من خلال تقنية Proof of SQL. فهي تتيح للمستخدمين التحقق من نتائج استعلامات قواعد البيانات باستخدام براهين تشفيرية، بدلًا من مجرد الثقة بأن المعلومات المُعادة صحيحة.
أجد هذا النهج مثيرًا للاهتمام على نحو خاص، لأنه يربط بيانات البلوك تشين بالمعلومات خارج السلسلة، مع إبقاء النتائج قابلة للتحقق.
وهناك إمكانات واعدة هنا لوكلاء الذكاء الاصطناعي وتطبيقات التمويل اللامركزي والأصول المُرمّزة.
لا أقول إن التبني سيحدث بين ليلة وضحاها. فما زال على المطورين بناء تطبيقات تستفيد منه، وسيكون الاستخدام الفعلي أهم من الوعود.
لكنني أعتقد أن البيانات الموثوقة تستحق اهتمامًا أكبر في النقاش حول الذكاء الاصطناعي.
ففي نهاية المطاف، لا تكون الأنظمة الأذكى مفيدة إلا إذا استطاعت التعامل مع معلومات يمكننا الوثوق بها حقًا.
ما رأيكم؟ هل ستصبح البيانات القابلة للتحقق ضرورة للذكاء الاصطناعي والعملات المشفرة؟
#SXT @SpaceandTime $SXT
نتحدث كثيرًا عن مدى التطور الهائل للذكاء الاصطناعي، لكننا لا نتحدث بما يكفي عن البيانات التي يستخدمها. ماذا لو اتخذ وكيل ذكاء اصطناعي قرارًا بناءً على معلومات غير صحيحة؟ أو احتسب بروتوكول للتمويل اللامركزي شيئًا ما باستخدام بيانات جرى تغييرها؟
هذه مشكلة أكبر مما قد تبدو عليه.
يعمل مشروع سبيس آند تايم على معالجة ذلك من خلال تقنية Proof of SQL. فهي تتيح للمستخدمين التحقق من نتائج استعلامات قواعد البيانات باستخدام براهين تشفيرية، بدلًا من مجرد الثقة بأن المعلومات المُعادة صحيحة.
أجد هذا النهج مثيرًا للاهتمام على نحو خاص، لأنه يربط بيانات البلوك تشين بالمعلومات خارج السلسلة، مع إبقاء النتائج قابلة للتحقق.
وهناك إمكانات واعدة هنا لوكلاء الذكاء الاصطناعي وتطبيقات التمويل اللامركزي والأصول المُرمّزة.
لا أقول إن التبني سيحدث بين ليلة وضحاها. فما زال على المطورين بناء تطبيقات تستفيد منه، وسيكون الاستخدام الفعلي أهم من الوعود.
لكنني أعتقد أن البيانات الموثوقة تستحق اهتمامًا أكبر في النقاش حول الذكاء الاصطناعي.
ففي نهاية المطاف، لا تكون الأنظمة الأذكى مفيدة إلا إذا استطاعت التعامل مع معلومات يمكننا الوثوق بها حقًا.
ما رأيكم؟ هل ستصبح البيانات القابلة للتحقق ضرورة للذكاء الاصطناعي والعملات المشفرة؟
#SXT @SpaceandTime $SXT