
لقد بدأتُ أتعمق أكثر في العلاقة بين الذكاء الاصطناعي وبيانات الشركات الخاصة، وأعتقد أن هناك مشكلة لا يناقشها الناس بما يكفي.
يمكن للذكاء الاصطناعي معالجة كميات هائلة من المعلومات، لكن عندما تكون هذه المعلومات ملكًا للبنوك أو الشركات أو المؤسسات المالية، تصبح مشاركتها صعبة. فلا أحد يريد كشف سجلات حساسة لمجرد الحصول على إجابة من نظام ذكاء اصطناعي.
وهنا أجد مشروع سبيس آند تايم مثيرًا للاهتمام.
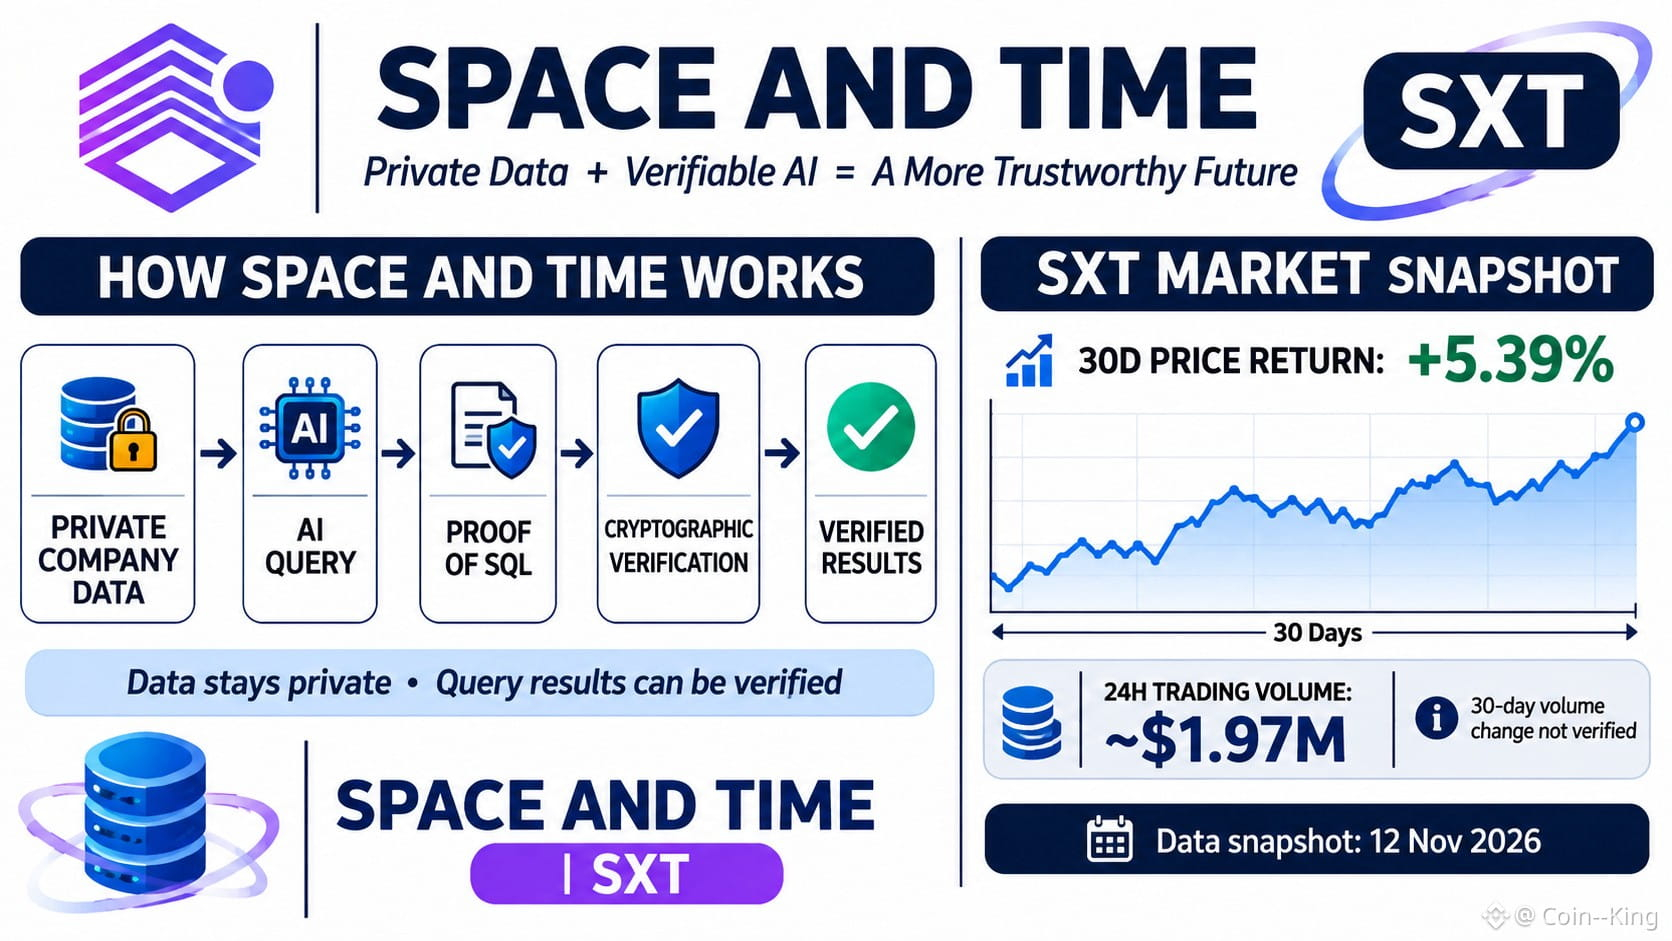
تتبع تقنيته «إثبات SQL» نهجًا مختلفًا. إذ يمكن للشركة الاحتفاظ ببياناتها خاصة، مع إنشاء إثباتات تشفيرية تُظهر أن استعلامات قاعدة بياناتها نُفذت على نحو صحيح. تخيّل الأمر كأنك تتحقق من إيصال من دون الحاجة إلى الاطلاع على صندوق المحاسبة بأكمله.
بالنسبة إليّ، لا تكمن القيمة الحقيقية في جعل الذكاء الاصطناعي أسرع فحسب، بل في تسهيل التحقق من النتائج من دون التنازل عن السيطرة على المعلومات الخاصة.
ومع ذلك، هناك أمور أتابعها عن كثب. فإنتاج الإثباتات لا يجعل البيانات المصدرية غير الصحيحة دقيقةً بطريقة سحرية. كما أن تكاليف الدمج، ومتطلبات المعالجة، والاستخدام الفعلي في الشركات ستحدد أيضًا إلى أي مدى يمكن أن يصل هذا الأمر.
ويحتاج SXT أيضًا إلى طلب مستمر نابع من أعباء عمل فعلية، لا إلى مجرد اهتمام بقصة الذكاء الاصطناعي.
يهمني أن أعرف رأي المجتمع في هذا الأمر: هل ستعطي الشركات الأولوية في نهاية المطاف لنتائج الذكاء الاصطناعي القابلة للتحقق، أم ستظل خصوصية البيانات أكبر مخاوفها؟
#sxt $SXT @SpaceandTime
يمكن للذكاء الاصطناعي معالجة كميات هائلة من المعلومات، لكن عندما تكون هذه المعلومات ملكًا للبنوك أو الشركات أو المؤسسات المالية، تصبح مشاركتها صعبة. فلا أحد يريد كشف سجلات حساسة لمجرد الحصول على إجابة من نظام ذكاء اصطناعي.
وهنا أجد مشروع سبيس آند تايم مثيرًا للاهتمام.
تتبع تقنيته «إثبات SQL» نهجًا مختلفًا. إذ يمكن للشركة الاحتفاظ ببياناتها خاصة، مع إنشاء إثباتات تشفيرية تُظهر أن استعلامات قاعدة بياناتها نُفذت على نحو صحيح. تخيّل الأمر كأنك تتحقق من إيصال من دون الحاجة إلى الاطلاع على صندوق المحاسبة بأكمله.
بالنسبة إليّ، لا تكمن القيمة الحقيقية في جعل الذكاء الاصطناعي أسرع فحسب، بل في تسهيل التحقق من النتائج من دون التنازل عن السيطرة على المعلومات الخاصة.
ومع ذلك، هناك أمور أتابعها عن كثب. فإنتاج الإثباتات لا يجعل البيانات المصدرية غير الصحيحة دقيقةً بطريقة سحرية. كما أن تكاليف الدمج، ومتطلبات المعالجة، والاستخدام الفعلي في الشركات ستحدد أيضًا إلى أي مدى يمكن أن يصل هذا الأمر.
ويحتاج SXT أيضًا إلى طلب مستمر نابع من أعباء عمل فعلية، لا إلى مجرد اهتمام بقصة الذكاء الاصطناعي.
يهمني أن أعرف رأي المجتمع في هذا الأمر: هل ستعطي الشركات الأولوية في نهاية المطاف لنتائج الذكاء الاصطناعي القابلة للتحقق، أم ستظل خصوصية البيانات أكبر مخاوفها؟
#sxt $SXT @SpaceandTime