#sxt $SXT @SpaceandTime
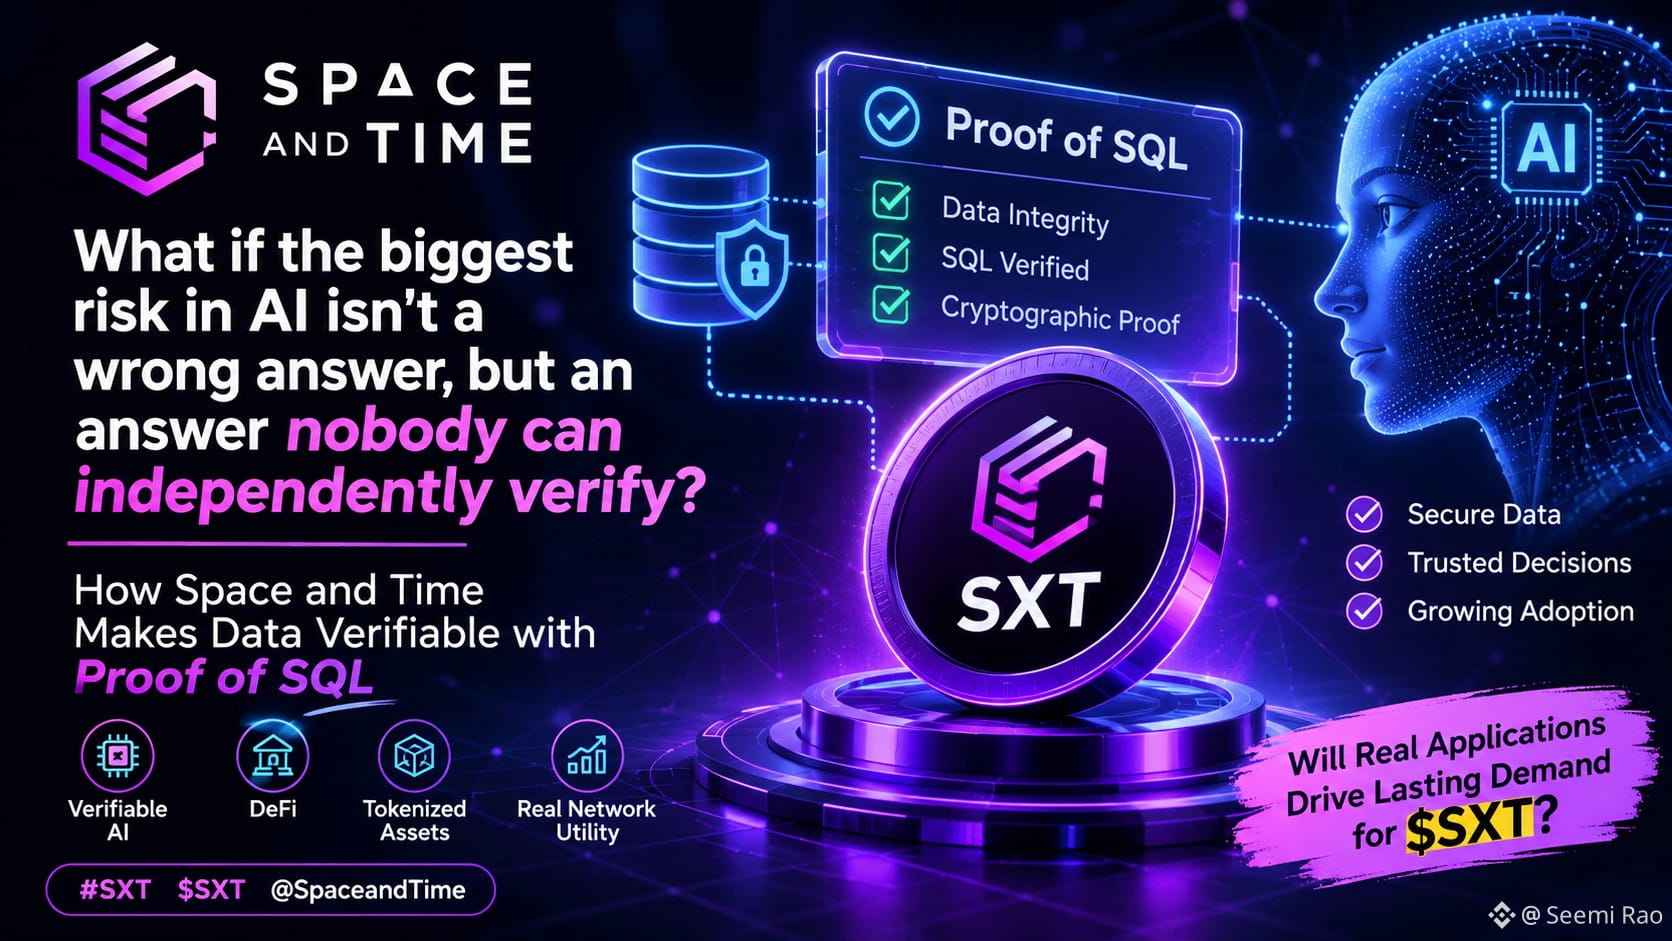
ماذا لو أن أكبر مشكلة في الذكاء الاصطناعي ليست أنه يعطي إجابات خاطئة… بل أن لا أحد يستطيع فعليًا التحقق من كيفية الوصول إلى تلك الإجابات؟
كنت أبحث مؤخرًا في Space and Time، وما يعملون عليه يتجاوز كثيرًا الحديث المعتاد عن الذكاء الاصطناعي والبلوك تشين.
تخيّل هذا: بروتوكول تمويل لامركزي يطلب من وكيل ذكاء اصطناعي حساب الضمانات اللازمة لقرض. يبدو الرقم مثاليًا. لكن كيف تعرف أن البيانات لم تتغير خفيةً، أو أن استعلام SQL نُفّذ كما ينبغي؟
هذا بالضبط ما صُمّم Proof of SQL من Space and Time لأجله.
يستخدمون التزامات تشفيرية على البيانات. ويثبّت المدقّقون هذه الالتزامات عبر إجماع لامركزي. ثم تنفّذ عُقد Prover استعلام SQL الفعلي وتُنشئ براهين عديمة المعرفة. يمكن لأي شخص التحقق من أن الاستعلام نُفّذ على البيانات الملتزم بها بشكل صحيح — من دون الاطلاع على السجلات الأصلية مطلقًا.
لكن ثمة نقطة مهمة: يمكن للبرهان تأكيد أن البيانات لم يتم العبث بها وأن الحساب أُجري على نحو صحيح. لكنه لا يستطيع إثبات أن البيانات الأصلية كانت صحيحة من الأساس بطريقة سحرية.
ومع ذلك، فهذه خطوة هائلة لوكلاء الذكاء الاصطناعي، والإقراض في التمويل اللامركزي، والأصول المُرمّزة، وكل ما يحتاج إلى أرقام موثوقة قبل اتخاذ قرارات فعلية.
والآن إلى الجزء الذي يتجاهله كثيرون: $SXT المنفعة.
وفقًا لنموذجهم الاقتصادي، فإن إدراج البيانات وفهرستها وتشغيل الاستعلامات القابلة للتحقق، كلها تستهلك موارد الشبكة — وتُدفع تكلفتها بعملة SXT. كما يودع المدقّقون عملة SXT للمساعدة في تأمين الشبكة.
لذا، فهذا هو السؤال الحقيقي بالنسبة إليّ:
يمكن للشراكات أن تجذب الانتباه، بالتأكيد. لكن هل ستواصل التطبيقات الفعلية استخدام الشبكة، وتوليد استعلامات قابلة للتحقق فعلًا، وإنشاء رسوم ثابتة على السلسلة؟
لأن الاستخدام المستمر، في نهاية المطاف، هو الدليل الحقيقي الوحيد على التبنّي.
#SXT $SXT @SpaceandTime
ماذا لو أن أكبر مشكلة في الذكاء الاصطناعي ليست أنه يعطي إجابات خاطئة… بل أن لا أحد يستطيع فعليًا التحقق من كيفية الوصول إلى تلك الإجابات؟
كنت أبحث مؤخرًا في Space and Time، وما يعملون عليه يتجاوز كثيرًا الحديث المعتاد عن الذكاء الاصطناعي والبلوك تشين.
تخيّل هذا: بروتوكول تمويل لامركزي يطلب من وكيل ذكاء اصطناعي حساب الضمانات اللازمة لقرض. يبدو الرقم مثاليًا. لكن كيف تعرف أن البيانات لم تتغير خفيةً، أو أن استعلام SQL نُفّذ كما ينبغي؟
هذا بالضبط ما صُمّم Proof of SQL من Space and Time لأجله.
يستخدمون التزامات تشفيرية على البيانات. ويثبّت المدقّقون هذه الالتزامات عبر إجماع لامركزي. ثم تنفّذ عُقد Prover استعلام SQL الفعلي وتُنشئ براهين عديمة المعرفة. يمكن لأي شخص التحقق من أن الاستعلام نُفّذ على البيانات الملتزم بها بشكل صحيح — من دون الاطلاع على السجلات الأصلية مطلقًا.
لكن ثمة نقطة مهمة: يمكن للبرهان تأكيد أن البيانات لم يتم العبث بها وأن الحساب أُجري على نحو صحيح. لكنه لا يستطيع إثبات أن البيانات الأصلية كانت صحيحة من الأساس بطريقة سحرية.
ومع ذلك، فهذه خطوة هائلة لوكلاء الذكاء الاصطناعي، والإقراض في التمويل اللامركزي، والأصول المُرمّزة، وكل ما يحتاج إلى أرقام موثوقة قبل اتخاذ قرارات فعلية.
والآن إلى الجزء الذي يتجاهله كثيرون: $SXT المنفعة.
وفقًا لنموذجهم الاقتصادي، فإن إدراج البيانات وفهرستها وتشغيل الاستعلامات القابلة للتحقق، كلها تستهلك موارد الشبكة — وتُدفع تكلفتها بعملة SXT. كما يودع المدقّقون عملة SXT للمساعدة في تأمين الشبكة.
لذا، فهذا هو السؤال الحقيقي بالنسبة إليّ:
يمكن للشراكات أن تجذب الانتباه، بالتأكيد. لكن هل ستواصل التطبيقات الفعلية استخدام الشبكة، وتوليد استعلامات قابلة للتحقق فعلًا، وإنشاء رسوم ثابتة على السلسلة؟
لأن الاستخدام المستمر، في نهاية المطاف، هو الدليل الحقيقي الوحيد على التبنّي.
#SXT $SXT @SpaceandTime