
يمكن للذكاء الاصطناعي تحليل البيانات، لكن هل يمكنه إثبات مصدرها؟
يزداد الذكاء الاصطناعي ذكاءً كل يوم. فهو قادر على تحليل المعلومات والتعرّف على الأنماط وتوليد الإجابات في ثوانٍ. لكن هناك أمرًا أعتقد أنه لا ينبغي لنا إغفاله: ما مدى موثوقية البيانات التي تستند إليها تلك الإجابات؟
قد ينتج نظام الذكاء الاصطناعي إجابة مقنعة للغاية، لكن الإقناع لا يعني دائمًا الصحة. فإذا كانت البيانات التي يعتمد عليها ناقصة أو قديمة أو غير دقيقة، فقد يؤدي التحليل إلى استنتاجات خاطئة.
وهنا تبرز أهمية Space and Time ($SXT ).
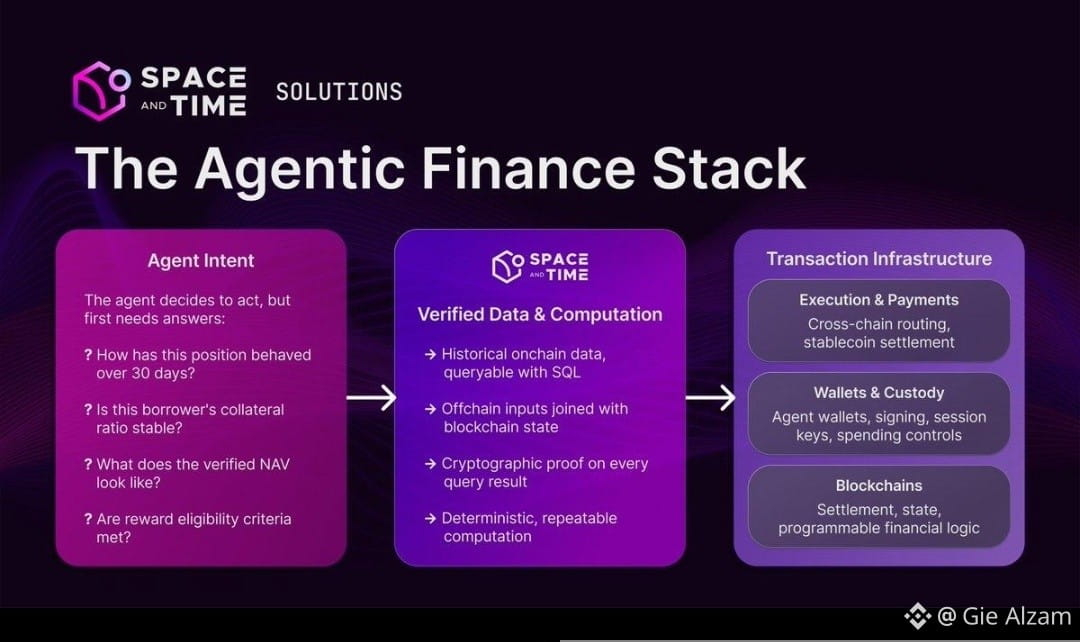
تعمل Space and Time على بناء بنية تحتية تربط بين البيانات على السلسلة وخارج السلسلة، ما يجعلها مفيدة للتطبيقات التي تحتاج إلى الوصول إلى كميات كبيرة من المعلومات.
ومن تقنياتها الأساسية Proof of SQL، التي تستخدم براهين المعرفة الصفرية للتحقق من تنفيذ استعلامات SQL بصورة صحيحة على بيانات موثّقة تشفيريًا.
لماذا يهم هذا الذكاء الاصطناعي؟
تخيّل تطبيقًا للذكاء الاصطناعي يحلل نشاط البلوك تشين أو السجلات المالية أو الأصول المرمّزة. فهو يحتاج إلى بيانات موثوقة لإنتاج رؤى قيّمة. وباستخدام Space and Time، يمكن للتطبيقات الاستعلام عن مجموعات بيانات مختلفة، وتوليد نتائج مرفقة ببراهين تشفيرية على إجراء العمليات الحسابية.
هذا لا يعني أن الذكاء الاصطناعي سيصبح فجأة خاليًا من الأخطاء. فإثبات تنفيذ استعلام بصورة صحيحة لا يضمن أن البيانات الأصلية صحيحة أو كاملة. ولا تزال مصادر البيانات بحاجة إلى أن تكون موثوقة.
وأعتقد أن هذا تمييز مهم.
لا يقتصر مستقبل الذكاء الاصطناعي على بناء نماذج أكبر أو جعلها تستجيب بسرعة أكبر. بل يتعلق أيضًا بجعل المعلومات التي تستند إليها قراراتها أكثر شفافية وقابلية للتحقق.
ولهذا تستحق Space and Time الاهتمام. ليس لأنها قادرة على حل كل مشكلات الذكاء الاصطناعي، بل لأن البيانات والعمليات الحسابية القابلة للتحقق يمكن أن تصبح جزءًا مهمًا من بناء تطبيقات ذكاء اصطناعي جديرة بالثقة.
#sxt $SXT @SpaceandTime
يزداد الذكاء الاصطناعي ذكاءً كل يوم. فهو قادر على تحليل المعلومات والتعرّف على الأنماط وتوليد الإجابات في ثوانٍ. لكن هناك أمرًا أعتقد أنه لا ينبغي لنا إغفاله: ما مدى موثوقية البيانات التي تستند إليها تلك الإجابات؟
قد ينتج نظام الذكاء الاصطناعي إجابة مقنعة للغاية، لكن الإقناع لا يعني دائمًا الصحة. فإذا كانت البيانات التي يعتمد عليها ناقصة أو قديمة أو غير دقيقة، فقد يؤدي التحليل إلى استنتاجات خاطئة.
وهنا تبرز أهمية Space and Time ($SXT ).
تعمل Space and Time على بناء بنية تحتية تربط بين البيانات على السلسلة وخارج السلسلة، ما يجعلها مفيدة للتطبيقات التي تحتاج إلى الوصول إلى كميات كبيرة من المعلومات.
ومن تقنياتها الأساسية Proof of SQL، التي تستخدم براهين المعرفة الصفرية للتحقق من تنفيذ استعلامات SQL بصورة صحيحة على بيانات موثّقة تشفيريًا.
لماذا يهم هذا الذكاء الاصطناعي؟
تخيّل تطبيقًا للذكاء الاصطناعي يحلل نشاط البلوك تشين أو السجلات المالية أو الأصول المرمّزة. فهو يحتاج إلى بيانات موثوقة لإنتاج رؤى قيّمة. وباستخدام Space and Time، يمكن للتطبيقات الاستعلام عن مجموعات بيانات مختلفة، وتوليد نتائج مرفقة ببراهين تشفيرية على إجراء العمليات الحسابية.
هذا لا يعني أن الذكاء الاصطناعي سيصبح فجأة خاليًا من الأخطاء. فإثبات تنفيذ استعلام بصورة صحيحة لا يضمن أن البيانات الأصلية صحيحة أو كاملة. ولا تزال مصادر البيانات بحاجة إلى أن تكون موثوقة.
وأعتقد أن هذا تمييز مهم.
لا يقتصر مستقبل الذكاء الاصطناعي على بناء نماذج أكبر أو جعلها تستجيب بسرعة أكبر. بل يتعلق أيضًا بجعل المعلومات التي تستند إليها قراراتها أكثر شفافية وقابلية للتحقق.
ولهذا تستحق Space and Time الاهتمام. ليس لأنها قادرة على حل كل مشكلات الذكاء الاصطناعي، بل لأن البيانات والعمليات الحسابية القابلة للتحقق يمكن أن تصبح جزءًا مهمًا من بناء تطبيقات ذكاء اصطناعي جديرة بالثقة.
#sxt $SXT @SpaceandTime