AI评测榜单这周大洗牌,洗得让人有点看不懂了。
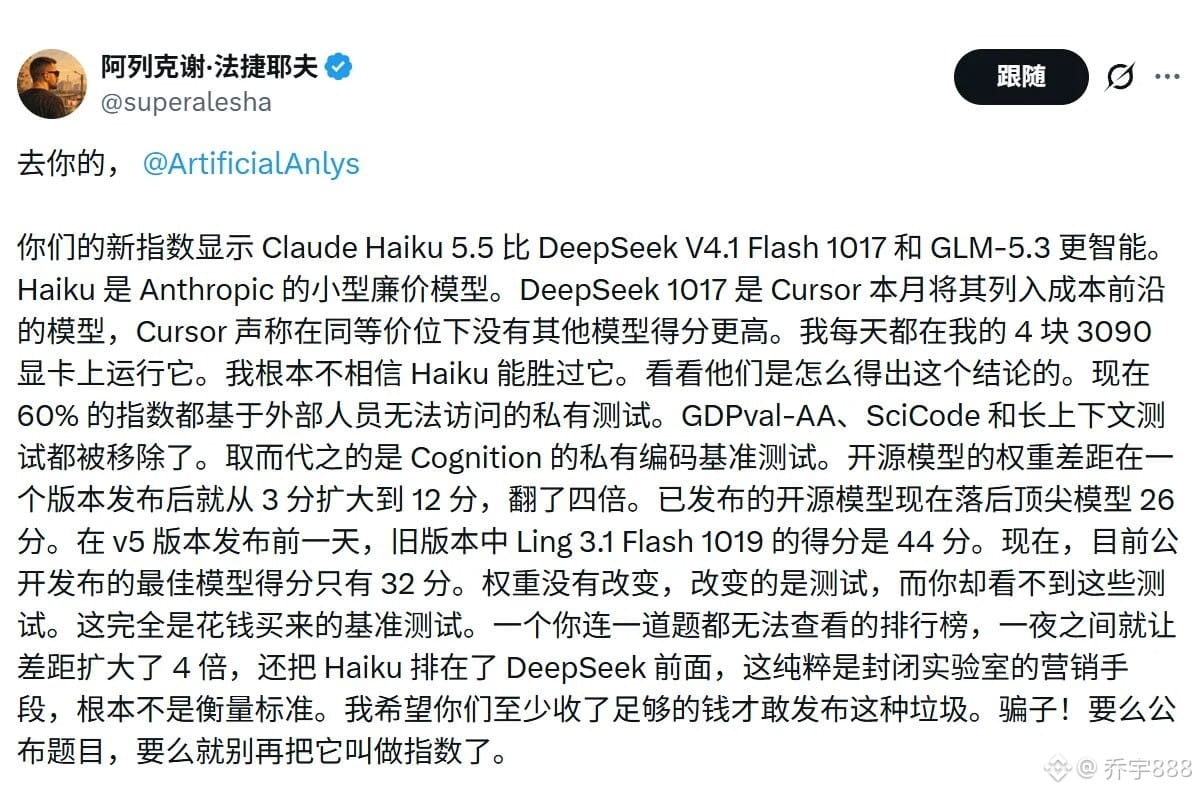
Artificial Analysis在10月23日还给Kimi K3.1 Pro打55分、排全球第四;10月27日V5榜单一更新,Kimi直接掉到46分,DeepSeek和GLM只剩32分,榜首变成了59分的Gemini 4 Carbon。
关键变化在算法:这次换了多个评测项目、重新分配权重,60%的权重落在私有测试集或隐藏答案上。也就是说,榜单上超过一半的分数,来自外界看不到、也没法独立复核的测试。
我的判断:榜单本来是帮开发者选模型的尺子,但尺子本身的刻度一改,量出来的结果就全变了。Kimi从55掉到46、DeepSeek掉到32,未必是模型变差了,更可能是新尺子量法变了。我倾向认为,看榜单要看它怎么算的,不能只看排名——尤其是60%分数来自黑盒测试的时候,这个榜单的参考价值要打个折。
#AI前沿
$BTC
Artificial Analysis在10月23日还给Kimi K3.1 Pro打55分、排全球第四;10月27日V5榜单一更新,Kimi直接掉到46分,DeepSeek和GLM只剩32分,榜首变成了59分的Gemini 4 Carbon。
关键变化在算法:这次换了多个评测项目、重新分配权重,60%的权重落在私有测试集或隐藏答案上。也就是说,榜单上超过一半的分数,来自外界看不到、也没法独立复核的测试。
我的判断:榜单本来是帮开发者选模型的尺子,但尺子本身的刻度一改,量出来的结果就全变了。Kimi从55掉到46、DeepSeek掉到32,未必是模型变差了,更可能是新尺子量法变了。我倾向认为,看榜单要看它怎么算的,不能只看排名——尤其是60%分数来自黑盒测试的时候,这个榜单的参考价值要打个折。
#AI前沿
$BTC